
机器学习与深度学习 / 系统课时
设计可归因的 A/B 测试
设计可归因的 A/B 测试
推荐系统的 A/B 测试只有在“谁被随机到哪组、实际暴露了什么、指标如何计算”都稳定时,增益才有归因意义。本课从互斥分桶、指标与样本量、SRM 检查到停止和回滚规则,搭出一套能在上线前写清、上线后复核的实验方案。
学习目标
- 设计稳定随机、互斥且可复现的实验分桶。
- 区分主指标、护栏指标,并估算最小样本量与实验周期。
- 用 SRM、污染检查和预设停止条件保护实验结论。
先锁定假设、随机单位和指标
先把假设写成可证伪句子,例如“新排序模型在不显著恶化 p99 延迟和负反馈率的前提下,提高首页有效点击率”。主指标只承担核心结论,护栏指标负责限制副作用;不要实验进行一半再更换指标口径。
随机单位通常选用户而不是请求。按请求随机会让同一用户反复看到不同策略,既污染体验,也破坏独立性。对于登录用户可使用稳定 user_id,跨设备或匿名场景则要明确身份合并规则,否则一个人可能同时进入两组。
同一推荐位置上会互相影响的实验应放在同一互斥层。一个用户在该层只能命中一个实验;真正独立的实验才放到其他层,并在方案中预先声明可能的交互效应。
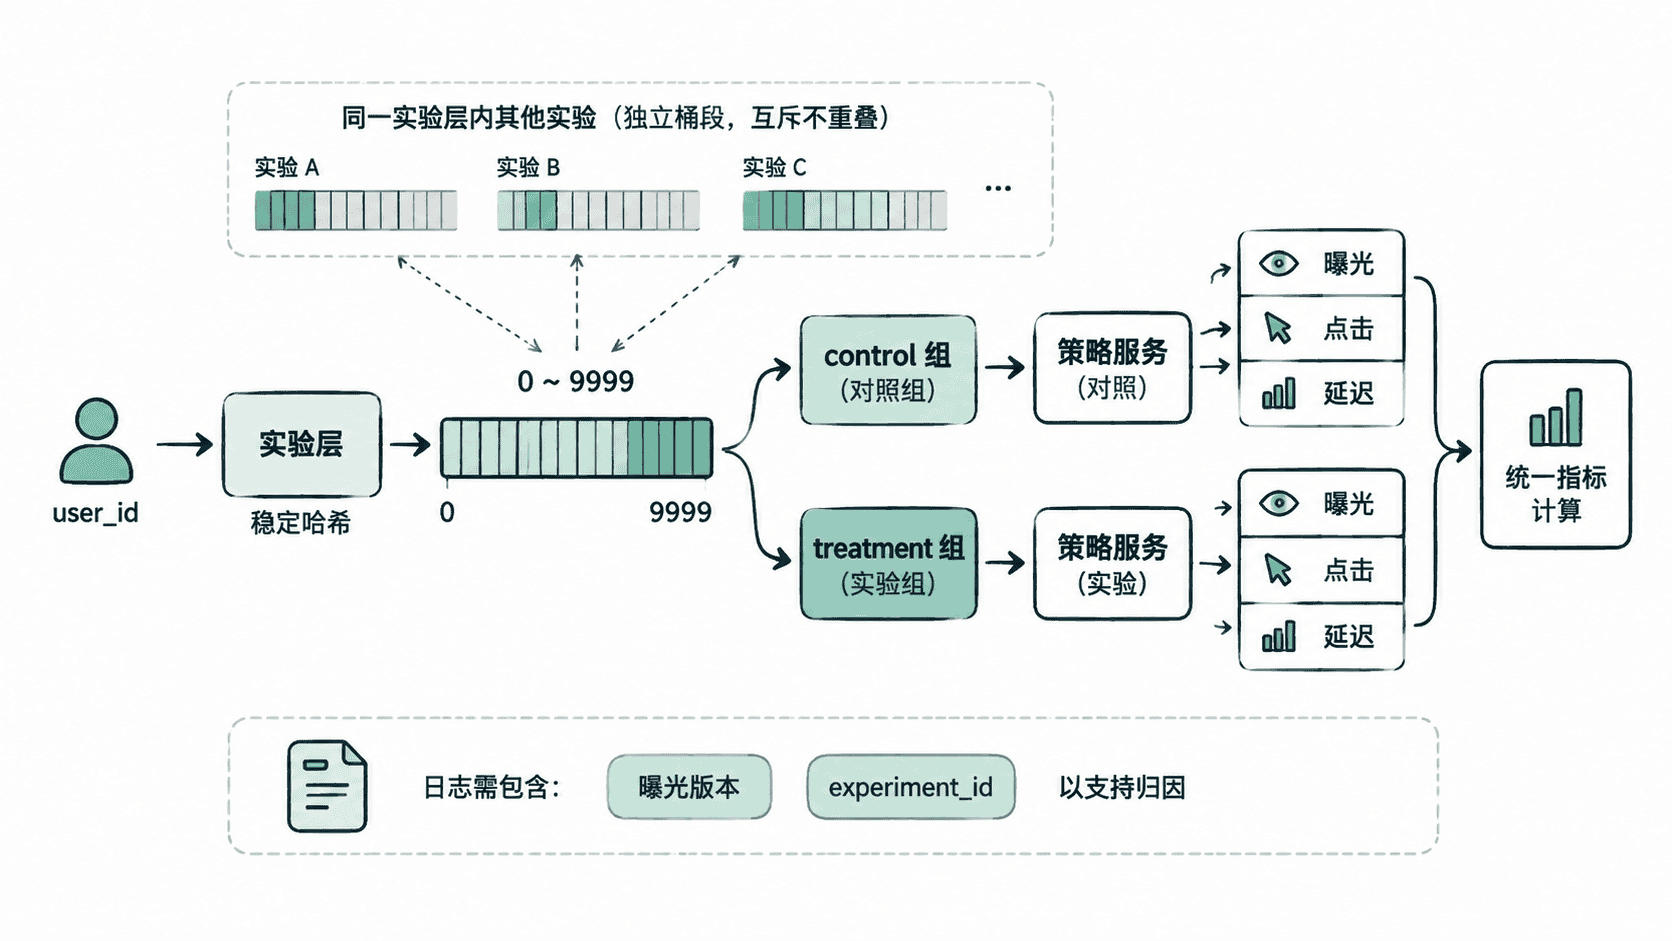
用稳定哈希建立可复现分桶
分桶函数必须满足同一用户长期稳定、不同实验可隔离、服务重启后结果不变。不要使用进程内随机数,也不要依赖会变化的列表顺序。常见做法是对 experiment_id:user_id 做稳定哈希,再映射到固定桶空间。
下面示例把一万个模拟用户按 50%/50% 分组,并用 Pearson 卡方统计量检查样本比例是否明显偏离预期。这里的 SRM 检查只验证分流比例,不判断业务指标是否显著。
import hashlib
import math

def bucket(user_id: str, experiment_id: str) -> int:
    digest = hashlib.sha256(f"{experiment_id}:{user_id}".encode()).hexdigest()
    return int(digest[:8], 16) % 10000

def assign(user_id: str) -> str:
    # 固定哈希保证同一用户跨请求、跨天保持同组。
    return "control" if bucket(user_id, "feed-ranker-v2") < 5000 else "treatment"

counts = {"control": 0, "treatment": 0}
for i in range(1, 10001):
    counts[assign(f"user-{i}")] += 1

expected = 5000
chi2 = sum((observed - expected) ** 2 / expected for observed in counts.values())
p_value = math.erfc(math.sqrt(chi2 / 2))

print(f"control={counts['control']}, treatment={counts['treatment']}")
print(f"srm_chi2={chi2:.4f}, p_value={p_value:.4f}")
print("srm=pass" if p_value >= 0.01 else "srm=fail")
预期输出:
control=4997, treatment=5003
srm_chi2=0.0036, p_value=0.9522
srm=pass
实际实验的用户数、分流比例和阈值可能不同。若要 90%/10% 灰度,只需改变桶区间,但分析端必须使用同一份实验配置作为期望比例来源,不能手工猜测。
先算最小样本量再决定周期
对于二项指标,可用基线比例、最小可检测差异 MDE、显著性水平和检验功效估算每组样本量。常用近似形式为:
其中 是基线比例, 是希望检测到的绝对变化。假设基线 CTR 为 10%,希望检测至少 0.5 个百分点的变化,双侧显著性水平 5%、功效 80%,近似需要每组约 5.6 万个独立用户;真实项目还应考虑无效曝光、流失和方差估计误差。
实验周期不能只按“样本够了”结束。推荐业务通常存在工作日与周末差异,应覆盖完整业务周期,并提前规定最短运行天数。频繁查看结果后在第一次显著时停止,会抬高假阳性;若必须连续监控,应采用专门的序贯检验方案。
用 SRM 和污染检查守住有效性
SRM 是 Sample Ratio Mismatch,即实际分组比例与配置比例显著不符。出现 SRM 时先暂停解释效果,依次检查分桶代码、实验配置同步、曝光日志丢失、客户端版本差异、机器人流量和资格过滤是否在分组之后发生。
还要检查“分到组”和“真正暴露”是否被混用。建议日志同时保存 experiment_id、group、release 或策略版本、assignment_time 和 exposure_time。主分析口径要在实验方案里预先规定,是按分配人群做 ITT 分析,还是按满足严格触发条件的曝光人群分析。
多重实验污染同样会破坏归因。若两个排序实验同时改同一候选集或同一分数,它们应互斥;若确实要研究交互作用,就显式设计多因子实验,而不是让两套独立分桶偶然叠加。
把停止条件和回滚动作写在上线前
正常停止条件应同时包含最小样本量、最短运行周期和预设统计判定。异常停止条件则针对安全性,例如错误率、超时率、投诉率或核心业务护栏超过阈值时立即停实验并回滚策略;SRM、日志缺失或版本串组属于实验完整性故障,修复后通常应重新开始有效观测窗口。
上线前还要确定谁有权停实验、回滚到哪个稳定版本、回滚后如何验证流量恢复,以及异常期间的数据是否从分析中剔除。这样得到的结论才能回答“这个策略导致了什么变化”,而不是仅仅描述“两组数据看起来不一样”。