
机器学习与深度学习 / 系统课时
用 FAISS 建近似近邻索引
用 FAISS 建近似近邻索引
这一课把物品向量真正变成可检索的召回索引:先用精确搜索建立基线,再切换到近似近邻索引,比较召回率、查询延迟与内存开销,最后用参数调优找到适合线上服务的平衡点。
学习目标
- 能用 FAISS 建立精确索引与近似近邻索引,并完成 TopK 检索
- 能用 Recall@K、延迟和索引大小评估不同配置
- 能解释
nlist、nprobe等参数怎样影响召回率与检索成本
先建立可比较的精确基线
向量召回的目标是:给定查询向量,在物品向量库中找出最相似的 TopK。若向量已做 L2 归一化,内积就等价于余弦相似度,因此可以使用 IndexFlatIP 做精确搜索。
精确索引会逐个比较候选向量,结果可作为“真值”基线。它不需要训练,召回率最高,但当物品规模从几十万增长到几百万甚至更高时,查询延迟会随候选数量线性上升。
下面用 5 万个 64 维向量构造一个可直接运行的对比实验。
import time
import numpy as np
import faiss

rng = np.random.default_rng(42)
dimension = 64
item_count = 50_000
query_count = 200
topk = 20

items = rng.normal(size=(item_count, dimension)).astype("float32")
queries = rng.normal(size=(query_count, dimension)).astype("float32")

# 归一化后,内积可作为余弦相似度使用。
faiss.normalize_L2(items)
faiss.normalize_L2(queries)

flat_index = faiss.IndexFlatIP(dimension)
flat_index.add(items)

start = time.perf_counter()
_, exact_ids = flat_index.search(queries, topk)
elapsed_ms = (time.perf_counter() - start) * 1000

print("ntotal:", flat_index.ntotal)
print("result shape:", exact_ids.shape)
print("avg latency ms:", round(elapsed_ms / query_count, 3))
预期输出
ntotal: 50000
result shape: (200, 20)
avg latency ms: <TIME>
<TIME> 会随 CPU、线程数和 FAISS 构建方式变化,但前两项应稳定。后续近似索引都与 exact_ids 比较,而不是凭延迟单独判断效果。
用 IVF 缩小搜索范围
IVF(Inverted File)先把向量空间划分为多个聚类单元,查询时只搜索最相关的一部分单元。这样能显著减少实际参与距离计算的向量数量,但可能漏掉落在其他单元中的真实近邻。
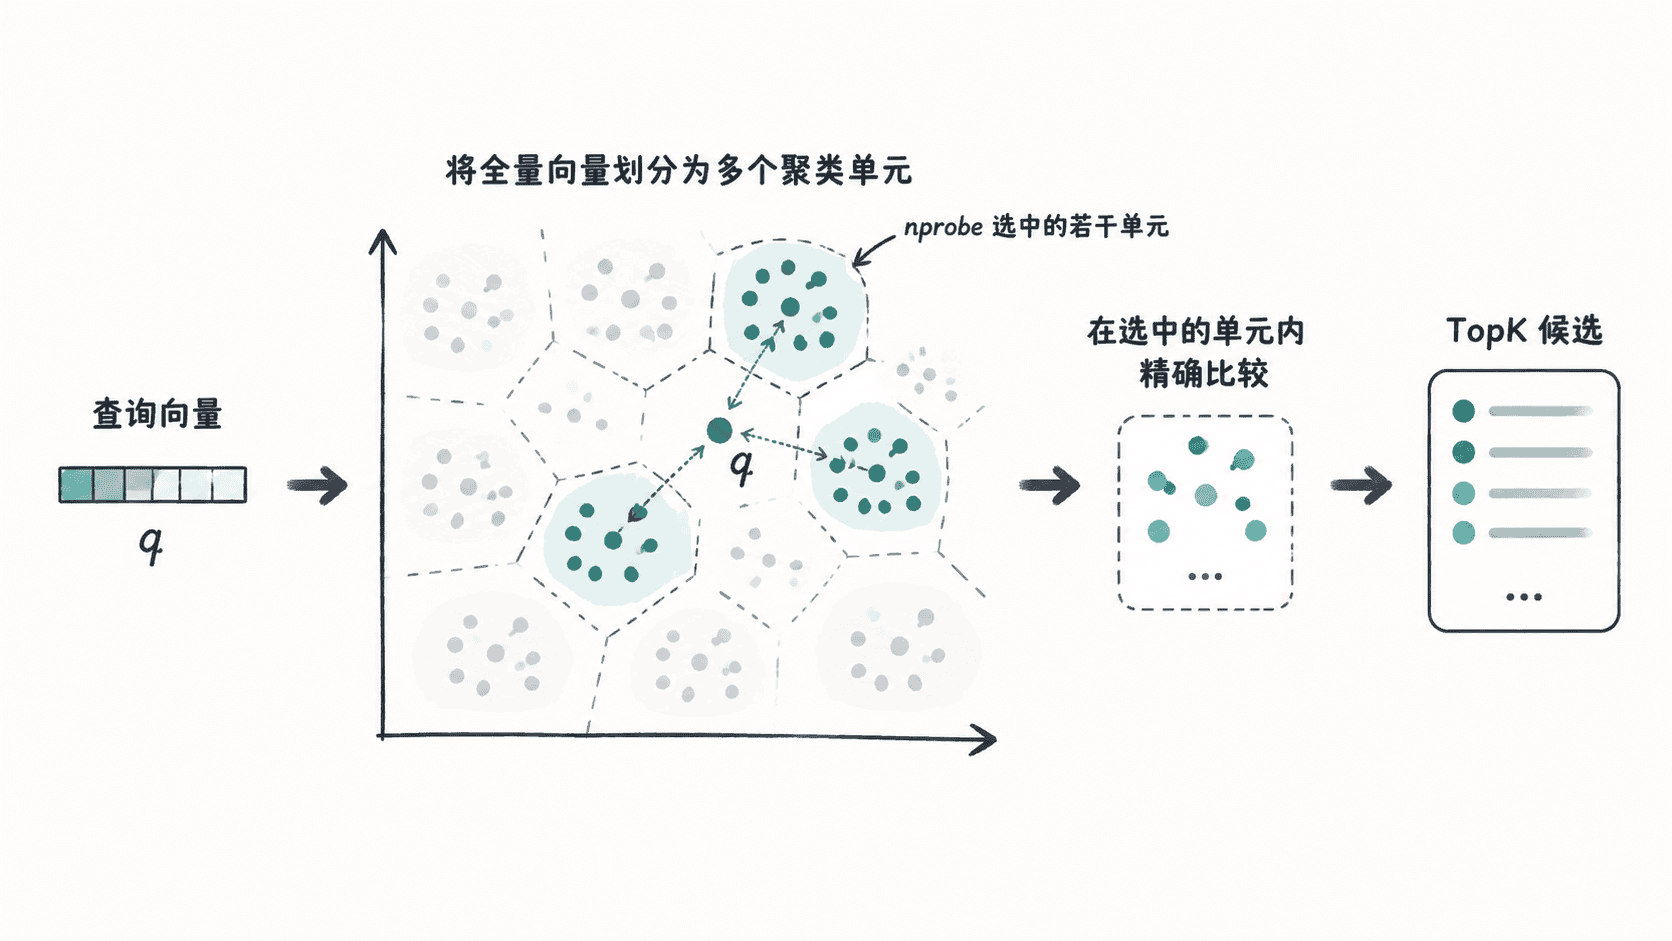
IVF 索引必须先训练聚类中心,再添加物品向量。nlist 决定聚类单元数量,nprobe 决定每次查询探测多少个单元。通常 nprobe 越大,召回率越高,但延迟也越高。
import time
import numpy as np
import faiss

rng = np.random.default_rng(42)
dimension = 64
item_count = 50_000
query_count = 200
topk = 20
nlist = 256
nprobe = 16

items = rng.normal(size=(item_count, dimension)).astype("float32")
queries = rng.normal(size=(query_count, dimension)).astype("float32")
faiss.normalize_L2(items)
faiss.normalize_L2(queries)

flat_index = faiss.IndexFlatIP(dimension)
flat_index.add(items)
_, exact_ids = flat_index.search(queries, topk)

quantizer = faiss.IndexFlatIP(dimension)
ivf_index = faiss.IndexIVFFlat(
    quantizer,
    dimension,
    nlist,
    faiss.METRIC_INNER_PRODUCT,
)
ivf_index.train(items)
ivf_index.add(items)
ivf_index.nprobe = nprobe

start = time.perf_counter()
_, approx_ids = ivf_index.search(queries, topk)
elapsed_ms = (time.perf_counter() - start) * 1000

hits = sum(
    len(set(exact_ids[i]) & set(approx_ids[i]))
    for i in range(query_count)
)
recall_at_k = hits / (query_count * topk)

print("trained:", ivf_index.is_trained)
print("ntotal:", ivf_index.ntotal)
print("recall@20:", round(recall_at_k, 4))
print("avg latency ms:", round(elapsed_ms / query_count, 3))
预期输出
trained: True
ntotal: 50000
recall@20: <VALUE>
avg latency ms: <TIME>
<VALUE> 与 <TIME> 都可能因数据分布和运行环境不同而变化。只要索引训练、添加和查询成功,实验就可以继续用于参数比较。
用统一指标比较配置
只看平均延迟容易掩盖问题。线上召回应同时观察三类指标:效果用 Recall@K,性能用 P50/P95/P99 延迟,资源用索引大小或进程内存。
Recall@K 可以写成:
其中精确索引返回的 TopK 作为参考集合。若有业务标注,也可以改为“真实点击物品是否进入候选集”这类离线召回指标。
下面的调参代码固定 nlist,逐步增大 nprobe,直接观察效果与延迟变化。
import time

for nprobe in [1, 4, 8, 16, 32, 64]:
    ivf_index.nprobe = nprobe
    start = time.perf_counter()
    _, ids = ivf_index.search(queries, topk)
    elapsed_ms = (time.perf_counter() - start) * 1000

    hits = sum(
        len(set(exact_ids[i]) & set(ids[i]))
        for i in range(query_count)
    )
    recall = hits / (query_count * topk)
    avg_ms = elapsed_ms / query_count

    print(
        f"nprobe={nprobe:>2} "
        f"recall@{topk}={recall:.4f} "
        f"avg_ms={avg_ms:.3f}"
    )
预期输出
nprobe= 1 recall@20=<VALUE> avg_ms=<TIME>
nprobe= 4 recall@20=<VALUE> avg_ms=<TIME>
nprobe= 8 recall@20=<VALUE> avg_ms=<TIME>
nprobe=16 recall@20=<VALUE> avg_ms=<TIME>
nprobe=32 recall@20=<VALUE> avg_ms=<TIME>
nprobe=64 recall@20=<VALUE> avg_ms=<TIME>
通常会看到 nprobe 增大时召回率上升,同时查询成本增加。不要把某个固定值当成“标准答案”,而应在自己的向量分布、硬件和目标 SLA 上找拐点。
索引参数怎么落到线上
nlist 过小,会让每个聚类包含太多向量,单次探测仍然昂贵;nlist 过大,则训练成本、中心查找成本和小数据集下的不稳定性都会上升。实际调参时,应先确定数据规模和延迟预算,再围绕 Recall@K 目标逐步扩大搜索范围。
如果物品库规模不大,IndexFlatIP 往往最简单可靠;规模上升且延迟开始不可接受时,再用 IVF、HNSW 或量化索引换取性能。最终选择不取决于“哪个索引更高级”,而取决于在业务召回率目标下,哪个配置能稳定满足线上延迟和资源预算。