
机器学习与深度学习 / 系统课时
构建用户物品与上下文特征
构建用户物品与上下文特征
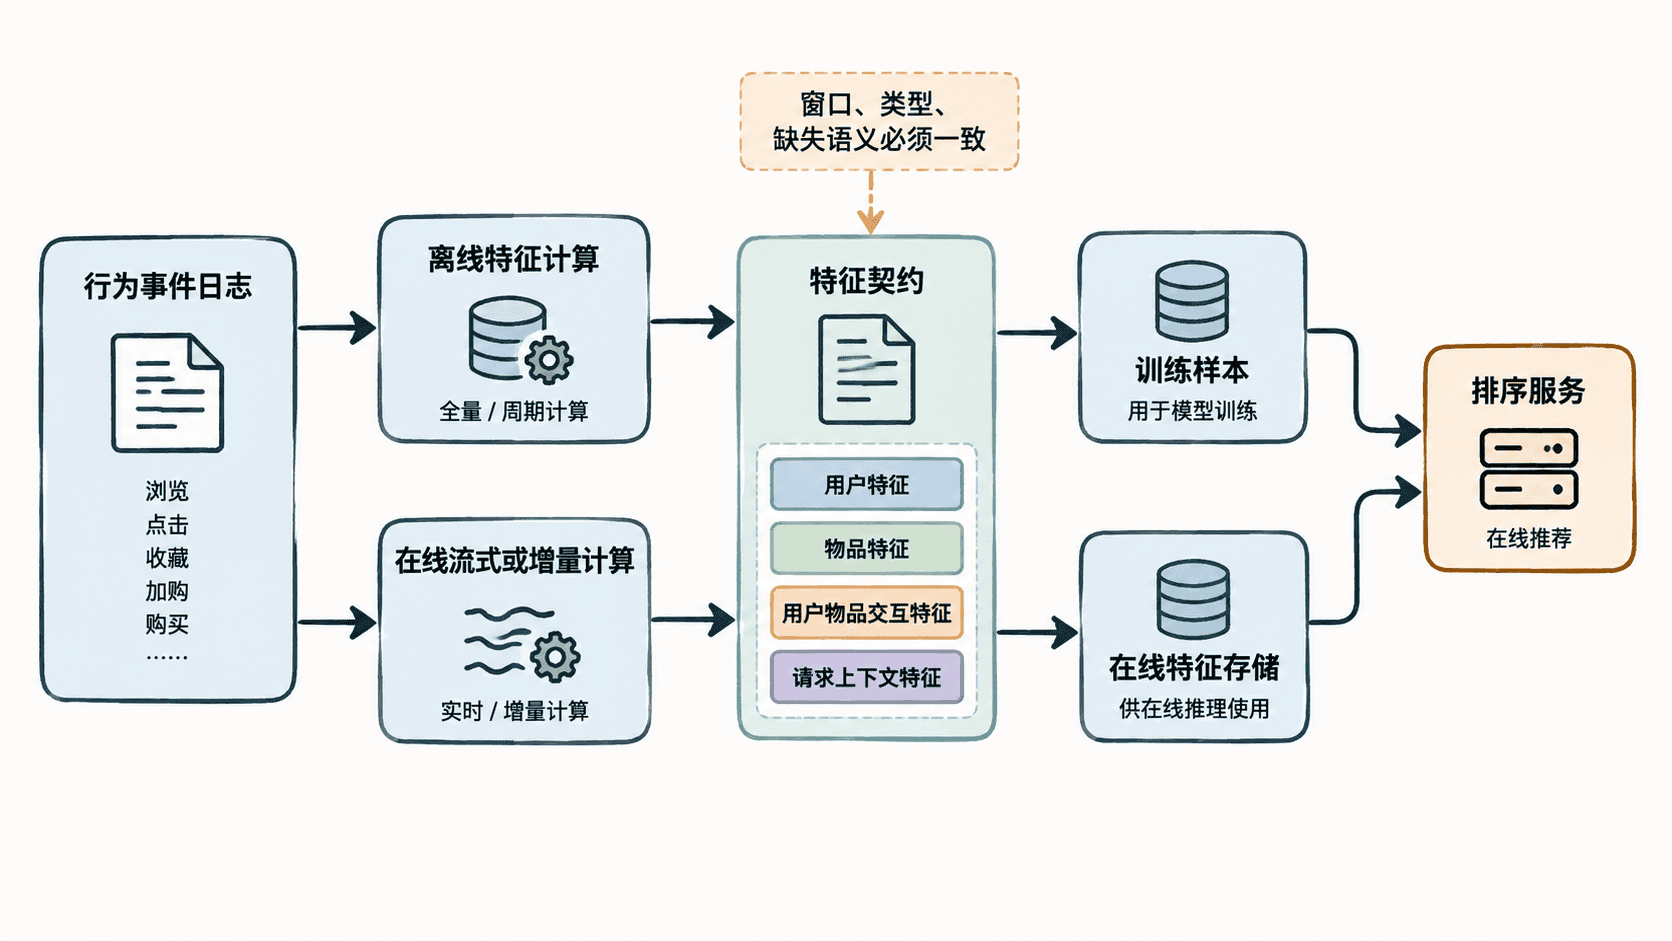
本节把推荐排序常用的用户、物品、交互与上下文信息落成一套可复现的特征契约,并用可运行示例完成窗口统计。最终你会得到明确的计算窗口、更新时间、数据类型和缺失值语义,使离线训练与在线读取不会因口径漂移而产生偏差。
学习目标
- 为用户活跃度、物品热度、交互统计和上下文特征定义统一口径
- 用固定事件时间窗口计算可复现的排序特征
- 为离线计算与在线读取约定一致的数据类型和缺失值语义
先把特征写成契约
推荐特征最容易出问题的地方不是“有没有这个字段”,而是同名字段在训练和线上含义不同。开始计算前,应先确定统计对象、窗口、刷新频率、类型和缺失语义。
| 特征 | 含义 | 窗口 | 建议更新 | 类型 | 缺失语义 |
|---|---|---|---|---|---|
user_click_7d |
用户近 7 天点击数 | 7 天 | 小时级或实时 | int64 |
已确认无行为时为 0 |
user_active_days_7d |
用户近 7 天有行为的自然日数 | 7 天 | 小时级 | int64 |
已确认无行为时为 0 |
item_click_24h |
物品近 24 小时点击数 | 24 小时 | 分钟级 | int64 |
已确认无点击时为 0 |
item_buy_7d |
物品近 7 天购买数 | 7 天 | 小时级 | int64 |
已确认无购买时为 0 |
ui_interact_7d |
当前用户与物品近 7 天交互数 | 7 天 | 分钟级或实时 | int64 |
已确认无交互时为 0 |
device_type |
本次请求设备类型 | 请求时刻 | 请求级 | string |
未识别时为 unknown |
hour_bucket |
本次请求所属时段 | 请求时刻 | 请求级 | string |
请求时间异常时为 unknown |
时间窗口必须基于事件时间而不是任务运行时间的模糊“最近几天”。离线训练还要以样本发生时刻作为截断点,否则会把未来行为计算进历史特征,形成数据泄漏。
用固定时间窗口计算特征
下面用标准库构造一组固定事件,统一以 2026-09-14T12:00:00+00:00 为统计截止时刻。这样每次运行结果都一致,也能清楚看到 24 小时和 7 天窗口的差别。
from collections import defaultdict
from datetime import datetime

events = [
    {"user_id": "u1", "item_id": "i1", "event": "click", "ts": "2026-09-14T08:00:00+00:00"},
    {"user_id": "u1", "item_id": "i1", "event": "buy", "ts": "2026-09-13T08:00:00+00:00"},
    {"user_id": "u1", "item_id": "i2", "event": "click", "ts": "2026-09-10T08:00:00+00:00"},
    {"user_id": "u2", "item_id": "i1", "event": "click", "ts": "2026-09-14T07:00:00+00:00"},
]

now = datetime.fromisoformat("2026-09-14T12:00:00+00:00")
user_click_7d = defaultdict(int)
user_days_7d = defaultdict(set)
item_click_24h = defaultdict(int)
item_buy_7d = defaultdict(int)
ui_interact_7d = defaultdict(int)

for event in events:
    ts = datetime.fromisoformat(event["ts"])
    age_seconds = (now - ts).total_seconds()

    # 7 天窗口统一负责用户、购买和用户-物品交互统计。
    if 0 <= age_seconds <= 7 * 86400:
        user_days_7d[event["user_id"]].add(ts.date().isoformat())
        ui_interact_7d[(event["user_id"], event["item_id"])] += 1
        if event["event"] == "click":
            user_click_7d[event["user_id"]] += 1
        if event["event"] == "buy":
            item_buy_7d[event["item_id"]] += 1

    # 物品短期热度使用更短的 24 小时窗口。
    if 0 <= age_seconds <= 86400 and event["event"] == "click":
        item_click_24h[event["item_id"]] += 1

request = {
    "user_id": "u1",
    "item_id": "i1",
    "device": "ios",
    "request_ts": "2026-09-14T12:30:00+00:00",
}
request_time = datetime.fromisoformat(request["request_ts"])
hour = request_time.hour
hour_bucket = (
    "night" if hour < 6
    else "morning" if hour < 12
    else "afternoon" if hour < 18
    else "evening"
)

features = {
    "user_click_7d": user_click_7d[request["user_id"]],
    "user_active_days_7d": len(user_days_7d[request["user_id"]]),
    "item_click_24h": item_click_24h[request["item_id"]],
    "item_buy_7d": item_buy_7d[request["item_id"]],
    "ui_interact_7d": ui_interact_7d[(request["user_id"], request["item_id"])],
    "device_type": request["device"],
    "hour_bucket": hour_bucket,
}

print(features)
预期输出:
{'user_click_7d': 2, 'user_active_days_7d': 3, 'item_click_24h': 2, 'item_buy_7d': 1, 'ui_interact_7d': 2, 'device_type': 'ios', 'hour_bucket': 'afternoon'}这个结果同时包含长期一些的 7 天兴趣、短期 24 小时热度、用户与物品的交叉历史,以及请求发生时才能知道的上下文。实际系统中可以继续扩展品类偏好、价格带、地域等特征,但必须沿用同样的契约方式。
区分“没有行为”和“数据缺失”
数值 0 只应该表示“数据完整,而且窗口内确实没有行为”。如果特征存储超时、日志延迟或新字段尚未回填,直接填 0 会把系统故障伪装成真实用户信号。
更稳妥的做法是保留可空原始值,并增加可用性标记,例如 item_click_24h=None 与 item_click_24h_available=False。进入模型前再按训练时相同的规则填充数值;类别字段则统一映射到 unknown,不要在线上临时创造训练集里不存在的类别。
保证离线计算和在线读取一致
离线与在线一致性至少要锁定四件事:同一字段定义、同一时间边界、同一数据类型、同一缺失策略。最实用的工程做法是让两边都消费版本化的特征契约,而不是分别在 SQL、流任务和服务代码里手写一遍含义。
上线前可以抽取一批固定的 user_id、item_id 和请求时刻,分别从离线回放与在线服务读取特征,再逐字段比较。允许存在的差异只能来自已经定义的刷新延迟;如果数值差异无法由延迟解释,就应先修正口径,再训练或发布模型。
当每个特征都能回答“从哪里来、统计多长、什么时候更新、缺失代表什么、线上是什么类型”,特征工程才真正具备可训练、可复现和可服务的基础。