
机器学习与深度学习 / 系统课时
用 NDCG 衡量排序位置价值
用 NDCG 衡量排序位置价值
NDCG 解决的是“命中的东西排得够不够靠前”。它同时考虑相关性等级与位置折扣:高相关物品越早出现,得分越高。本节会从 DCG、IDCG 到 NDCG 完整算一遍,并用代码核对实际 TopK 顺序,避免实现和线上列表顺序脱节。
学习目标
- 能手算 DCG、IDCG 与 NDCG@K,理解位置折扣的含义
- 能处理 0、1、2、3 等多级相关性标签,而不是只看二值命中
- 能用代码验证 NDCG 实现与实际 TopK 列表顺序完全一致
NDCG 在衡量什么
Precision@K 只关心前 K 个结果里有多少命中,却不区分“第 1 位命中”和“第 10 位命中”。排序系统通常更在意前排,因此需要让位置越靠后的收益逐步衰减。
常用 DCG 定义为:
其中 是第 个位置的相关性等级。分子让高等级相关性的收益增长更快,分母则给靠后位置施加折扣。第 1 位分母为 1,之后位置的贡献逐步减小。
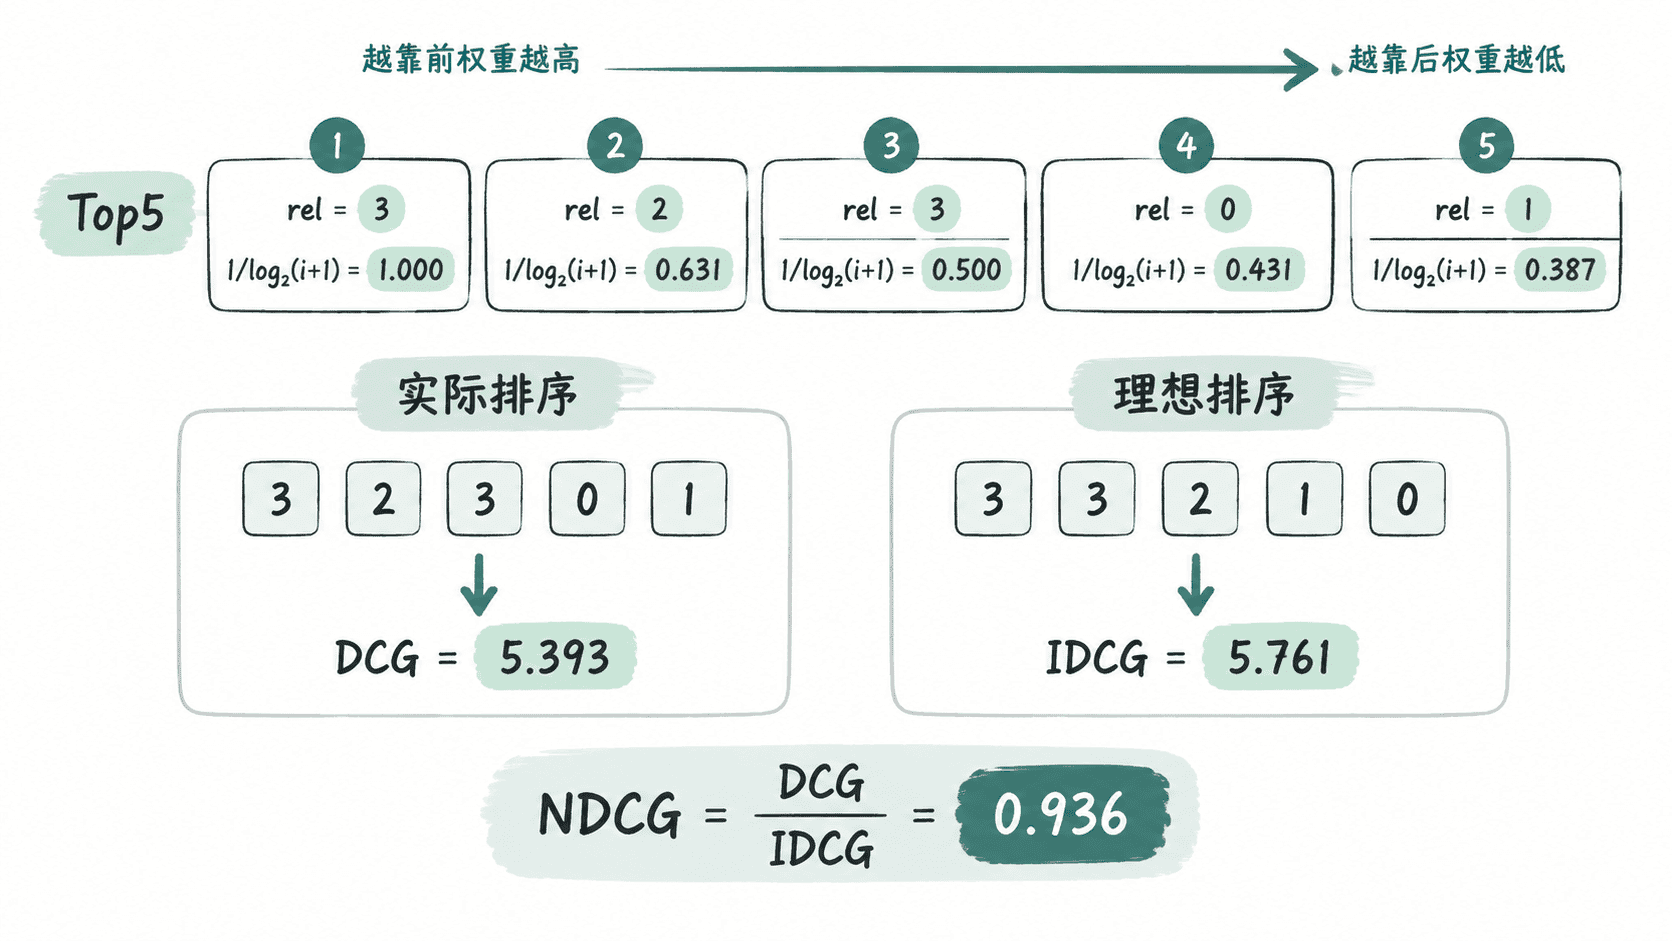
从 DCG 到 NDCG
仅看 DCG 不能直接比较不同用户,因为有的用户本来就有很多高相关物品,有的用户只有少量弱相关物品。NDCG 通过“理想排序”做归一化。
对同一个评估候选集,把全部候选的相关性标签从高到低排列,取前 K 个计算 。然后:
例如某用户实际 Top5 的相关性为 [3, 2, 0, 1, 0],同一候选集的理想 Top5 是 [3, 2, 1, 0, 0]。实际排序已经把最相关的两个物品放在前面,但第 4 位的相关物品本可以提升到第 3 位,因此 NDCG 会低于 1。
用 Python 核对实现
下面的可运行示例同时计算 DCG、IDCG 和 NDCG。关键点是:ranked_relevances 必须保持模型实际输出的 TopK 顺序,而 candidate_relevances 用于构造理想排序,二者职责不能混淆。
import math

def dcg_at_k(relevances, k):
    score = 0.0
    for rank, rel in enumerate(relevances[:k], start=1):
        gain = (2 ** rel) - 1
        discount = math.log2(rank + 1)
        score += gain / discount
    return score

def ndcg_at_k(ranked_relevances, candidate_relevances, k):
    actual = dcg_at_k(ranked_relevances, k)
    ideal_order = sorted(candidate_relevances, reverse=True)
    ideal = dcg_at_k(ideal_order, k)
    return 0.0 if ideal == 0 else actual / ideal

actual_top5 = [3, 2, 0, 1, 0]
candidate_labels = [3, 2, 1, 0, 0]

print(f"DCG@5={dcg_at_k(actual_top5, 5):.4f}")
print(f"IDCG@5={dcg_at_k(sorted(candidate_labels, reverse=True), 5):.4f}")
print(f"NDCG@5={ndcg_at_k(actual_top5, candidate_labels, 5):.4f}")
预期输出:
DCG@5=9.3235
IDCG@5=9.3928
NDCG@5=0.9926
不同库可能采用另一种增益公式,例如直接使用 而不是 。一旦团队确定公式,就要在离线评估、实验平台和报表中保持一致。
比较模型时看前排质量
假设模型 A 的 Top5 标签是 [3, 2, 0, 1, 0],模型 B 是 [2, 3, 1, 0, 0]。两者包含的相关物品数量相同,但 A 把最高相关物品放在第 1 位,因此通常会有更高的 NDCG。
NDCG 特别适合评价搜索、推荐和信息流中的前排排序质量,也适合多级标签,例如“无点击=0、点击=1、收藏=2、购买=3”。标签等级越能代表真实业务价值,NDCG 越有解释力。
上线前应抽取若干真实请求,保存“模型实际 TopK 物品顺序”和同一候选集的相关性标签,再逐条喂给离线函数。只要 DCG 消费的顺序与线上展示顺序一致,IDCG 又基于同一候选集的理想排序,NDCG 才真正反映用户看到的前排质量。