
机器学习与深度学习 / 系统课时
评估覆盖率多样性与新颖度
评估覆盖率多样性与新颖度
只优化点击或 NDCG,模型可能越来越偏向少数热门物品:整体命中率不错,但长尾被挤掉,推荐列表彼此相似,新用户群体也可能持续看到同一批内容。本节用覆盖率、列表内多样性和新颖度补齐这三个盲区,并按用户群体检查体验是否分化。
学习目标
- 能计算物品覆盖率、列表内多样性和平均新颖度
- 能判断“更准但更窄”的模型是否正在压缩长尾与探索空间
- 能按用户群体拆分指标,识别总体均值掩盖的体验分化
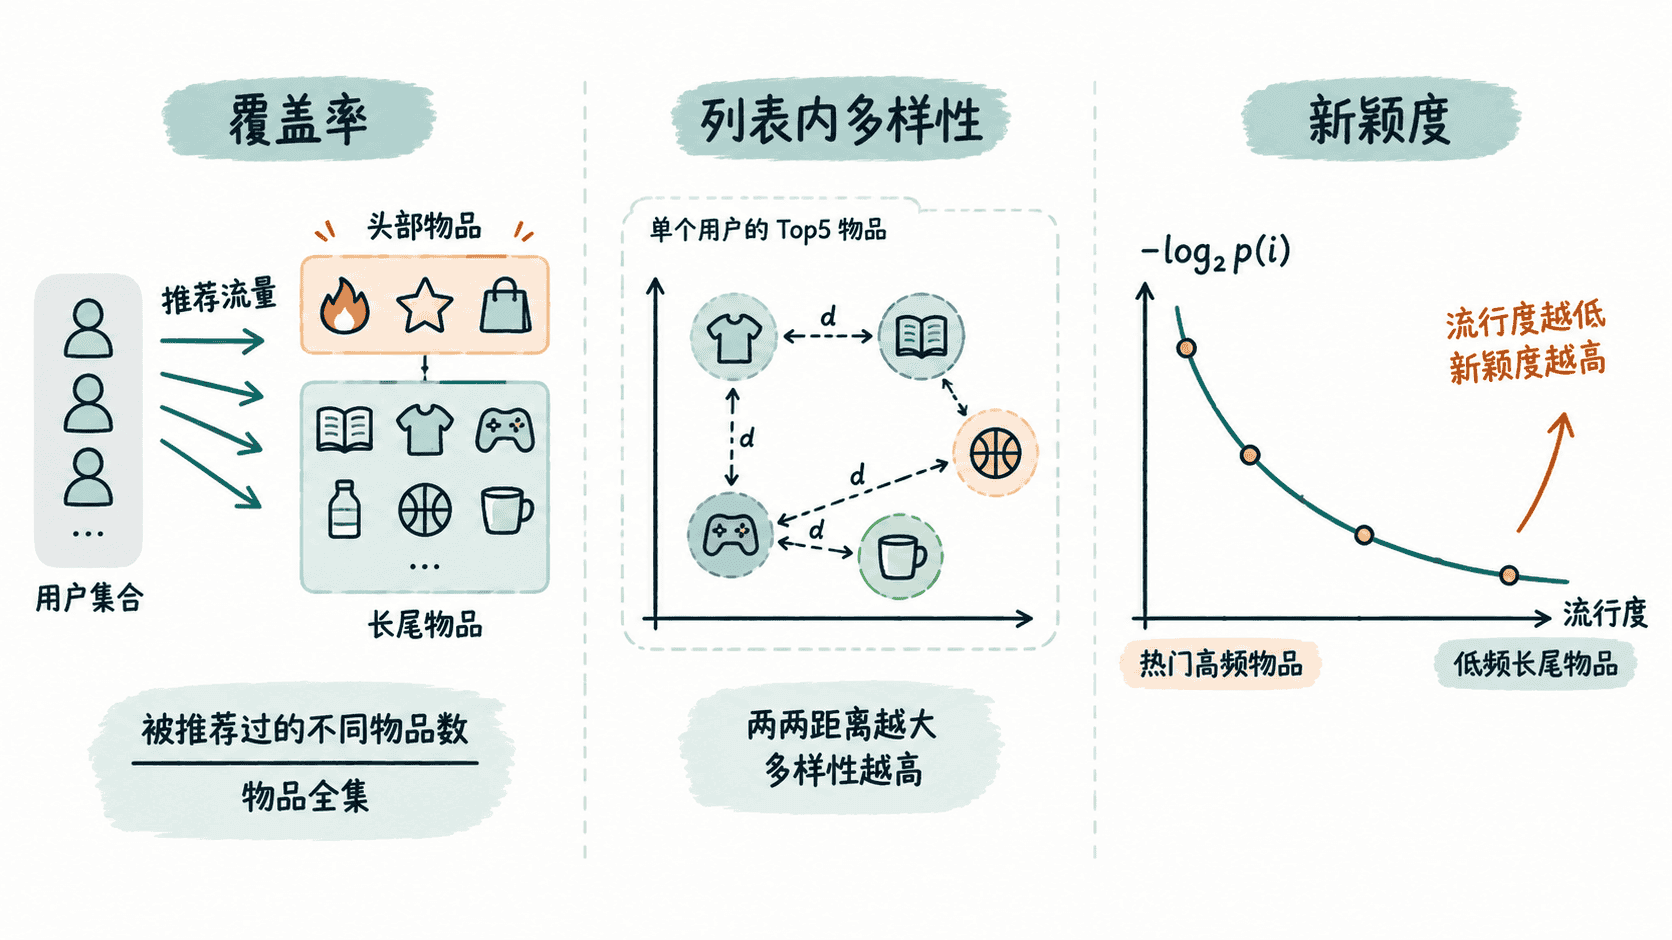
三个指标分别补什么盲区
覆盖率回答“系统到底推荐到了多少不同物品”。最常见的物品覆盖率是:
其中 是评估窗口内至少被推荐过一次的物品集合, 是可推荐物品全集。覆盖率低通常意味着流量集中在热门头部。
列表内多样性关注同一个用户的一组推荐是否彼此相似。若已有物品向量,可使用平均两两余弦距离:
新颖度则衡量物品对用户而言是否“常见”。一个常用做法是根据物品流行度定义自信息:
越少被交互的物品, 越小,新颖度越高。
一个最小可运行计算
下面构造 3 个用户的 Top3 推荐、6 个可推荐物品及物品向量,计算三个指标。示例故意保持数据很小,方便你手工复核每一步。
import math
from itertools import combinations

recommendations = {
    "u1": ["a", "b", "c"],
    "u2": ["a", "b", "d"],
    "u3": ["a", "e", "f"],
}

all_items = {"a", "b", "c", "d", "e", "f"}

vectors = {
    "a": (1.0, 0.0),
    "b": (0.9, 0.1),
    "c": (0.0, 1.0),
    "d": (0.1, 0.9),
    "e": (-1.0, 0.0),
    "f": (0.0, -1.0),
}

popularity = {
    "a": 0.50,
    "b": 0.20,
    "c": 0.10,
    "d": 0.08,
    "e": 0.07,
    "f": 0.05,
}

def cosine_similarity(x, y):
    dot = x[0] * y[0] + x[1] * y[1]
    nx = math.sqrt(x[0] ** 2 + x[1] ** 2)
    ny = math.sqrt(y[0] ** 2 + y[1] ** 2)
    return dot / (nx * ny)

recommended_items = {
    item for items in recommendations.values() for item in items
}
coverage = len(recommended_items) / len(all_items)

ild_values = []
novelty_values = []

for items in recommendations.values():
    distances = []
    for left, right in combinations(items, 2):
        sim = cosine_similarity(vectors[left], vectors[right])
        distances.append(1 - sim)
    ild_values.append(sum(distances) / len(distances))

    user_novelty = [
        -math.log2(popularity[item]) for item in items
    ]
    novelty_values.append(sum(user_novelty) / len(user_novelty))

print(f"coverage={coverage:.3f}")
print(f"avg_ild={sum(ild_values) / len(ild_values):.3f}")
print(f"avg_novelty={sum(novelty_values) / len(novelty_values):.3f}")
预期输出:
coverage=1.000
avg_ild=0.841
avg_novelty=2.530
覆盖率为 1 只说明 6 个物品在整个评估窗口都至少出现过,不代表每个用户的列表都足够丰富;因此三个指标必须联合看,而不是互相替代。
不要只看总体平均值
总体均值可能掩盖用户群体之间的差异。例如新用户因为画像弱,被不断回退到热门榜;老用户因为行为丰富,能获得更长尾的个性化结果。两组混在一起时,平均覆盖率或平均新颖度可能看起来正常。
实际评估时至少按业务最关键的人群拆一层,例如新用户/老用户、高活跃/低活跃或不同内容偏好群体。对每组分别计算 Precision、NDCG、ILD 和新颖度,再观察是否存在“总体提升、某组显著下降”。
解释指标之间的权衡
更高的覆盖率、多样性和新颖度并不天然更好。强行提高新颖度可能把大量低质量长尾推给用户;过度追求多样性,也可能损伤主题一致性。正确做法是先确定相关性底线,再观察体验指标是否改善。
如果新模型 NDCG 小幅上升,但物品覆盖率大幅下降、ILD 明显下降,同时新用户的新颖度也下降,就说明模型可能在“更会推荐热门内容”,而不是整体更懂用户。这样的结果至少应进入进一步实验,而不是只凭点击命中直接上线。
离线评估最终要回答的不是“哪个指标最高”,而是“相关性提升是否伴随可接受的覆盖、多样性和新颖度变化,并且不同用户群体都没有出现不可接受的退化”。