
机器学习与深度学习 / 系统课时
给新用户设计冷启动策略
给新用户设计冷启动策略
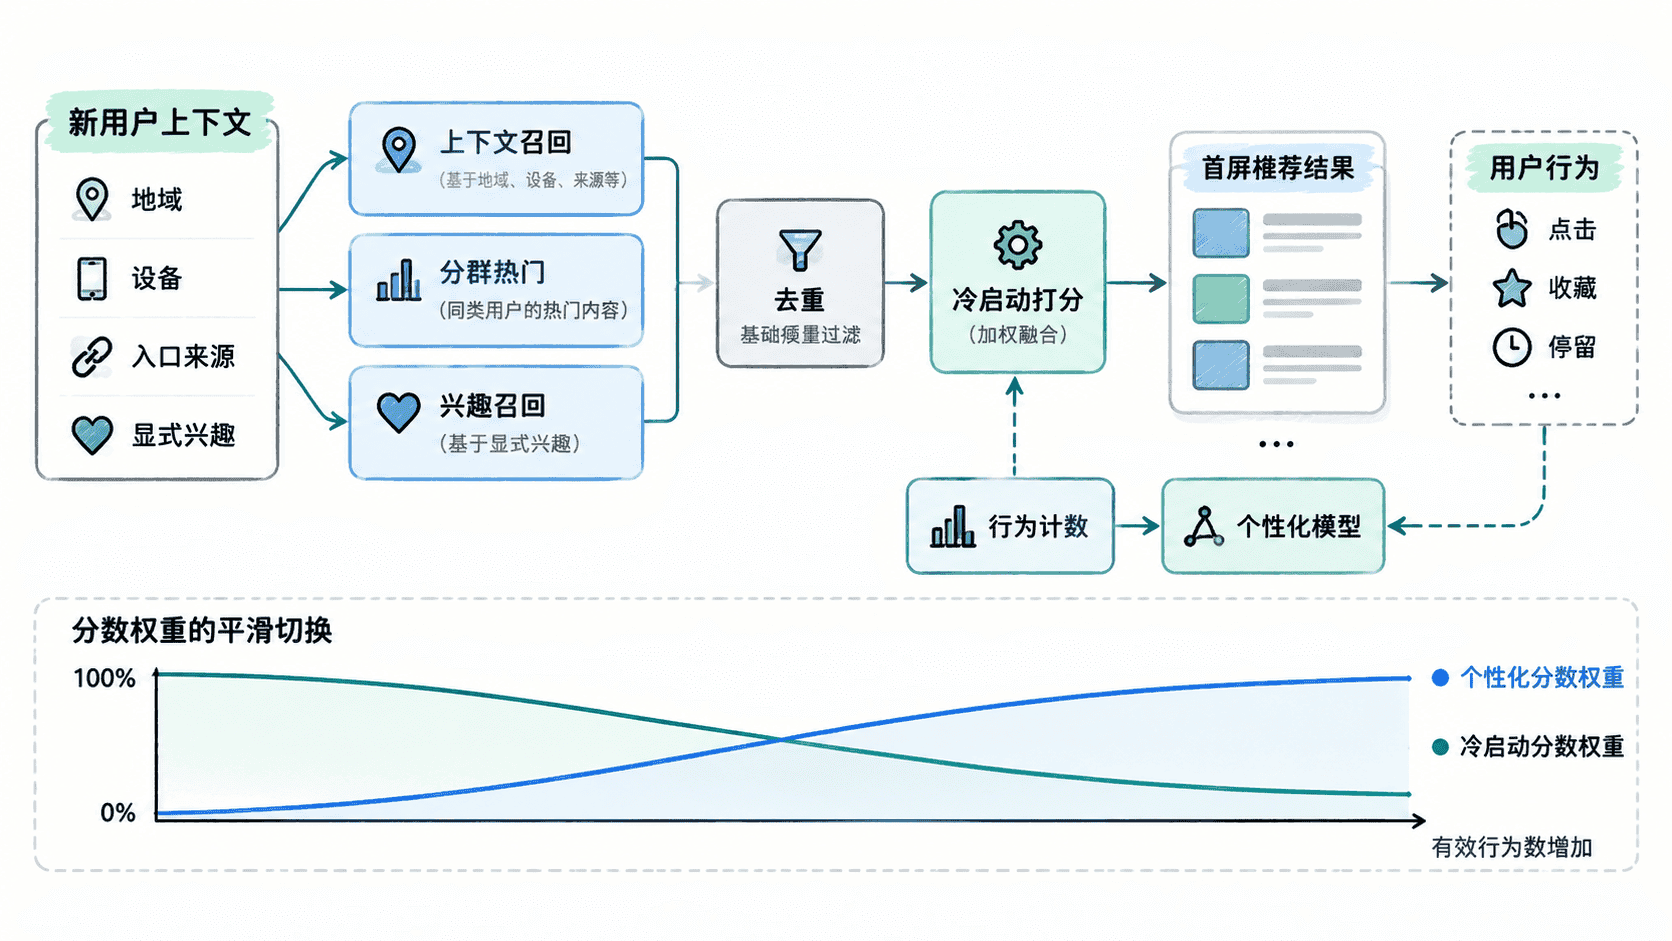
新用户没有历史点击、收藏和转化数据,首屏推荐不能直接依赖个性化模型。本节用地域、设备、入口上下文、分群热门和显式兴趣拼出一个可运行的冷启动排序,并设计行为积累后的平滑切换条件,避免所有新人看到同一份热门榜。
学习目标
- 能把弱上下文和显式兴趣组合成新用户首屏候选分数
- 能设置冷启动到个性化模型的平滑切换条件
- 能用去同质化约束避免新人流量被单一热门列表占满
冷启动先解决什么
新用户冷启动的目标不是“猜得特别准”,而是在信息极少时提供足够相关、足够多样、可快速学习的首屏。可用信号通常分为三类:用户进入产品时天然携带的上下文、用户主动选择的兴趣,以及同类新用户的群体反馈。
地域和入口适合解决“此刻可能需要什么”,设备类型能排除明显不合适的内容,分群热门提供稳定底座,兴趣选择则负责尽快拉开人与人之间的差异。任何单一信号都不应该独占排序,否则冷启动会退化成统一热门榜。
组合上下文与兴趣分数
最简单可落地的做法是先为每种弱信号分配小权重,再让兴趣匹配和分群热门贡献主要分数。下面的示例同时加入一个“同类内容最多取两条”的约束,避免高热度类别把首屏全部占满。
from dataclasses import dataclass

@dataclass
class Item:
    item_id: str
    region: str
    device: str
    entry: str
    category: str
    tags: set[str]
    group_hot: float

user = {
    "region": "华东",
    "device": "android",
    "entry": "search",
    "interests": {"摄影", "数码"},
}

items = [
    Item("A", "华东", "android", "search", "数码", {"数码", "手机"}, 0.90),
    Item("B", "华东", "ios", "feed", "摄影", {"摄影", "相机"}, 0.95),
    Item("C", "华北", "android", "search", "数码", {"数码", "耳机"}, 0.88),
    Item("D", "华东", "android", "search", "旅行", {"旅行"}, 0.99),
    Item("E", "华东", "android", "feed", "摄影", {"摄影", "镜头"}, 0.80),
]

def cold_score(item: Item) -> float:
    score = 2.0 * item.group_hot
    score += 1.2 if item.region == user["region"] else 0.0
    score += 0.5 if item.device == user["device"] else 0.0
    score += 0.6 if item.entry == user["entry"] else 0.0
    score += 1.8 if item.tags & user["interests"] else 0.0
    return score

ranked = sorted(items, key=cold_score, reverse=True)

result = []
category_count: dict[str, int] = {}
for item in ranked:
    if category_count.get(item.category, 0) >= 2:
        continue
    result.append((item.item_id, round(cold_score(item), 2)))
    category_count[item.category] = category_count.get(item.category, 0) + 1
    if len(result) == 4:
        break

print(result)
预期输出:
[('A', 5.9), ('E', 5.1), ('C', 4.66), ('D', 4.28)]这里的绝对权重不是固定答案,关键是让每项权重都能解释、可离线回放、可在线实验。上线前应把同一批候选在不同人群上重放,检查是否出现地域偏置、某设备独占或某一类别过度集中。
平滑切换到个性化模型
不要用“行为数达到 10 条就瞬间切换模型”的硬开关。更稳妥的方式是把冷启动分数和个性化分数做加权混合,并让个性化权重随有效行为逐步提高。例如把有效行为数记为 ,在 20 次行为内线性提高个性化权重:
最终分数可写成:
“有效行为”应排除误触、极短停留和异常流量,至少包含点击后的停留、收藏、加购、播放完成度等能表达偏好的事件。这样即使新用户只产生了少量行为,系统也会先小幅吸收个性化结果,不会因为一次偶然点击立刻改变整页推荐。
验证首屏是否真的更好
冷启动实验不能只看点击率。统一热门榜往往能获得不错的短期点击,却可能导致内容同质化、后续兴趣学习变慢。至少同时观察首屏点击率、有效停留、首日二次访问、类别覆盖率和进入个性化阶段所需的有效行为数。
实验时保留一个简单基线,例如“全站热门 + 基础质量过滤”。如果新策略点击率略升但类别覆盖显著下降,通常说明热门权重过大;如果覆盖提高却有效停留下降,则要检查兴趣选择是否太宽泛或上下文信号是否误用。
最终目标不是让冷启动模型长期承担推荐,而是让新用户从第一屏开始就获得可接受体验,并尽快产生足够高质量的反馈,使个性化模型自然接管流量。