
机器学习与深度学习 / 系统课时
给新物品争取合理曝光
给新物品争取合理曝光
新物品没有点击、收藏和转化历史,如果召回与排序完全依赖历史交互,它会因为“没曝光所以没行为、没行为所以继续没曝光”而永久沉底。本节用内容向量进入候选池,再通过质量门槛、探索配额和曝光上限分配有限流量,让新物品获得可学习但不过度的试验机会。
学习目标
- 能让无历史行为的新物品通过内容特征进入召回池
- 能用质量门槛和探索配额控制新物品曝光
- 能设置曝光上限并根据早期反馈决定继续放量或停止探索
先打破零曝光闭环
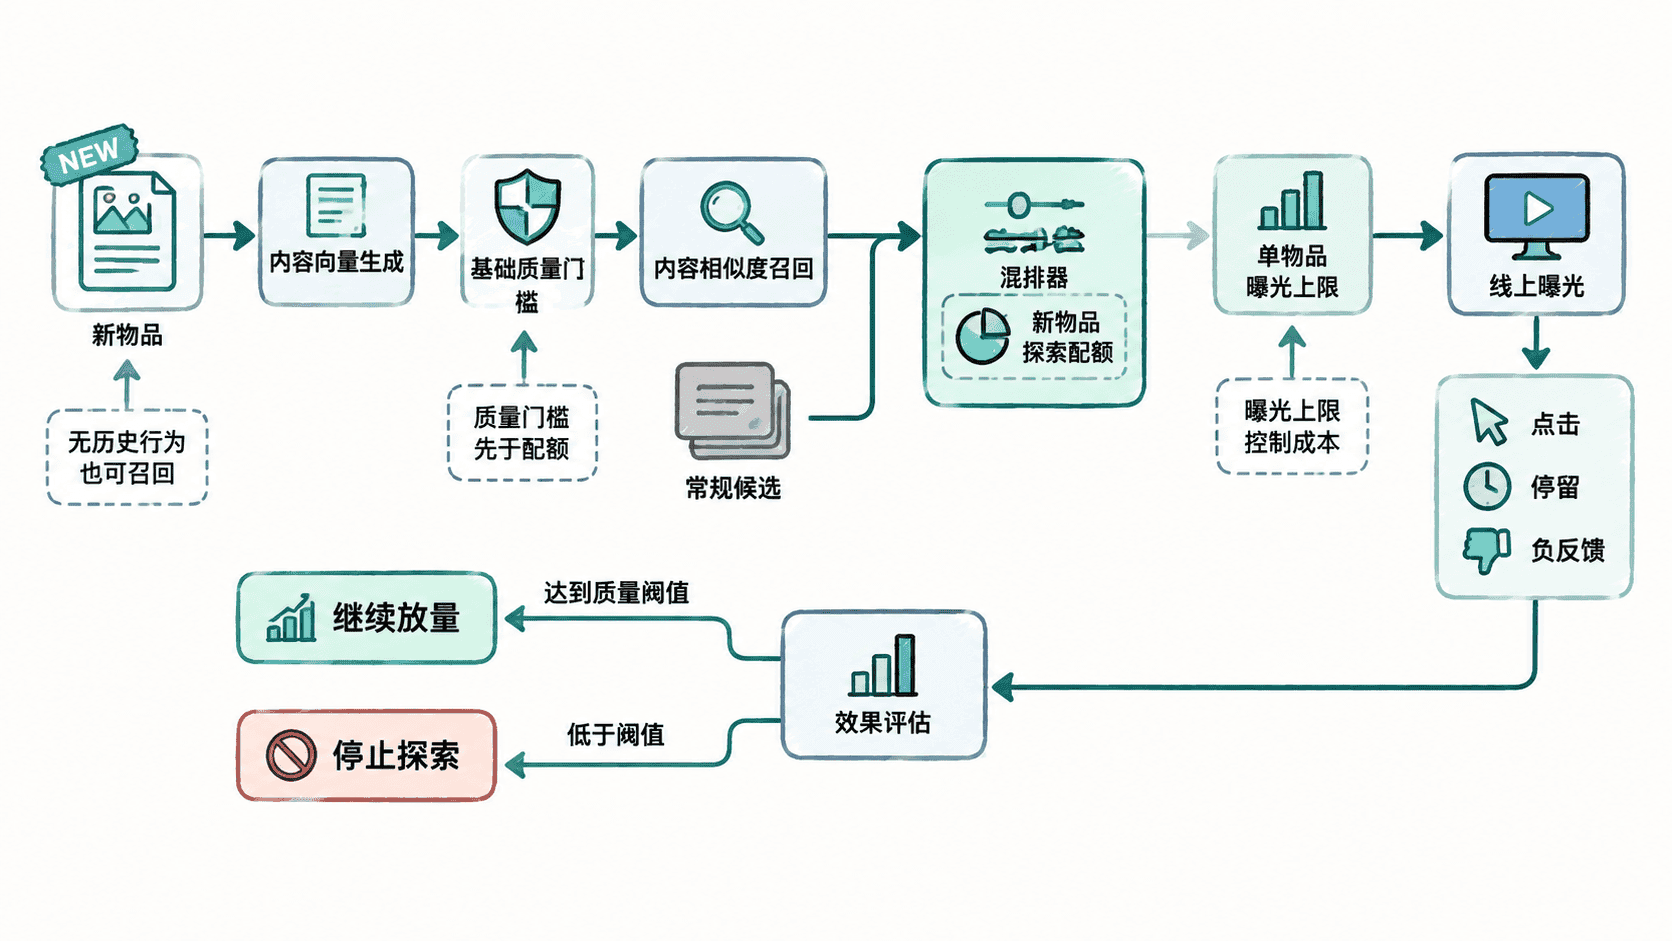
新物品的第一步不是直接提高排序分,而是确保它有资格被召回。常见做法是用标题、标签、类目、作者、图像或文本编码得到内容向量,再和用户兴趣向量计算相似度。这样即使物品完全没有协同过滤信号,也能凭内容相关性进入候选集。
探索流量必须经过基础质量门槛。例如缺图、标题异常、重复内容、风控失败或低质量作者产出的物品,不应该因为“新”就获得额外曝光。新物品机制只解决历史数据不足,不应该绕过内容治理。
用配额而不是无条件加分
探索配额比“所有新物品统一加 20 分”更安全,因为统一加分会让低质量内容在大流量入口里反复挤占位置。更合理的策略是:常规候选照常排序,同时从满足质量门槛的新物品中选出少量高内容相似度候选,占据固定比例或固定坑位。
下面示例给 5 个展示位保留 2 个新物品探索位,并对每个新物品设置累计曝光上限。
from dataclasses import dataclass

@dataclass
class Candidate:
    item_id: str
    is_new: bool
    quality: float
    similarity: float
    rank_score: float
    exposures: int

candidates = [
    Candidate("old-1", False, 0.95, 0.90, 0.93, 5000),
    Candidate("old-2", False, 0.92, 0.82, 0.88, 4200),
    Candidate("old-3", False, 0.90, 0.78, 0.84, 3900),
    Candidate("new-1", True, 0.88, 0.91, 0.00, 30),
    Candidate("new-2", True, 0.83, 0.86, 0.00, 80),
    Candidate("new-3", True, 0.70, 0.95, 0.00, 10),
    Candidate("new-4", True, 0.90, 0.72, 0.00, 120),
]

QUALITY_GATE = 0.80
EXPOSURE_CAP = 100
NEW_QUOTA = 2
PAGE_SIZE = 5

eligible_new = [
    c for c in candidates
    if c.is_new and c.quality >= QUALITY_GATE and c.exposures < EXPOSURE_CAP
]
eligible_new.sort(key=lambda c: c.similarity, reverse=True)

regular = [c for c in candidates if not c.is_new]
regular.sort(key=lambda c: c.rank_score, reverse=True)

selected_new = eligible_new[:NEW_QUOTA]
selected_regular = regular[:PAGE_SIZE - len(selected_new)]
result = [c.item_id for c in selected_regular + selected_new]

print(result)
预期输出:
['old-1', 'old-2', 'old-3', 'new-1', 'new-2']new-3 因质量低于门槛被拦截,new-4 因累计曝光超过上限不再占用探索流量。这样探索预算集中在“质量合格且与当前用户相关”的新物品上,而不是平均撒给所有新内容。
用早期反馈决定继续还是停
一次曝光不能说明问题,但无限探索也不可接受。可以给每个新物品设置最小样本窗口,例如先获得 50~200 次有效曝光,再检查点击率、长停留、完播、收藏或负反馈等指标。达到阈值才扩大流量,否则回到普通竞争。
阈值最好使用分层基线,而不是全站统一值。短视频、长文和商品详情的点击与消费深度天然不同;高活跃用户和低活跃用户的基准也不同。实践中通常按类目、内容类型和流量入口计算对照分布,再判断新物品是否值得继续探索。
控制探索成本与位置偏差
探索坑位放在列表第 1 位会得到大量天然点击,放在第 20 位又几乎学不到东西,因此要固定位置策略或在实验中做位置校正。最简单的做法是只在前若干屏设置少量探索位,并记录每次曝光对应的位置、入口和用户分群。
还要限制单个物品、单个作者或单个类目的探索份额,防止某批新内容同时上线时挤占正常推荐。配额可以分成“全局新物品预算”和“单物品上限”两层:前者控制系统整体成本,后者限制局部失败带来的浪费。
一个健康的新物品机制应该形成闭环:内容特征负责获得第一次机会,质量门槛决定谁有资格探索,配额和曝光上限控制成本,早期反馈决定是否继续放量。这样既能避免新物品永久无曝光,也不会让低质量内容因为“新”而长期侵占流量。