
机器学习与深度学习 / 系统课时
训练排序模型并生成 TopK
训练排序模型并生成 TopK
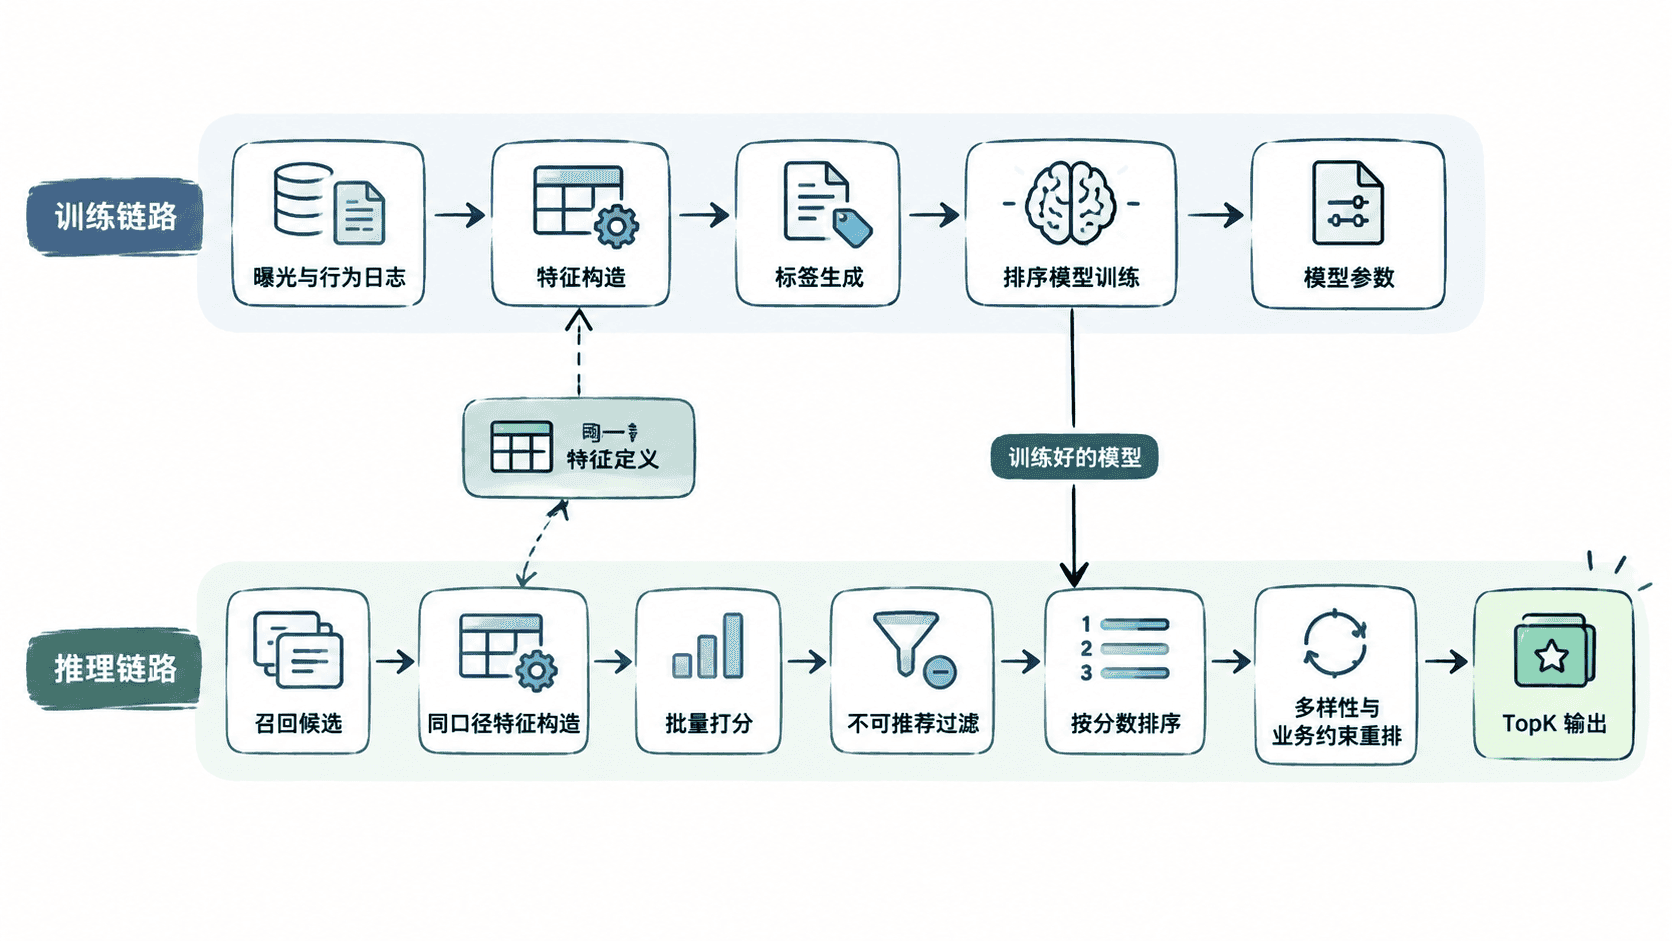
这一节完成从训练样本到最终推荐列表的闭环:先用用户与物品特征训练一个可解释的排序模型,再对离线候选批量打分,经过不可推荐过滤和多样性重排,最终产出服务端可以直接读取的 TopK 列表。
学习目标
- 从训练样本构造特征并训练基础排序模型
- 对候选集批量打分,并在排序后执行业务过滤与重排
- 检查 TopK 的覆盖、多样性和业务约束是否同时满足
把训练目标和线上特征对齐
排序模型学习的是“哪些候选更值得排在前面”。训练样本通常由曝光日志连接点击、停留、收藏或转化标签形成,特征则来自用户、物品、上下文以及召回阶段。最重要的工程约束是训练和预测必须使用同一套特征定义。
如果训练阶段使用了未来才能得到的数据,例如曝光后的点击次数,离线指标会异常漂亮,但线上无法复现,这就是典型的数据泄漏。特征还应固定字段名、类型、缺失值策略和归一化方式,避免训练与服务两套实现逐渐漂移。
训练一个最小可运行排序模型
为了把完整链路讲清楚,下面使用标准库实现一个简单的逻辑回归排序器。真实项目可以替换为 LightGBM、XGBoost 或深度模型,但样本、特征、打分和后处理之间的边界保持一致。
from math import exp

FEATURES = ("ctr", "similarity", "freshness", "popularity")

train_rows = [
    ({"ctr": 0.9, "similarity": 0.9, "freshness": 0.8, "popularity": 0.7}, 1),
    ({"ctr": 0.8, "similarity": 0.7, "freshness": 0.9, "popularity": 0.6}, 1),
    ({"ctr": 0.6, "similarity": 0.8, "freshness": 0.5, "popularity": 0.7}, 1),
    ({"ctr": 0.2, "similarity": 0.3, "freshness": 0.4, "popularity": 0.3}, 0),
    ({"ctr": 0.1, "similarity": 0.2, "freshness": 0.7, "popularity": 0.2}, 0),
    ({"ctr": 0.3, "similarity": 0.4, "freshness": 0.2, "popularity": 0.5}, 0),
]


def sigmoid(z):
    return 1.0 / (1.0 + exp(-z))


def train_logistic(rows, epochs=500, lr=0.4):
    weights = {name: 0.0 for name in FEATURES}
    bias = 0.0

    for _ in range(epochs):
        grad_w = {name: 0.0 for name in FEATURES}
        grad_b = 0.0

        for x, y in rows:
            p = sigmoid(sum(weights[f] * x[f] for f in FEATURES) + bias)
            error = p - y
            for feature in FEATURES:
                grad_w[feature] += error * x[feature]
            grad_b += error

        n = len(rows)
        for feature in FEATURES:
            weights[feature] -= lr * grad_w[feature] / n
        bias -= lr * grad_b / n

    return weights, bias


weights, bias = train_logistic(train_rows)
print("weights:", {k: round(v, 3) for k, v in weights.items()})
print("bias:", round(bias, 3))
预期输出:
weights: {'ctr': 4.972, 'similarity': 3.975, 'freshness': 1.578, 'popularity': 1.606}
bias: -6.011
这里的权重只由这组教学数据产生,不能解释为真实业务中的特征重要性。生产模型应使用独立验证集比较 AUC、NDCG 等指标,并检查样本时间切分,避免同一用户或同一事件的信息泄漏到验证集。
批量打分并执行过滤重排
有了模型后,候选处理顺序通常是“构造特征 → 模型打分 → 硬过滤 → 按分数排序 → 业务重排”。硬过滤应尽早移除下架、不可见或风险内容;多样性约束则通常放在排序之后,因为它需要看到高分候选的整体分布。
下面继续使用刚才训练出的 weights 和 bias,因此这一段是片段示例,依赖上一代码块已经执行完成。
candidates = [
    {"item_id": "A", "category": "tech", "available": True, "blocked": False,
     "ctr": 0.85, "similarity": 0.92, "freshness": 0.80, "popularity": 0.75},
    {"item_id": "B", "category": "tech", "available": True, "blocked": False,
     "ctr": 0.80, "similarity": 0.88, "freshness": 0.65, "popularity": 0.72},
    {"item_id": "C", "category": "news", "available": True, "blocked": False,
     "ctr": 0.70, "similarity": 0.73, "freshness": 0.95, "popularity": 0.68},
    {"item_id": "D", "category": "tech", "available": True, "blocked": False,
     "ctr": 0.78, "similarity": 0.82, "freshness": 0.70, "popularity": 0.65},
    {"item_id": "E", "category": "sports", "available": False, "blocked": False,
     "ctr": 0.90, "similarity": 0.80, "freshness": 0.90, "popularity": 0.80},
    {"item_id": "F", "category": "sports", "available": True, "blocked": False,
     "ctr": 0.55, "similarity": 0.70, "freshness": 0.85, "popularity": 0.60},
    {"item_id": "G", "category": "news", "available": True, "blocked": True,
     "ctr": 0.88, "similarity": 0.86, "freshness": 0.88, "popularity": 0.77},
]


def score(row):
    z = sum(weights[f] * row[f] for f in FEATURES) + bias
    return sigmoid(z)


scored = []
for row in candidates:
    if not row["available"] or row["blocked"]:
        continue
    item = dict(row)
    item["score"] = score(row)
    scored.append(item)

scored.sort(key=lambda x: (-x["score"], x["item_id"]))

# 每个类别最多保留 2 个,避免单一类别占满最终列表。
topk = []
category_count = {}
for row in scored:
    if category_count.get(row["category"], 0) >= 2:
        continue
    topk.append(row)
    category_count[row["category"]] = category_count.get(row["category"], 0) + 1
    if len(topk) == 4:
        break

print("TopK:")
for rank, row in enumerate(topk, 1):
    print(rank, row["item_id"], row["category"], f'{row["score"]:.4f}')
print("coverage=", len(topk), "/", len(candidates))
print("categories=", len(category_count))
print("business_constraints_ok=", all(v <= 2 for v in category_count.values()))
预期输出:
TopK:
1 A tech 0.9871
2 B tech 0.9746
3 C news 0.9508
4 F sports 0.8595
coverage= 4 / 7
categories= 3
business_constraints_ok= True
候选 E 因不可用被过滤,G 因命中屏蔽条件被过滤;D 虽然模型分较高,但技术类已经达到两个名额,因此在多样性重排阶段被跳过,最终由体育类 F 补入 TopK。
检查覆盖和多样性是否真实有效
TopK 长度达到目标并不代表列表合格。至少要同时确认可推荐约束全部通过、最终列表包含足够的类别或主题、重要召回来源没有整体消失,并观察过滤前后候选数量是否异常缩减。
多样性规则也不能无限加码。如果每个类别只能出现一个物品,可能会把大量高相关候选挤掉;更稳妥的做法是给约束设置明确上限,并离线比较相关性指标与覆盖、多样性之间的变化。
生成服务可直接读取的 TopK
离线产出的 TopK 通常至少保存用户标识、物品标识、排名、最终分数和生成版本。服务读取时应按用户直接获取已经排序好的结果,而不是再次执行一套不同的过滤逻辑,否则离线验收结果与线上展示会产生偏差。
上线前应抽样核对同一批候选经过相同模型和相同规则能稳定得到一致顺序,并分别监控模型打分分布、过滤率、TopK 填充率和类别覆盖。这样当最终列表质量下降时,可以快速区分是特征、模型、候选池还是业务重排导致的问题。