
机器学习与深度学习 / 系统课时
按时间切分训练集与测试集
按时间切分训练集与测试集
推荐系统离线评估真正要模拟的是“用过去预测未来”。本节按照事件时间构造训练、验证和测试区间,检查每个分区的用户与物品覆盖,并说明为什么随机切分可能把未来信息带回训练阶段,从而让离线指标显得过于乐观。
学习目标
- 按时间边界构造互不穿越的训练、验证和测试数据
- 理解随机切分在推荐场景中可能造成的时间泄漏
- 检查各分区用户、物品和时间范围是否发生异常漂移
用时间模拟真实推荐过程
线上推荐发生在明确的时间点:系统只能使用当时已经发生的行为训练模型或生成用户特征,然后预测之后的行为。因此离线切分也应保持相同因果顺序,例如训练集覆盖 9 月 8 日之前的数据,验证集覆盖 9 月 8 日到 10 日之前的数据,测试集从 9 月 10 日开始。
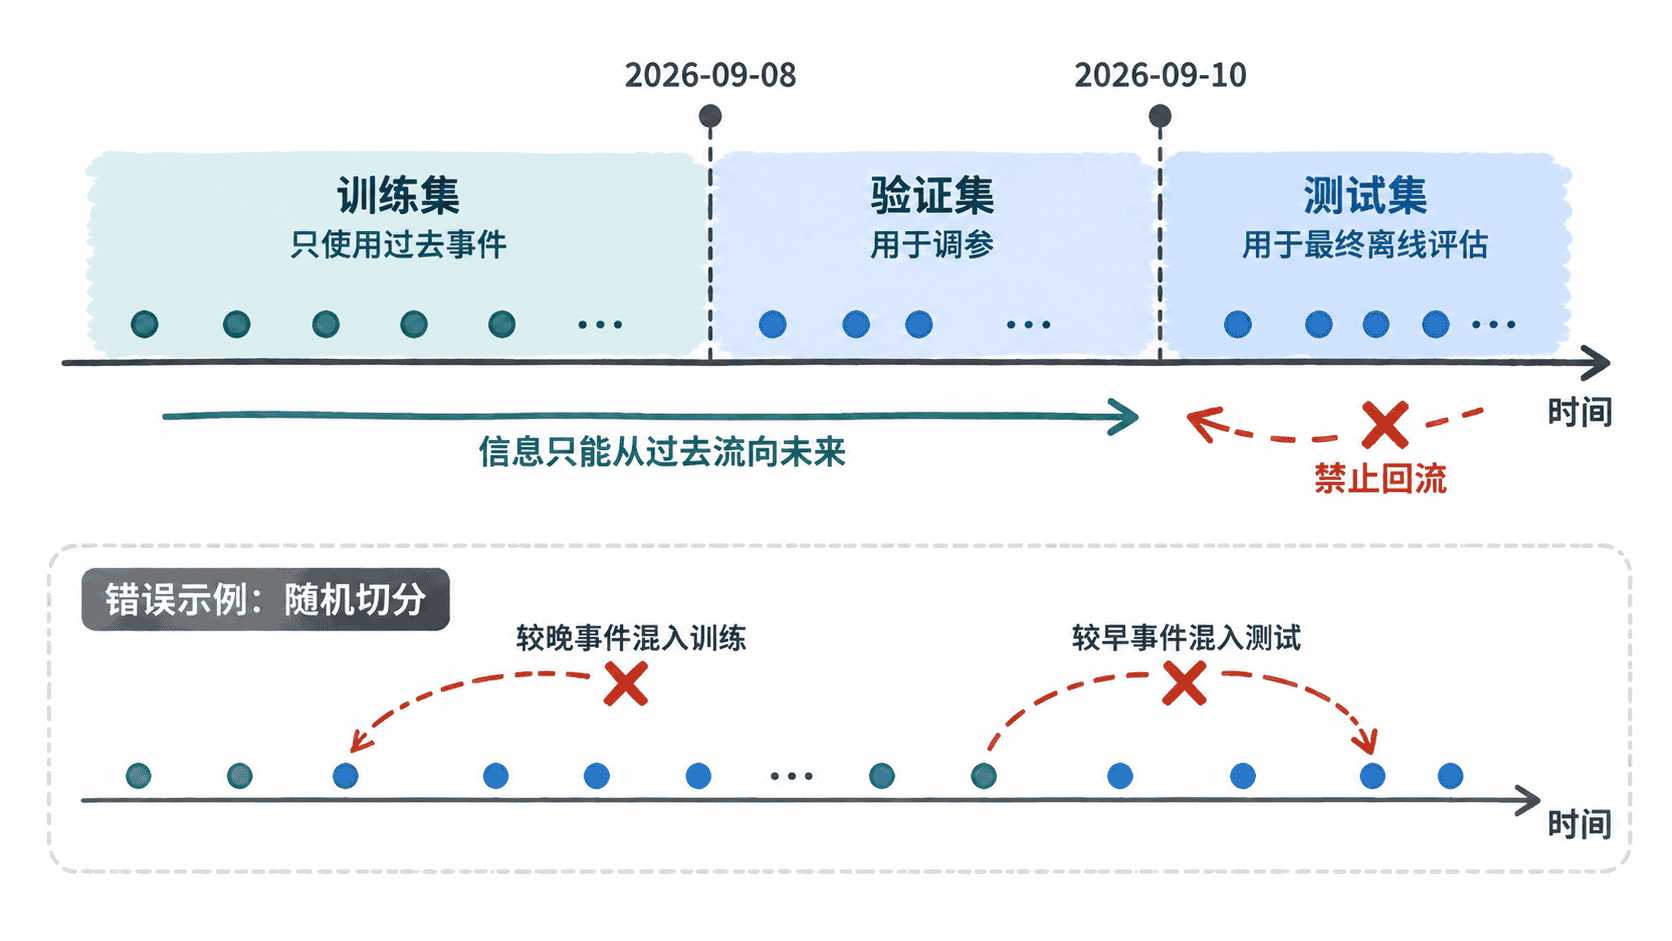
随机切分会打散这种顺序。即使测试标签本身没有直接进入训练集,模型也可能提前看到测试时刻之后才出现的物品热度、用户兴趣或交互关系,使任务变成“利用部分未来行为预测另一部分历史行为”。用户越活跃、特征越依赖历史累计值,这种偏差通常越明显。
构造三个时间区间
下面使用两个固定截止时间切分事件,并显式验证三个区间不存在交叉。真实项目应把截止时间记录在实验配置中,保证模型、特征和评估脚本使用完全相同的边界。
import pandas as pd

rows = [
    ('u1', 'i1', '2026-09-01 09:00:00'),
    ('u1', 'i2', '2026-09-05 10:00:00'),
    ('u1', 'i3', '2026-09-08 09:00:00'),
    ('u1', 'i1', '2026-09-10 12:00:00'),
    ('u2', 'i1', '2026-09-02 11:00:00'),
    ('u2', 'i3', '2026-09-07 13:00:00'),
    ('u2', 'i2', '2026-09-09 14:00:00'),
    ('u2', 'i2', '2026-09-11 15:00:00'),
    ('u3', 'i2', '2026-09-03 16:00:00'),
    ('u3', 'i3', '2026-09-09 17:00:00'),
    ('u3', 'i3', '2026-09-12 18:00:00'),
]

df = pd.DataFrame(rows, columns=['user_id', 'item_id', 'event_time'])
df['event_time'] = pd.to_datetime(df['event_time'])

train_end = pd.Timestamp('2026-09-08 00:00:00')
valid_end = pd.Timestamp('2026-09-10 00:00:00')

# 左闭右开区间可以避免恰好落在边界上的事件重复进入两个集合。
train = df[df['event_time'] < train_end].copy()
valid = df[(df['event_time'] >= train_end) & (df['event_time'] < valid_end)].copy()
test = df[df['event_time'] >= valid_end].copy()

for name, part in [('train', train), ('valid', valid), ('test', test)]:
    print(
        name,
        len(part),
        part['user_id'].nunique(),
        part['item_id'].nunique(),
        part['event_time'].min().strftime('%Y-%m-%d'),
        part['event_time'].max().strftime('%Y-%m-%d'),
    )

# 基础时间断言必须在每次实验中自动执行。
time_order_ok = train['event_time'].max() < valid['event_time'].min() and valid['event_time'].max() < test['event_time'].min()
train_users = set(train['user_id'])
train_items = set(train['item_id'])

print('time_order_ok', time_order_ok)
print('valid_new_user_rate', round((~valid['user_id'].isin(train_users)).mean(), 2))
print('test_new_user_rate', round((~test['user_id'].isin(train_users)).mean(), 2))
print('valid_new_item_rate', round((~valid['item_id'].isin(train_items)).mean(), 2))
print('test_new_item_rate', round((~test['item_id'].isin(train_items)).mean(), 2))
预期输出:三个集合的日期严格向后推进,示例中的验证和测试用户、物品都已经在训练区间出现,因此冷启动比例为 0。
train 5 3 3 2026-09-01 2026-09-07
valid 3 3 2 2026-09-08 2026-09-09
test 3 3 3 2026-09-10 2026-09-12
time_order_ok True
valid_new_user_rate 0.0
test_new_user_rate 0.0
valid_new_item_rate 0.0
test_new_item_rate 0.0
检查分区是否发生异常漂移
时间顺序正确并不代表数据就一定健康。切分后至少应比较事件数、独立用户数、独立物品数以及新用户和新物品比例。若训练集有大量活跃用户,而测试集突然只剩少数用户,或者测试集中绝大多数物品从未在训练阶段出现,评估结果就可能主要反映数据管道变化,而不是模型能力。
新用户或新物品比例并非越低越好。真实业务本来存在冷启动时,就应该保留这种现象,只需确认比例符合线上实际。异常的是无业务原因的突变,例如埋点改版导致某类物品从某天起集中缺失,或者某个数据源仅在测试窗口被接入。
特征也必须遵守同一个截止时间
完成数据集切分后,还要检查特征生成过程。假设测试事件发生在 9 月 11 日,那么用于预测它的用户点击次数、物品热度和最近兴趣只能根据预测时刻之前的数据计算。先在全量日志上算好这些特征,再去切训练和测试数据,仍然会把未来信息泄漏进去。
推荐实验最稳妥的原则是:先确定评估时间点,再从该时间点以前重建用户历史、物品统计和模型训练数据,最后只用之后的事件计算指标。只要数据切分和特征生成都遵守这条时间边界,离线结果才更接近模型上线后真正面对的推荐任务。