
机器学习与深度学习 / 系统课时
训练双塔模型学习检索向量
训练双塔模型学习检索向量
这一节用一个可运行的最小双塔模型,把用户特征和物品特征投影到同一向量空间,并用批内负样本训练点积相似度。完成后你会导出物品向量,并用留出的验证正样本检查相似度是否与真实偏好一致。
学习目标
- 理解用户塔、物品塔与点积检索之间的职责分工
- 用批内负样本训练一个最小双塔模型
- 导出物品向量,并用验证集检查正样本的检索排名
双塔学习的是可检索的共同空间
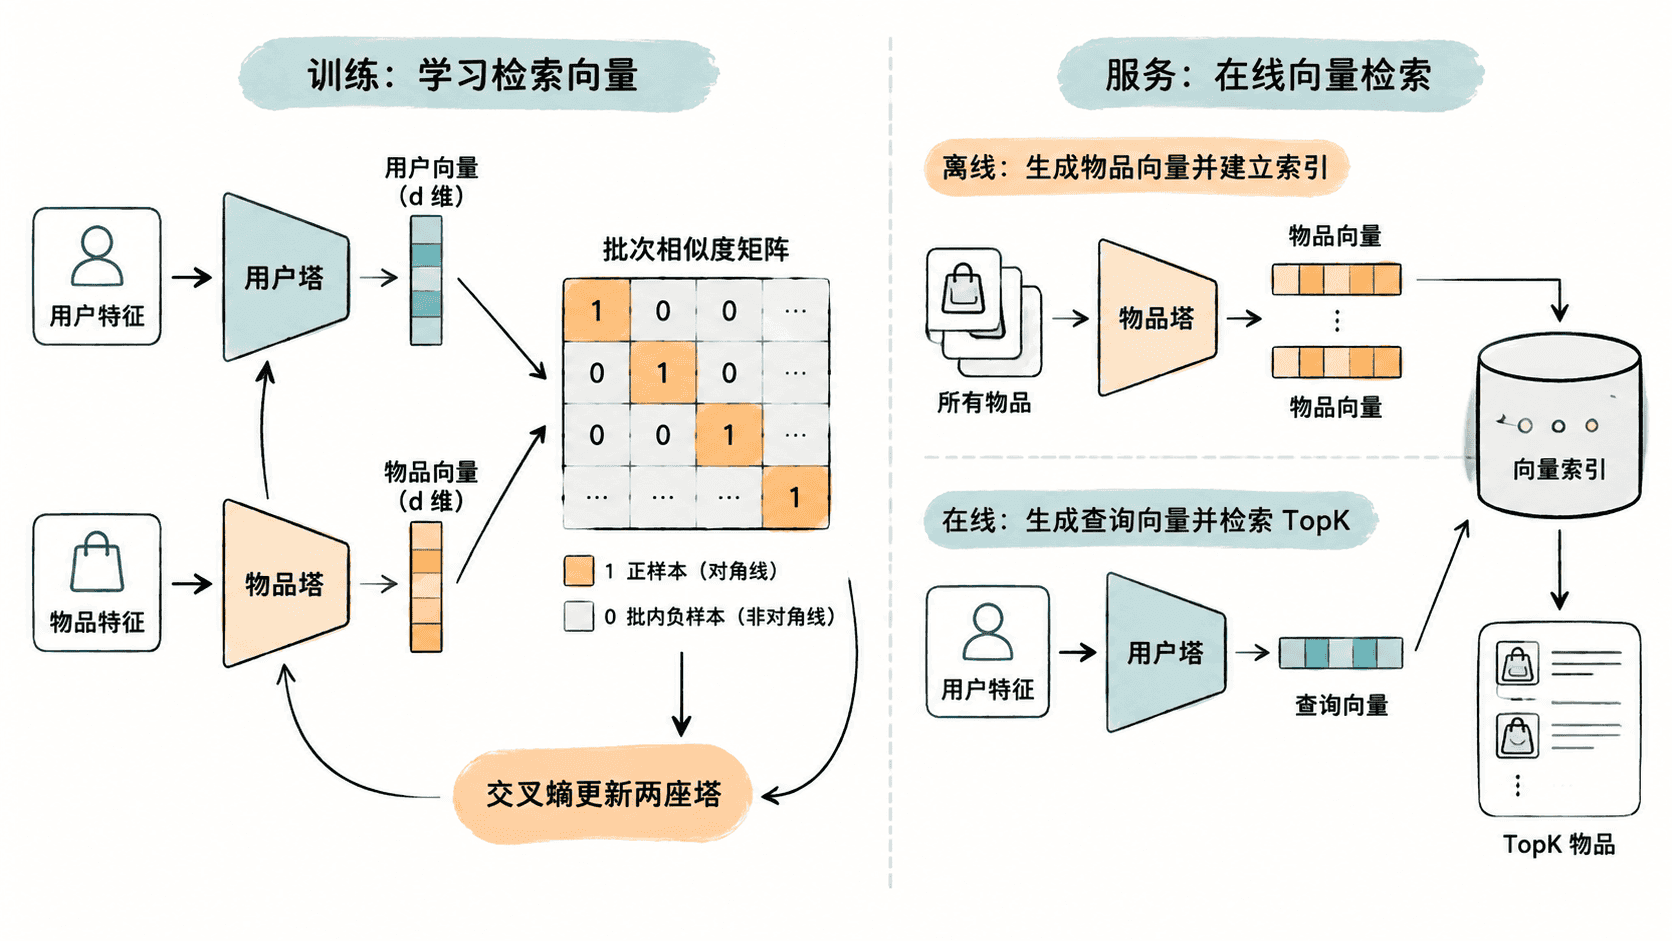
双塔不会在在线检索时把每个用户和每个物品一起送进一个大模型。用户塔只编码用户侧特征,物品塔只编码物品侧特征,二者输出相同维度的向量。训练目标是让正样本点积更大、负样本点积更小。
设用户向量为 、物品向量为 ,最常见的检索分数就是 。如果训练和服务阶段都对向量做 L2 归一化,这个点积同时具有余弦相似度的含义,便于接入常见向量索引。
用批内负样本训练最小双塔
下面假设已安装 Python 3.10+ 与 PyTorch 2.x。三个用户分别偏好三类内容;每类保留一个训练物品和一个未参与训练的验证物品。用户特征与物品特征故意做得很小,目的是把注意力放在双塔和负样本机制本身。
每个训练批次包含三个正确的用户—物品配对,因此相似度矩阵的对角线是正样本,其他位置直接充当负样本。真实业务中要特别避免把“同一用户实际也喜欢的物品”误当成负样本。
import torch
import torch.nn as nn

torch.manual_seed(7)

# 三维特征分别表示三类兴趣;验证物品与同类训练物品内容相近但并不相同。
user_features = torch.eye(3)
item_features = torch.tensor([
    [1.0, 0.0, 0.0],
    [0.9, 0.1, 0.0],
    [0.0, 1.0, 0.0],
    [0.1, 0.9, 0.0],
    [0.0, 0.0, 1.0],
    [0.0, 0.1, 0.9],
])

train_user = torch.tensor([0, 1, 2])
train_item = torch.tensor([0, 2, 4])
valid_item = torch.tensor([1, 3, 5])

class TwoTower(nn.Module):
    def __init__(self):
        super().__init__()
        self.user_tower = nn.Linear(3, 4, bias=False)
        self.item_tower = nn.Linear(3, 4, bias=False)

    def encode_user(self, features):
        return nn.functional.normalize(self.user_tower(features), dim=1)

    def encode_item(self, features):
        return nn.functional.normalize(self.item_tower(features), dim=1)

    def forward(self, user_x, item_x):
        # 返回 3×3 相似度矩阵,对角线是本批次的正样本。
        return self.encode_user(user_x) @ self.encode_item(item_x).T

model = TwoTower()
optimizer = torch.optim.Adam(model.parameters(), lr=0.08)

for epoch in range(201):
    logits = model(user_features[train_user], item_features[train_item]) / 0.1
    target = torch.arange(3)
    loss = nn.functional.cross_entropy(logits, target)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if epoch in (0, 50, 100, 200):
        print(f"epoch={epoch} loss={loss.item():.4f}")

with torch.no_grad():
    user_vectors = model.encode_user(user_features)
    item_vectors = model.encode_item(item_features)
    scores = user_vectors @ item_vectors.T

    # 验证物品未作为该用户的训练正样本,用它检查同类偏好是否被映射到邻近位置。
    for user_id, heldout in enumerate(valid_item.tolist()):
        ranking = torch.argsort(scores[user_id], descending=True).tolist()
        rank = ranking.index(heldout) + 1
        print(
            f"u{user_id} heldout=i{heldout} "
            f"rank={rank} score={scores[user_id, heldout]:.4f}"
        )

    torch.save(item_vectors.cpu(), "item_vectors.pt")
    print("saved item_vectors.pt shape=", tuple(item_vectors.shape))
预期输出
epoch=0 loss=7.5169
epoch=50 loss=0.0005
epoch=100 loss=0.0003
epoch=200 loss=0.0002
u0 heldout=i1 rank=2 score=0.7608
u1 heldout=i3 rank=2 score=0.4868
u2 heldout=i5 rank=2 score=0.8562
saved item_vectors.pt shape= (6, 4)
不同 PyTorch 小版本或硬件上的末位小数可能有轻微差异,但应看到损失显著下降,三个留出正样本都进入各自用户的前列,并成功导出形状为 (6, 4) 的物品向量文件。
批内负样本为什么高效
如果一个批次有 个正样本,双塔只需要各编码 次,就能得到一个 的相似度矩阵。对第一个用户来说,本行对角线对应它的正物品,其余 个物品都可作为负样本,因此一个批次天然提供了大量对比信号。
这种方法的风险是假负样本。热门物品、同主题物品或同一用户的多个真实正反馈,很可能出现在同一批次中。如果直接把它们视为负例,会把本来应该接近的向量推远。生产训练通常会做正样本去重、同用户样本隔离,或者对已知正反馈加掩码。
验证集要检查排序关系而不是只看训练损失
训练损失下降只说明模型越来越会区分训练批次,不能证明检索向量能泛化。更可靠的做法是按时间切分交互:较早行为训练,较晚行为验证;然后用用户向量检索全量或大规模候选,计算 Recall@K、HitRate@K 或 NDCG@K。
本例故意把 i1、i3、i5 留出,并让它们只通过内容特征与训练物品建立联系。三者都排到各自用户的第 2 名,说明两座塔至少学到了“同类内容应靠近对应兴趣用户”的关系,而不只是记住物品 ID。
导出后才进入真正的向量检索链路
训练完成后,物品塔通常离线批量计算全量物品向量并写入向量数据库或 ANN 索引;在线请求只需计算一次用户向量,再取 TopK 最近物品。这样在线成本与物品总量解耦,双塔才真正具有大规模召回价值。
导出前要保证训练、离线建库和在线查询使用完全一致的特征处理、向量维度与归一化方式。任何一处口径不一致,都可能出现“离线指标正常、上线召回失真”的问题。