
机器学习与深度学习 / 系统课时
设计召回排序在线服务边界
设计召回排序在线服务边界
本节要把推荐请求拆成可独立治理的在线阶段,并给每个阶段明确输入、输出、超时和降级策略。完成后,你可以画出一条可执行的召回—特征—排序—重排链路,并知道某个依赖变慢时应该在哪里止损。
学习目标
- 划分用户上下文、候选召回、特征获取、模型排序和重排的服务边界
- 为各阶段分配超时预算,并识别串行依赖与可并行依赖
- 为超时、空结果和依赖失败设计可观测、可验证的降级路径
先确定一条清晰的在线主链路
一次推荐请求通常从用户与场景上下文开始,经候选召回缩小搜索空间,再补齐排序所需特征,调用模型得到分数,最后通过规则重排生成最终列表。边界划分的核心不是“拆得越细越好”,而是让每个阶段都有稳定契约、独立超时和可解释的失败方式。
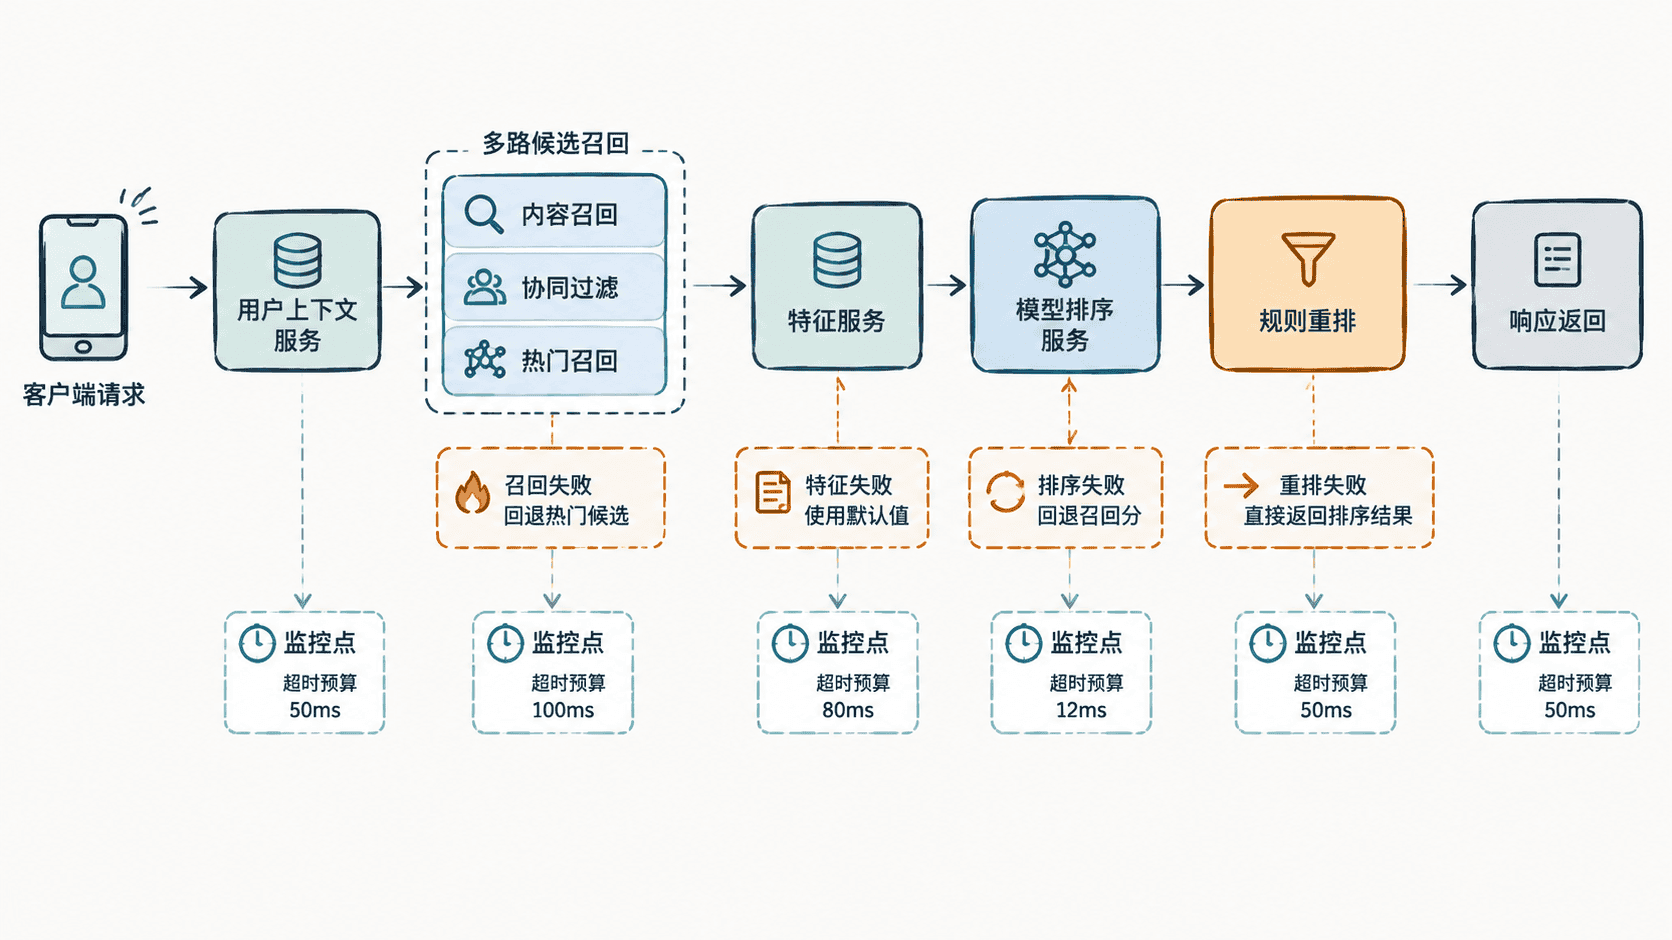
推荐入口只负责请求编排和总超时控制,不应该把各阶段业务逻辑塞进一个大方法。用户上下文阶段负责产出用户标识、场景、设备与实时状态;召回阶段只返回候选 ID 与召回来源;特征阶段把用户、物品和交叉特征补齐;排序阶段输出候选分数;重排阶段处理去重、配额、业务约束和探索策略。
用接口契约隔离阶段职责
边界一旦确定,接口应尽量传递“本阶段真正需要的数据”,避免下游反向依赖上游内部对象。推荐入口可以接收用户与场景,内部各阶段则使用稳定 DTO,例如候选对象至少携带 itemId、source 和可选的召回分,排序结果再附加模型分。
下面的请求示例假设本地服务暴露 POST /v1/recommend,用于验证入口契约和响应中的降级标记。执行前将 <PORT> 替换为实际监听端口。
curl -s -X POST 'http://localhost:<PORT>/v1/recommend' \
  -H 'Content-Type: application/json' \
  -d '{"userId":"u-1001","scene":"home","size":3}'
预期结果为 HTTP 200,返回 3 个推荐结果;degradedStages 为空表示本次未触发降级。实际请求 ID 会不同。
{
  "requestId": "<ID>",
  "items": [
    {"itemId": "i-11", "score": 0.93},
    {"itemId": "i-27", "score": 0.88},
    {"itemId": "i-35", "score": 0.82}
  ],
  "degradedStages": []
}
如果某个内部阶段需要几十个字段才能调用,通常说明边界泄漏了。更稳妥的做法是让该阶段拥有自己的请求模型,并在编排层做一次显式转换,这样版本演进和回滚都更容易控制。
把总延迟拆成阶段预算
在线推荐不能只配置一个“总超时”。如果入口 SLA 是 100 ms,应先保留网络、序列化和调度余量,再把剩余时间分给关键阶段。例如可将用户上下文控制在 10 ms,多路召回并行预算 25 ms,特征获取 20 ms,模型排序 20 ms,重排 5 ms,其余作为抖动余量。
预算不是简单相加。能并行的召回通道,其耗时由最慢的被等待通道决定;存在严格前后依赖的阶段才形成串行关键路径。因此设计时要明确哪些调用可以并发,哪些数据必须等上一步完成后才能产生。
为每个阶段准备最小可接受降级
降级要满足两个条件:第一,返回结果仍然可用;第二,不能破坏后续阶段的数据契约。候选召回超时时,可以回退到热门、缓存或上一周期候选;特征读取失败时,只能对已声明可缺失的特征使用默认值;模型服务失败时,可退回召回分或轻量规则分;重排失败时,通常可以直接返回已排序结果。
不要把“捕获异常后返回空列表”当作通用降级。空结果会让下游无法区分“用户确实没有候选”和“系统故障”。推荐入口应显式记录降级阶段、原因和使用的 fallback,至少把这些信息写入日志、指标和链路追踪。
监控点要跟服务边界一起设计
每个阶段至少需要四类观测:调用量、延迟分位数、错误率和降级率。召回还应记录各通道候选数与去重后数量;特征阶段记录缺失率和默认值命中率;排序阶段记录模型版本与推理耗时;重排阶段记录规则过滤量。
故障定位时按“入口总延迟 → 阶段延迟 → 依赖调用 → 降级触发”顺序排查,通常比直接翻业务日志更快。边界设计得好,某个阶段异常时既能被快速定位,也能被局部熔断,而不会让整条推荐链路一起失效。