
机器学习与深度学习 / 系统课时
实现多路召回与候选合并
实现多路召回与候选合并
这一节把热门、协同过滤和向量召回真正接成一个候选生成模块。最终输出不仅要去重,还要保留各路来源、召回分数与分路统计,使排序阶段可以直接消费,并能在候选池波动时快速判断是哪一路出了问题。
学习目标
- 实现多路召回、分路配额和统一候选结构
- 正确处理跨召回通道重复物品并保留来源信息
- 用数量、覆盖和耗时统计验证候选池是否符合预期
先固定候选输出契约
多路召回最容易出现的问题不是“召不到”,而是每一路输出格式不同。排序层如果分别理解热门分、相似度、协同过滤分,会把召回逻辑泄漏到后续模块,因此应先统一为候选表。
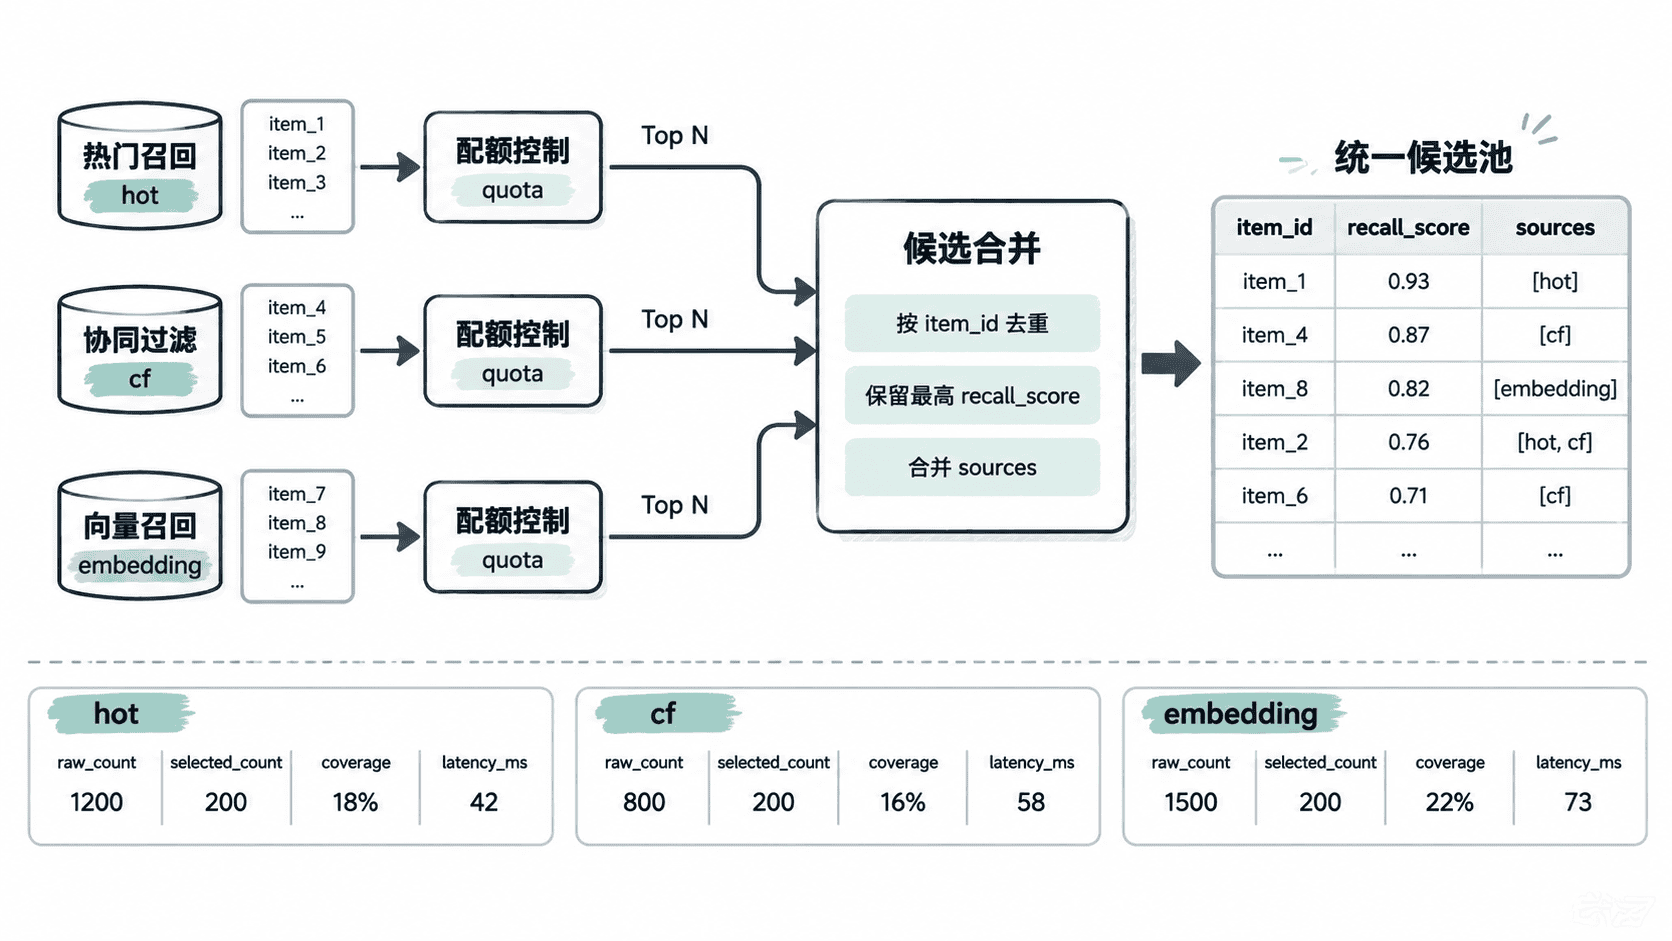
一个候选至少需要 item_id、recall_score 和 sources。其中 recall_score 只表示召回阶段的相对强度,不能直接当最终排序分;sources 必须保留全部命中的召回通道,后续既可以作为排序特征,也能用于线上诊断。
实现分路召回和配额
下面的完整 Python 示例模拟三条召回通道。每一路先独立生成候选,再应用自己的配额;合并时按 item_id 去重,重复候选保留较高召回分,同时累积所有来源。
from dataclasses import dataclass
from time import perf_counter

@dataclass
class Hit:
    item_id: str
    score: float


def recall_hot():
    return [Hit("A", 0.91), Hit("B", 0.87), Hit("C", 0.83), Hit("D", 0.70)]


def recall_cf():
    return [Hit("B", 0.95), Hit("E", 0.90), Hit("F", 0.80), Hit("G", 0.72)]


def recall_embedding():
    return [Hit("A", 0.93), Hit("H", 0.89), Hit("E", 0.84), Hit("I", 0.78)]


ROUTES = {
    "hot": (recall_hot, 3),
    "cf": (recall_cf, 3),
    "embedding": (recall_embedding, 3),
}


def run_route(name, fn, quota):
    start = perf_counter()
    raw = fn()
    selected = raw[:quota]
    latency_ms = (perf_counter() - start) * 1000
    return selected, {
        "route": name,
        "raw_count": len(raw),
        "selected_count": len(selected),
        "latency_ms": latency_ms,
    }


def merge_candidates():
    merged = {}
    stats = []

    for route, (fn, quota) in ROUTES.items():
        hits, stat = run_route(route, fn, quota)
        stats.append(stat)

        for hit in hits:
            row = merged.setdefault(
                hit.item_id,
                {"item_id": hit.item_id, "recall_score": hit.score, "sources": []},
            )
            # 同一物品命中多路时保留更高召回分,同时保留全部来源。
            row["recall_score"] = max(row["recall_score"], hit.score)
            row["sources"].append(route)

    candidates = sorted(
        merged.values(),
        key=lambda x: (-x["recall_score"], x["item_id"]),
    )

    for stat in stats:
        route = stat["route"]
        covered = sum(route in row["sources"] for row in candidates)
        stat["coverage"] = covered / len(candidates) if candidates else 0.0

    return candidates, stats


candidates, stats = merge_candidates()
for stat in stats:
    print(
        f'{stat["route"]}: raw={stat["raw_count"]}, '
        f'selected={stat["selected_count"]}, '
        f'coverage={stat["coverage"]:.0%}, '
        f'latency_ms={stat["latency_ms"]:.3f}'
    )

print("candidates:")
for row in candidates:
    print(row)
print("unique_count=", len(candidates))预期输出如下。<TIME> 表示本机实际测得的耗时,不同运行环境会不同。
hot: raw=4, selected=3, coverage=50%, latency_ms=<TIME>
cf: raw=4, selected=3, coverage=50%, latency_ms=<TIME>
embedding: raw=4, selected=3, coverage=50%, latency_ms=<TIME>
candidates:
{'item_id': 'B', 'recall_score': 0.95, 'sources': ['hot', 'cf']}
{'item_id': 'A', 'recall_score': 0.93, 'sources': ['hot', 'embedding']}
{'item_id': 'E', 'recall_score': 0.9, 'sources': ['cf', 'embedding']}
{'item_id': 'H', 'recall_score': 0.89, 'sources': ['embedding']}
{'item_id': 'C', 'recall_score': 0.83, 'sources': ['hot']}
{'item_id': 'F', 'recall_score': 0.8, 'sources': ['cf']}
unique_count= 6
这里三路各取 3 个候选,理论上共有 9 次召回命中,但去重后只有 6 个物品。A、B、E 分别命中两路,说明来源标记不能在去重时被覆盖。
处理配额与重复候选
配额的作用是控制候选池结构,而不只是限制总数。如果热门召回一次返回数千条,而个性化召回只有几十条,简单拼接会让热门候选淹没其他通道。生产环境通常应为每一路分别设置上限,再根据最终候选数量决定是否补召回。
去重规则也要固定。常见策略是按 item_id 合并,保留所有 sources,召回分可以取最大值、分路归一化后聚合,或者完全不合并分数而把各路分数保存为独立特征。若不同通道的分数尺度明显不同,直接比较原始分数通常不可靠。
用分路统计定位候选池变化
线上至少应记录每一路的原始数量、配额后数量、进入合并池后的覆盖比例和耗时。若总候选突然下降,可以先判断是召回源本身返回减少,还是跨路重复率升高;若数量正常但延迟上升,则应继续定位具体召回通道。
覆盖不能只看总候选数。例如总候选仍为 500,但向量召回覆盖从 40% 降到 5%,最终列表可能已经退化成热门内容。来源统计因此应该和最终候选表一起产出,而不是只写日志后丢弃。
上线前检查候选池
离线验收时应确认同一 item_id 最终只出现一次、重复命中的来源完整保留、各路配额实际生效,并检查单路故障时系统是否还能依靠其他召回通道返回结果。线上则重点监控单路数量、重复率、候选总量与 P95/P99 延迟。
完成这些约束后,多路召回模块的职责就很清楚:各通道负责“找可能相关的物品”,候选合并层负责把它们整理成稳定、可观测、可直接交给排序阶段消费的统一输入。