
机器学习与深度学习 / 系统课时
排查点击率下降的效果故障
排查点击率下降的效果故障
本课处理一种典型线上事故:新版本上线后点击率突然下降,但接口延迟和错误率都正常。你将按实验分桶、召回覆盖、特征完整性、模型版本和重排规则依次排查,并用分版本指标对照判断问题是否由新模型发布引起。
学习目标
- 建立点击率下降时从现象到根因的固定排障顺序。
- 用分桶与分版本指标区分实验配置问题和模型问题。
- 识别召回、特征与重排规则对 CTR 的典型影响模式。
先确认是不是指标或实验问题
点击率下降时不要立刻回滚模型。第一步要确认统计口径、实验分桶和样本量是否正常,否则可能把埋点延迟、分桶偏斜或流量结构变化误判成算法退化。
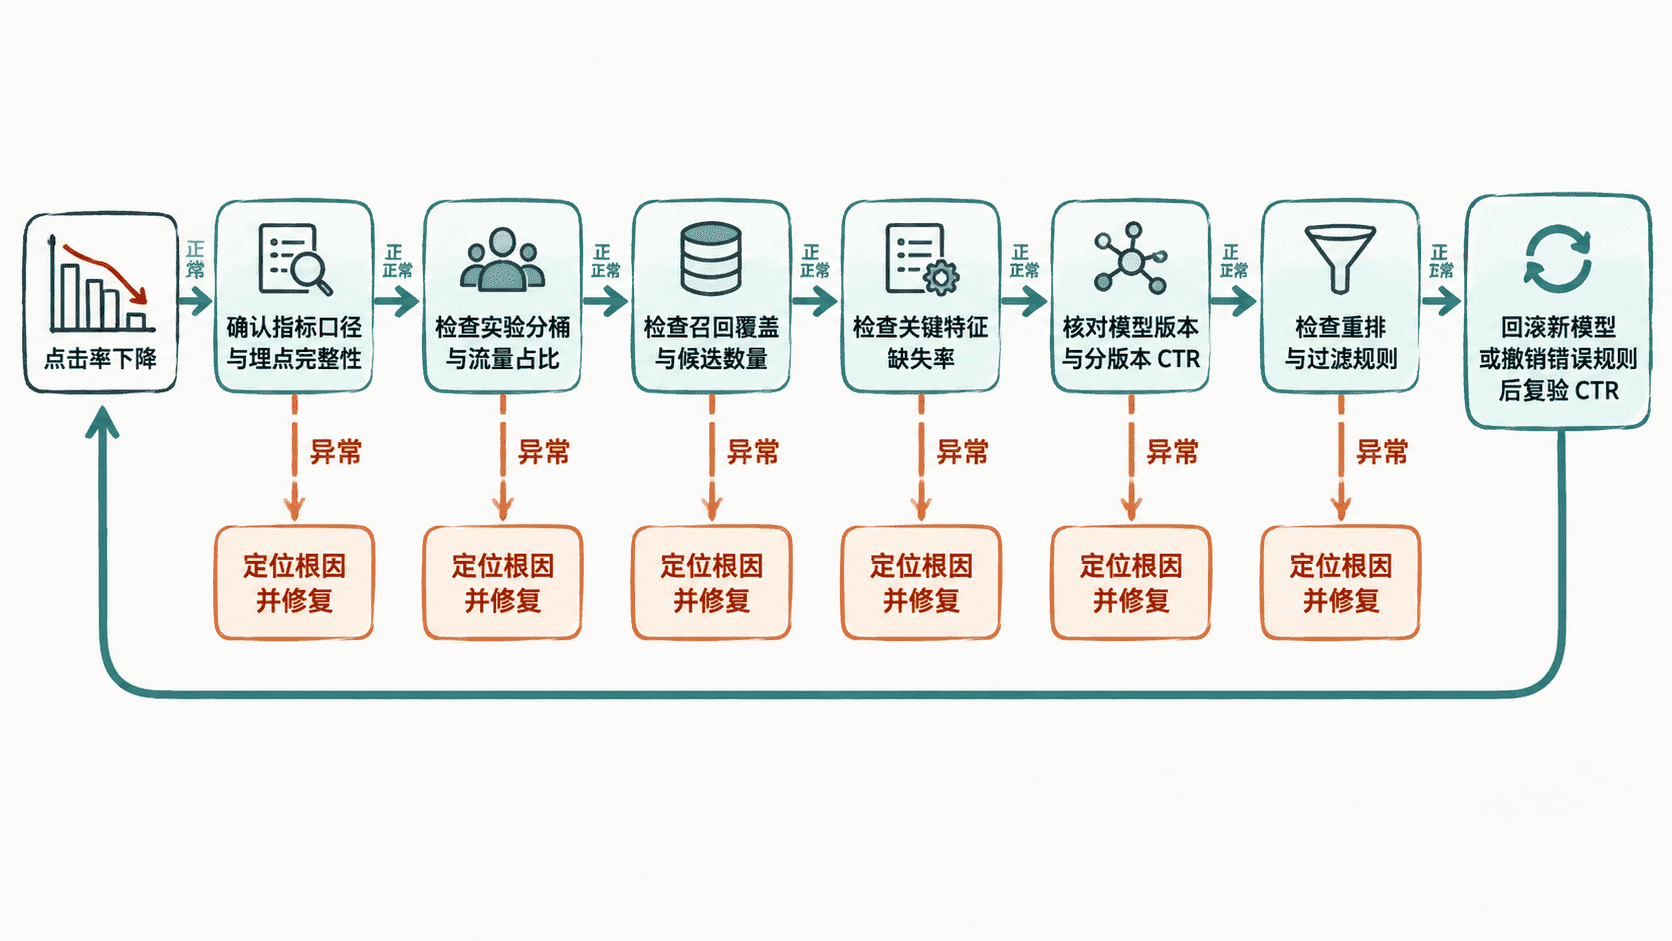
最小检查集合包括实验组流量占比、曝光数、点击数和 CTR。若新旧版本的用户量级差异异常,先查分桶;若曝光骤减,优先查召回或过滤;若曝光正常但点击下降,再深入查特征、模型和排序。
下面用一个可运行脚本模拟分版本对照,直接找出“哪个版本从何时开始退化”。
from dataclasses import dataclass

@dataclass
class Metrics:
    version: str
    users: int
    impressions: int
    clicks: int
    missing_feature_rate: float
    recall_coverage: float

def ctr(item: Metrics) -> float:
    return item.clicks / item.impressions if item.impressions else 0.0

baseline = Metrics(
    version="v41",
    users=50000,
    impressions=480000,
    clicks=38400,
    missing_feature_rate=0.002,
    recall_coverage=0.96,
)

candidate = Metrics(
    version="v42",
    users=49800,
    impressions=476000,
    clicks=30940,
    missing_feature_rate=0.087,
    recall_coverage=0.95,
)

print(f"{baseline.version} ctr={ctr(baseline):.4f}")
print(f"{candidate.version} ctr={ctr(candidate):.4f}")
print(f"ctr_delta={(ctr(candidate) - ctr(baseline)) * 100:.2f}pp")
print(f"feature_missing_delta={(candidate.missing_feature_rate - baseline.missing_feature_rate) * 100:.2f}pp")
print(f"recall_coverage_delta={(candidate.recall_coverage - baseline.recall_coverage) * 100:.2f}pp")
预期输出:
v41 ctr=0.0800
v42 ctr=0.0650
ctr_delta=-1.50pp
feature_missing_delta=8.50pp
recall_coverage_delta=-1.00pp
这个结果说明新版本 CTR 下降 1.5 个百分点,同时特征缺失率明显升高,而召回覆盖仅小幅下降。排障优先级应先指向特征链路,而不是直接归因于召回算法。
检查实验分桶与流量结构
先看实验组和对照组是否仍满足预期比例。常见问题包括哈希盐变化、用户 ID 类型改变、匿名用户落到默认桶,以及发布时误把 10% 灰度扩大成 100%。这些问题会直接改变用户构成,使 CTR 对比失去可比性。
若只有实验组 CTR 降,而同一时间对照组稳定,说明故障更可能位于实验组特有的模型、特征或规则;若两组同时下降,则应优先排查全局埋点、流量来源和业务环境变化。
逐层检查召回、特征与模型
召回故障通常先表现为候选数量减少、覆盖率下降或热门度分布异常。特征故障则常见默认值比例上升、时间戳过旧、线上离线字段不一致。模型故障需要核对服务实际加载的模型 ID、特征 schema 和训练数据版本,避免“代码是新版本,模型文件还是旧版本”或相反。
可把关键证据压缩成四个数:人均候选数、召回覆盖率、关键特征缺失率、分版本 CTR。只要新旧版本一起对照,就能迅速缩小范围。
| 现象 | 更可能的根因 |
|---|---|
| 候选数与覆盖率同步下降 | 召回服务、过滤条件、索引或检索参数异常 |
| 曝光正常但关键特征缺失率升高 | 特征服务、字段映射、版本兼容问题 |
| 特征正常且仅新模型 CTR 降 | 模型质量、模型加载或训练数据问题 |
| 模型分数正常但最终曝光分布异常 | 重排、去重、业务规则或强插逻辑异常 |
核对重排和业务规则
很多“模型效果事故”其实发生在模型之后。新上的去重、类目打散、广告插入、黑白名单和库存过滤,都可能重写模型顺序。排查时应保留排序前后的 item ID、模型分数和规则命中原因,至少对一小批用户做链路比对。
例如若模型 Top10 中 8 个高分内容在重排后被过滤,而补位内容分数显著更低,CTR 下降就不应归因于模型本身。此时回滚模型不会恢复效果,反而会掩盖真正故障点。
用版本对照决定是否回滚
当以下证据同时成立时,才适合把新模型作为首要根因:实验分桶正常、召回覆盖稳定、关键特征缺失率无异常、重排规则未变化,并且 CTR 下降只出现在新模型版本。
回滚后还要验证指标是否恢复。可以把上面的 candidate 替换为旧模型同口径数据,再运行一次脚本;若 CTR 恢复而其他链路指标基本不变,才能形成较强的版本因果证据。
rollback = Metrics(
    version="v41-rollback",
    users=50100,
    impressions=482000,
    clicks=38560,
    missing_feature_rate=0.003,
    recall_coverage=0.96,
)

print(f"{rollback.version} ctr={ctr(rollback):.4f}")
预期输出:
v41-rollback ctr=0.0800如果回滚后 CTR 仍低,说明问题并不只在模型版本,应继续向实验配置、特征链路或后处理规则追查。效果故障的关键不是“最快找到一个能回滚的东西”,而是建立能重复执行、能排除误判的证据链。