
机器学习与深度学习 / 系统课时
把内容特征编码成物品向量
把内容特征编码成物品向量
这一节把可直接获得的标题、标签和类别变成可比较的物品向量,再用余弦相似度做内容召回。最终你会得到一条不依赖用户交互历史的候选通路,并能判断它是否真正补到了冷门物品。
学习目标
- 区分稀疏内容向量与稠密语义向量的适用边界
- 用 TF-IDF 与余弦相似度跑通一个内容相似召回
- 判断内容召回是否提升了交互稀疏物品的候选覆盖
从内容字段到检索向量
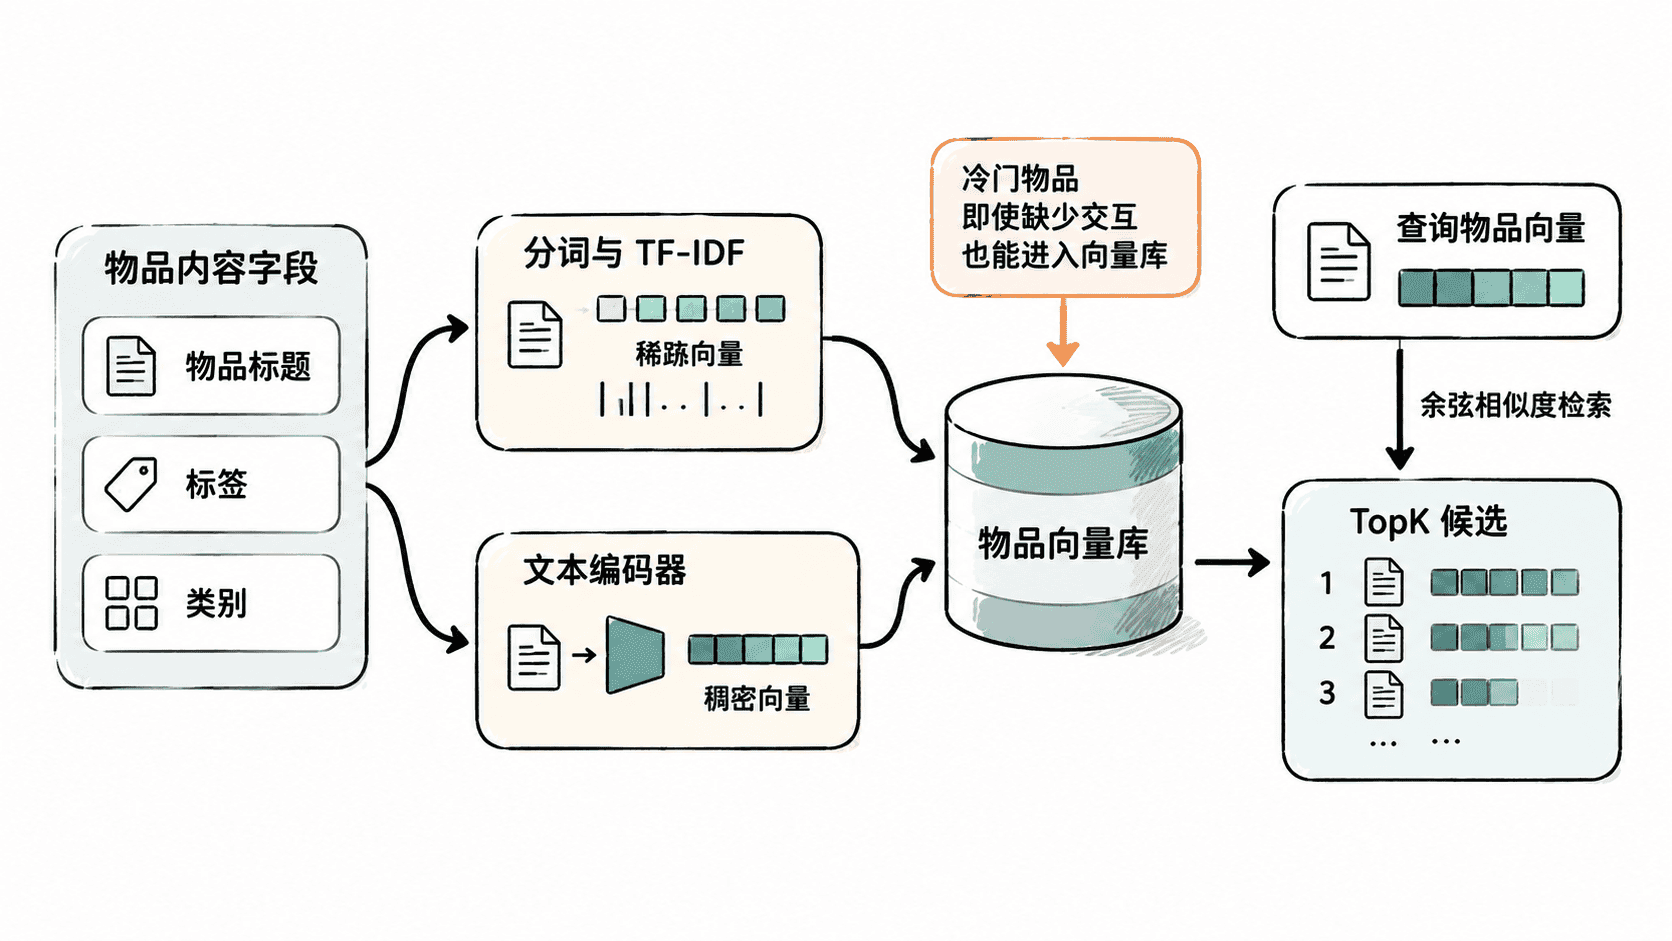
内容召回的关键不是“把字段拼起来”,而是让相似内容在同一向量空间中靠得更近。标题适合经过分词或文本编码器处理,标签适合直接作为离散特征,类别则最好加上独立前缀,避免与普通词项发生碰撞。
稀疏向量通常来自 one-hot、词频或 TF-IDF,优点是可解释、实现轻、适合标签与类别明确的场景。稠密向量通常由文本编码模型得到,维度固定,能表达近义词和语义相似,但需要额外的模型推理与向量索引能力。实际系统也常把两者分别召回,再在候选层合并。
用稀疏向量跑通内容相似召回
下面用标准库实现一个最小 TF-IDF 版本。示例把标题词、标签和类别一起编码,并以 i1 为查询物品计算其余物品的余弦相似度。i4 没有任何用户交互信息,但只要内容字段完整,仍能参与召回。
import math
from collections import Counter

items = [
    {"id": "i1", "title": "向量 检索 入门", "tags": ["推荐系统", "向量检索"], "category": "机器学习"},
    {"id": "i2", "title": "双塔 召回 实战", "tags": ["推荐系统", "双塔"], "category": "机器学习"},
    {"id": "i3", "title": "缓存 淘汰 策略", "tags": ["Redis", "缓存"], "category": "后端"},
    {"id": "i4", "title": "内容 召回 冷启动", "tags": ["推荐系统", "召回"], "category": "机器学习"},
]

def tokens(item):
    # 类别加前缀,避免“机器学习”既作为普通词又作为类别时发生语义混淆。
    return item["title"].split() + item["tags"] + [f"cat:{item['category']}"]

docs = [tokens(item) for item in items]
df = Counter()
for doc in docs:
    df.update(set(doc))

n = len(docs)
idf = {term: math.log((n + 1) / (freq + 1)) + 1 for term, freq in df.items()}

def encode(doc):
    tf = Counter(doc)
    raw = {term: tf[term] * idf[term] for term in tf}
    norm = math.sqrt(sum(value * value for value in raw.values()))
    # 先做 L2 归一化,后续点积就等价于余弦相似度。
    return {term: value / norm for term, value in raw.items()}

def cosine(left, right):
    return sum(value * right.get(term, 0.0) for term, value in left.items())

vectors = {item["id"]: encode(tokens(item)) for item in items}
query = vectors["i1"]

scores = sorted(
    (
        (item["id"], cosine(query, vectors[item["id"]]))
        for item in items
        if item["id"] != "i1"
    ),
    key=lambda pair: pair[1],
    reverse=True,
)

for item_id, score in scores:
    print(item_id, f"{score:.4f}")
预期输出
i4 0.1613
i2 0.1464
i3 0.0000
这个结果说明内容完全不同的 i3 被压到最低,而没有交互数据的 i4 仍能因为“推荐系统”“机器学习”等内容特征进入前列。这里的分数只用于演示相对顺序,生产环境通常还会设置最小相似度、TopK 和去重规则。
冷门覆盖要看新增了什么候选
验证内容召回时,不要只看平均相似度。更有价值的是把候选按物品交互量分桶,比较加入内容召回前后,低交互桶中有多少物品第一次进入候选集,同时检查这些新增候选是否仍与用户近期兴趣相关。
最直接的离线检查可以记录三项:候选物品覆盖率、冷门物品候选占比,以及最终被排序模型保留下来的冷门候选比例。如果覆盖上涨但这些候选几乎全部在排序阶段被淘汰,说明内容向量虽然“召回得更多”,却没有补到真正有价值的内容。
稀疏向量和稠密向量怎么选
标签体系稳定、类别质量高、需要强解释性时,稀疏向量往往已经足够,而且更新成本低。标题和描述自由度高、同义表达多时,稠密语义向量更容易找出“词不同但意思相近”的物品。
上线时通常不必二选一。可以让协同召回负责利用行为共现,让内容向量召回负责补冷启动和长尾,再统一进入排序。真正需要关注的不是某种向量是否更先进,而是它是否带来了原召回通路拿不到、同时又有相关性的候选。