
机器学习与深度学习 / 系统课时
排查超时与特征不一致
排查超时与特征不一致
推荐服务出现超时或结果突然漂移时,最忌讳只盯总耗时或模型分数。本节建立一条可复用的证据链:先按请求拆解链路耗时,再关联缓存和特征快照,最后通过降级或回滚验证根因是否消失。
学习目标
- 能用 p95、p99 与分阶段耗时定位尾延迟集中在哪个环节
- 能通过特征版本、时间戳和请求日志判断在线特征是否与预期一致
- 能在降级或回滚后用同一组指标验证服务是否真正恢复
先把一次请求拆成可定位的链路
排查超时不能只看接口总耗时。推荐请求通常依次经过网关、召回、特征读取、排序和结果组装,只要其中一个阶段偶发阻塞,就可能让平均值仍然正常,而 p99 明显恶化。
建议让每次请求都携带统一的 requestId,并记录各阶段的开始时间、结束时间、缓存命中情况、特征版本和最终状态。这样才能把“请求慢”“缓存未命中”和“特征变化”关联到同一条请求上。
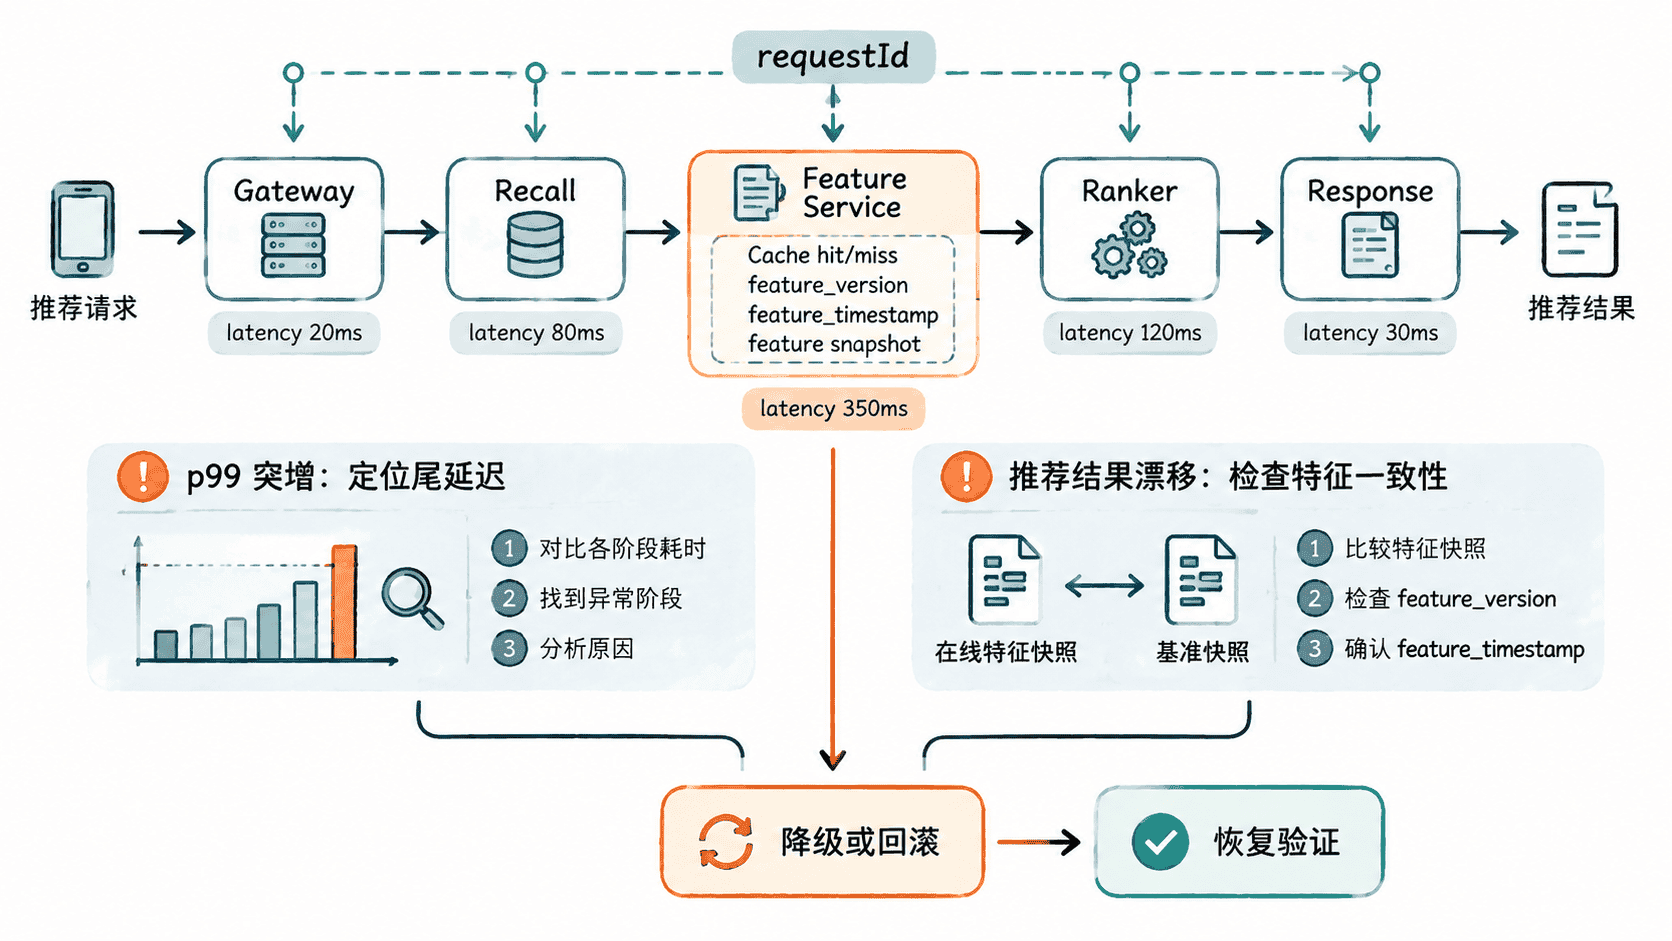
总耗时异常时,先比较各阶段的 p50、p95、p99,而不是直接重启服务。若只有特征阶段 p99 升高,应继续查远程特征服务、缓存穿透、热点 Key 或依赖超时;若所有阶段同时变慢,则更像线程池、网络、GC 或机器资源问题。
用缓存命中率解释尾延迟
缓存问题常表现为“绝大多数请求正常,少量请求特别慢”。平均耗时会掩盖这种现象,因此要把缓存命中率与慢请求逐条关联,而不是只看一个全局命中率。
下面的脚本模拟五次推荐请求,计算总耗时和各阶段 p99,并同时检查一次在线特征快照与基准快照的差异。脚本可独立运行。
import math

stages = {
    "gateway": [3, 4, 3, 4, 3],
    "recall": [12, 14, 13, 45, 15],
    "feature": [8, 9, 8, 120, 10],
    "rank": [20, 22, 21, 25, 20],
}
cache_hits = [True, True, True, False, True]

online_features = {
    "user_ctr": 0.21,
    "item_ctr": 0.14,
    "category_affinity": 0.73,
}
baseline_features = {
    "user_ctr": 0.18,
    "item_ctr": 0.14,
    "category_affinity": 0.73,
}

def percentile(values, p):
    ordered = sorted(values)
    index = max(0, math.ceil(len(ordered) * p) - 1)
    return ordered[index]

# 总耗时按同一次请求的各阶段相加,避免把不同请求的峰值错误拼接。
totals = [sum(items) for items in zip(*stages.values())]

for name, values in stages.items():
    print(f"{name} p99={percentile(values, 0.99)}ms")

print(f"total p99={percentile(totals, 0.99)}ms")
print(f"cache hit rate={sum(cache_hits) / len(cache_hits):.0%}")

for key, online_value in online_features.items():
    baseline_value = baseline_features[key]
    if online_value != baseline_value:
        print(f"feature mismatch: {key} online={online_value} baseline={baseline_value}")
预期输出
gateway p99=4ms
recall p99=45ms
feature p99=120ms
rank p99=25ms
total p99=194ms
cache hit rate=80%
feature mismatch: user_ctr online=0.21 baseline=0.18
这组结果已经形成两个明确线索:最慢请求的主要时间消耗集中在特征阶段,而且五次请求中恰好存在一次缓存未命中;同时 user_ctr 与基准快照不同。真实系统中应继续用相同 requestId 验证这两件事是否发生在同一请求上,不能仅凭时间接近就认定因果关系。
对比特征快照而不是只看模型输出
推荐结果异常时,只比较最终物品列表通常无法区分模型变化、特征变化和召回变化。更可靠的方法是在排序入口保存一份轻量特征快照,并至少带上 feature_version、feature_timestamp、特征来源和关键值。
重点检查三类不一致:同一个用户在相近时间使用了不同特征版本;实时特征时间戳明显落后于请求时间;线上取值与离线回放或基准快照不同。若特征来自多个存储,还要确认默认值逻辑是否一致,因为缓存未命中后走数据库或远程服务时,很容易触发另一套缺省规则。
如果只有特定机器或实例出现差异,还要继续比较配置版本、本地缓存更新时间和进程启动时间。相同模型版本并不代表相同特征输入,特征链路才是排序结果可复现的前提。
按证据顺序缩小根因
故障排查应保持固定顺序,避免一上来同时改缓存、模型和配置,导致最后无法确认哪项修改真正生效。
- 选择一批异常
requestId,确认超时或推荐漂移能够被日志复现。 - 对比网关、召回、特征、排序各阶段 p95 和 p99,先确定异常集中位置。
- 对慢请求检查缓存 hit/miss、远程依赖耗时和超时次数,判断是否存在缓存穿透或依赖抖动。
- 对结果异常请求比较特征版本、时间戳、关键值和默认值来源,确认是否存在快照差异。
- 根因明确后只执行一种最小变更,例如开启缓存降级、切换备用特征源或回滚特征版本。
- 使用原来的指标和请求样本重新验证,确认尾延迟和特征差异同时消失。
如果开启降级后 p99 立即恢复,但特征一致性仍未恢复,说明降级只解决了可用性,没有解决数据正确性。反过来,特征版本回滚后结果恢复但超时仍存在,则延迟问题应继续沿缓存或依赖链路排查。
用故障前后指标完成恢复验证
恢复验证至少要覆盖延迟、错误率、缓存和特征四组证据。只看到“接口又能访问了”还不足以宣布故障结束。
| 证据 | 故障期现象 | 恢复判定 |
|---|---|---|
| p95 / p99 延迟 | 尾延迟明显升高 | 回到历史稳定区间 |
| 超时与错误率 | 超时请求增加 | 连续观察窗口内恢复基线 |
| 缓存命中率 | 异常下降或波动 | 命中率恢复且慢请求不再集中于 miss |
| 特征版本与快照 | 版本混用或关键值不同 | 同类请求使用预期版本且差异消失 |
| 推荐结果 | 排序结果异常漂移 | 回放样本重新满足验收条件 |
最后保留故障发生时间、异常请求样本、关键日志、指标截图或导出数据、执行过的降级或回滚动作,以及恢复后的同口径指标。这样下一次再出现相似问题时,可以直接沿已有证据链判断是尾延迟、缓存异常还是特征不一致,而不是重新从猜测开始。