
机器学习与深度学习 / 系统课时
用 DIN 建模用户短期兴趣
用 DIN 建模用户短期兴趣
本节实现一个最小 DIN 风格排序模型:对同一份用户历史行为,针对当前候选物品计算不同注意力权重,再得到目标相关的兴趣向量。你会直接检查权重是否归一化,并理解为什么它比对历史 embedding 做固定平均更适合多兴趣和短期偏好场景。
学习目标
- 理解 DIN 为什么要让候选物品参与历史行为聚合
- 用 PyTorch 实现目标感知的注意力权重与兴趣向量
- 知道如何检查注意力是否真正聚焦到与候选相关的历史行为
固定平均为什么会丢掉短期兴趣
假设用户最近浏览过“跑鞋、咖啡机、机械键盘、运动袜”。当候选是跑鞋时,跑鞋和运动袜更值得关注;当候选变成键盘时,机械键盘应获得更高权重。若把四条历史 embedding 直接平均,不同候选得到的用户兴趣表示完全相同,多兴趣会被混成一个固定向量。
DIN 的核心就是把“当前候选”加入历史聚合过程。它先比较每条历史行为与候选物品的关系,再生成注意力分数,最终对历史 embedding 加权求和。这个兴趣向量是面向目标物品动态计算的,因此同一个用户面对不同候选会得到不同表示。
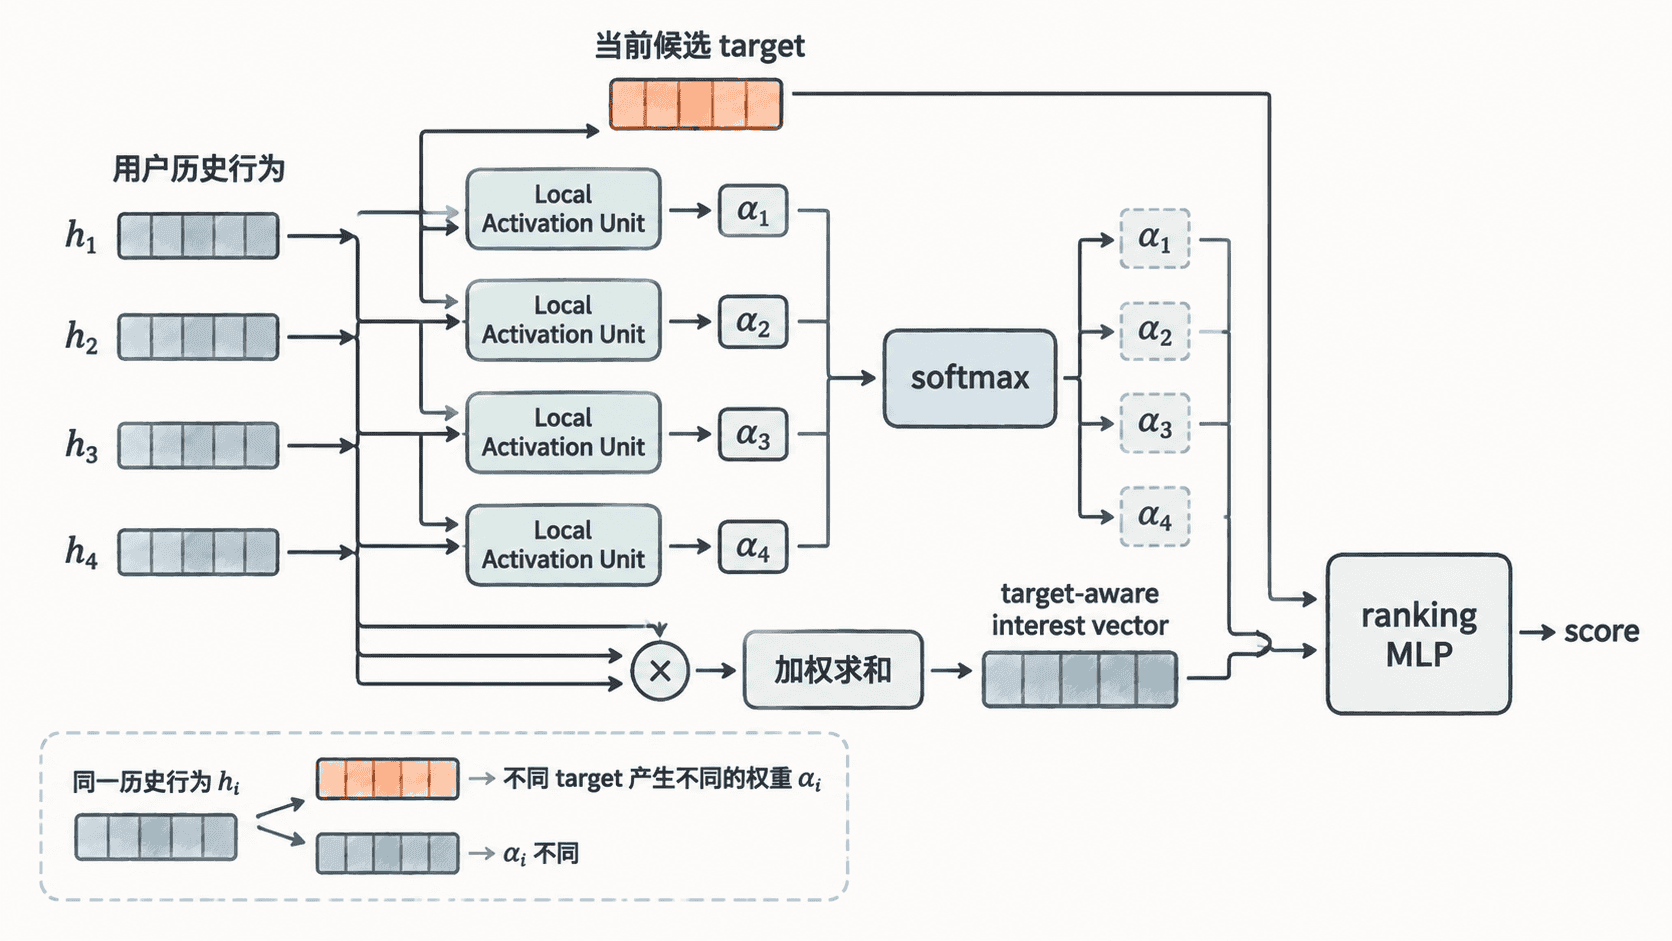
常见 DIN 实现会把历史向量 、目标向量 以及它们的差与逐元素乘积拼接后送入小型 MLP:
得到每条历史的分数后,再结合 padding mask 做 softmax,最后计算加权和。这样模型不必假设“所有历史行为同等重要”。
最小可运行实现
下面的代码用一个 Local Activation Unit 计算注意力。历史序列长度固定为 4,mask 用来排除补齐位置;真实系统通常还会加入用户画像、上下文和其他物品特征。
import torch
import torch.nn as nn

torch.manual_seed(11)

class DINAttention(nn.Module):
    def __init__(self, embed_dim):
        super().__init__()
        self.scorer = nn.Sequential(
            nn.Linear(embed_dim * 4, 32),
            nn.ReLU(),
            nn.Linear(32, 1),
        )

    def forward(self, history, target, mask):
        # history: [batch, seq_len, dim],target: [batch, dim]
        target_expanded = target.unsqueeze(1).expand_as(history)
        features = torch.cat([
            history,
            target_expanded,
            history - target_expanded,
            history * target_expanded,
        ], dim=-1)

        scores = self.scorer(features).squeeze(-1)
        scores = scores.masked_fill(~mask, -1e9)
        weights = torch.softmax(scores, dim=1)

        # 目标相关兴趣向量由历史行为按注意力权重聚合
        interest = torch.sum(history * weights.unsqueeze(-1), dim=1)
        return interest, weights

batch, seq_len, dim = 2, 4, 8
history = torch.randn(batch, seq_len, dim)
target = torch.randn(batch, dim)
mask = torch.tensor([
    [True, True, True, False],
    [True, True, True, True],
])

attention = DINAttention(dim)
interest, weights = attention(history, target, mask)

print("interest shape:", tuple(interest.shape))
print("weights shape:", tuple(weights.shape))
print("valid weights sum to one:", bool(
    torch.allclose(weights.sum(dim=1), torch.ones(batch), atol=1e-6)
))
print("padding weight is zero:", float(weights[0, 3]) == 0.0)
预期输出:
interest shape: (2, 8)
weights shape: (2, 4)
valid weights sum to one: True
padding weight is zero: True
这段代码验证了 DIN 最关键的数据流:每条历史都会与候选共同参与打分,合法位置的权重和为 1,padding 不会污染兴趣向量。若要完成点击率模型,可把 interest、target、用户画像和上下文特征拼接后送入最终 MLP,输出点击 logit。
怎样判断注意力真的在工作
注意力权重可观察,但不能把它直接当作因果解释。工程上更有价值的检查是:给同一个用户历史替换不同候选,确认权重分布随目标变化;再做离线对照,比较固定平均池化与 DIN 目标感知池化的 AUC、LogLoss 和分兴趣人群效果。
还要检查权重是否长期塌缩到某个固定位置。例如所有样本都把最大权重给最近一次行为,可能说明“位置”压过了“语义相关性”;如果所有权重近似均匀,则 Local Activation Unit 可能没有学到区分能力。可以按候选类目抽样查看 Top-K 高权重历史,并结合时间间隔、类目一致性做统计。
多兴趣与短期偏好的边界
DIN 特别适合“历史行为丰富、候选相关性差异大”的排序阶段,但它仍依赖高质量行为序列。历史过短时,注意力没有足够对象可选;历史过长时,计算和噪声都会增加,通常需要截断最近行为或按业务保留高价值事件。
若业务中的兴趣天然分成多个长期簇,单个 DIN 加权向量也可能把多个兴趣再次压成一个向量,此时可以继续考虑多兴趣建模。DIN 的第一价值仍是把“用户兴趣不是固定向量,而是相对于当前候选动态变化”这件事真正放进排序模型。