
机器学习与深度学习 / 系统课时
用探索策略发现潜在兴趣
用探索策略发现潜在兴趣
纯利用策略总是选择当前分数最高的内容,会让新内容和未知兴趣长期得不到反馈。本节用 epsilon-greedy 和 UCB 构造小比例探索流量,并把安全过滤、探索预算、延迟奖励和统计更新放进同一条线上决策链。
学习目标
- 区分 exploitation 与 exploration,并理解为什么推荐系统需要主动探索
- 能用 epsilon-greedy 和 UCB 为安全候选分配少量探索机会
- 识别探索预算、奖励延迟和安全约束对线上实验的影响
探索不是随机打乱推荐结果
探索的目标不是“随机给用户看差内容”,而是在可接受风险范围内,为不确定但有潜力的候选获取信息。线上通常先完成合规、库存、内容质量和业务规则过滤,再在剩余安全候选中决定哪些位置用于利用,哪些位置用于探索。
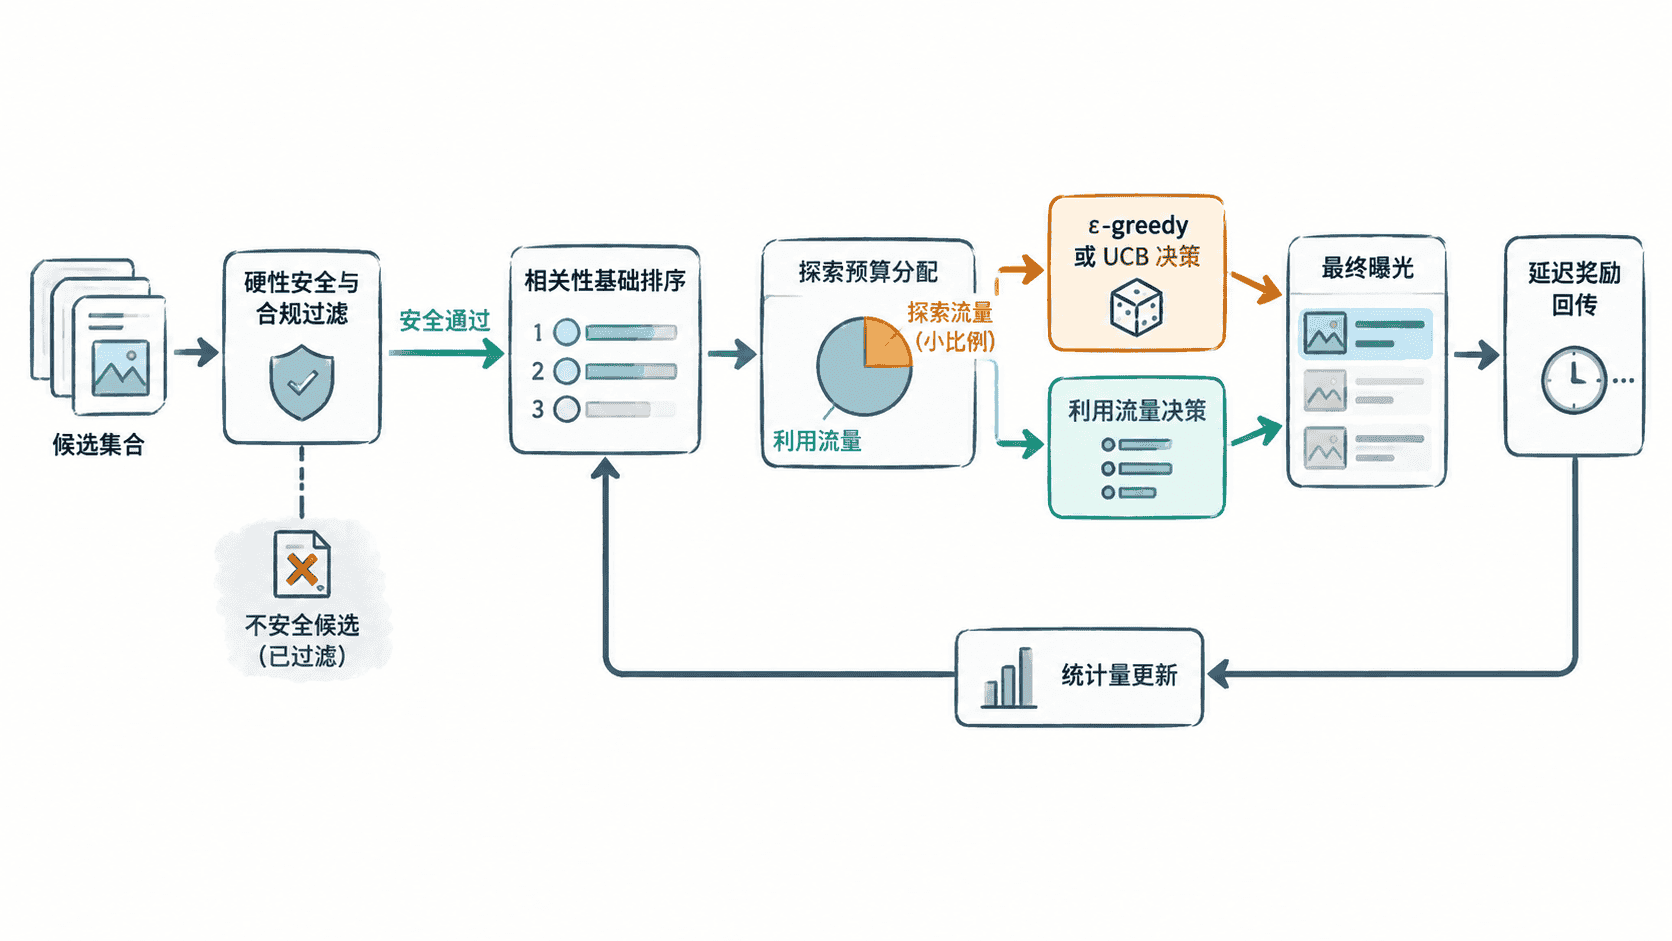
这样做有两个好处:第一,安全约束不会因为“探索”被绕过;第二,探索预算可独立控制,例如只占 5% 到 10% 的流量,而不是让整个列表进入随机状态。
epsilon-greedy 用固定预算换取新信息
epsilon-greedy 最容易上线。每次决策以 的概率选择当前平均奖励最高的候选,以 的概率从安全候选中探索。它的优点是实现简单、预算直观,缺点是探索部分没有区分“已经证明较差”和“只是样本少”的候选。
因此,epsilon 不宜长期固定。冷启动阶段可以稍高,统计逐渐稳定后再降低;高风险页面则可以把探索限制在特定槽位、特定内容池或低价值流量中。
UCB 把不确定性直接加入分数
UCB 会同时考虑当前平均奖励和统计不确定性。一个常见形式是:
其中 是候选历史平均奖励, 是该候选的曝光次数, 是全部候选曝光次数, 控制探索强度。样本少的候选会获得更大的置信上界奖励,因此 UCB 比均匀随机探索更偏向“值得继续验证”的对象。
下面的可运行示例先过滤不安全候选,再分别执行一次 epsilon-greedy 和一次 UCB 选择。固定随机种子只是为了让示例输出可复现。
import math
import random

arms = [
    {"id": "A", "n": 100, "reward": 40.0, "safe": True},
    {"id": "B", "n": 20, "reward": 9.0, "safe": True},
    {"id": "C", "n": 5, "reward": 3.0, "safe": True},
    {"id": "D", "n": 2, "reward": 2.0, "safe": False},
]

safe_arms = [arm for arm in arms if arm["safe"]]

rng = random.Random(1)
epsilon = 0.20

if rng.random() < epsilon:
    epsilon_pick = rng.choice(safe_arms)["id"]
    epsilon_mode = "explore"
else:
    epsilon_pick = max(
        safe_arms,
        key=lambda arm: arm["reward"] / arm["n"],
    )["id"]
    epsilon_mode = "exploit"

total_n = sum(arm["n"] for arm in safe_arms)
ucb_scores = {}

for arm in safe_arms:
    mean = arm["reward"] / arm["n"]
    bonus = 0.5 * math.sqrt(math.log(total_n) / arm["n"])
    ucb_scores[arm["id"]] = mean + bonus

ucb_pick = max(ucb_scores, key=ucb_scores.get)

print(f"epsilon_greedy: {epsilon_mode} -> {epsilon_pick}")
for arm_id in sorted(ucb_scores):
    print(f"ucb[{arm_id}]={ucb_scores[arm_id]:.4f}")
print("ucb_pick:", ucb_pick)
预期输出:
epsilon_greedy: explore -> A
ucb[A]=0.5099
ucb[B]=0.6957
ucb[C]=1.0913
ucb_pick: C
epsilon-greedy 这次进入探索分支后随机选中 A;UCB 则认为 C 的样本量最少且当前平均奖励不差,因此给出更高上界分数。被标记为不安全的 D 即使历史奖励很高,也不会进入任何探索选择。
处理奖励延迟与线上护栏
推荐场景的奖励经常不是即时点击。收藏、购买、次日留存可能在分钟甚至数天后才出现,如果曝光后立刻把“尚未回传”记为 0,就会系统性低估延迟转化内容。工程上应为每次探索曝光保留请求或曝光标识,等归因窗口结束后再更新对应 arm 的奖励统计。
探索还必须有护栏:限制最大探索比例、限制可探索内容池、限制用户频次,并单独监控投诉率、跳失率、转化率和延迟奖励覆盖率。若安全指标越界,应先收缩探索预算,而不是等待算法自行恢复。
epsilon-greedy 适合需要快速落地和明确流量预算的场景;UCB 更适合候选数可控、奖励统计稳定且希望把探索集中到高不确定性候选的场景。无论选择哪一种,真正有效的探索都应建立在“先过滤风险、再分配预算、最后按正确归因更新统计”的闭环上。