
机器学习与深度学习 / 系统课时
把行为日志整理成隐式反馈
把行为日志整理成隐式反馈
推荐系统拿到的通常不是明确评分,而是浏览、点击、收藏、购买等行为日志。本节把这些事件清洗、赋权并聚合成可训练的隐式反馈,同时保留事件时间与顺序,避免后续召回、排序和离线回放失去真实的用户行为轨迹。
学习目标
- 从行为日志中提取用户、物品、时间和行为强度
- 正确处理重复事件、缺失字段和异常时间
- 同时产出事件级数据与用户物品级隐式反馈
从行为事件得到训练信号
隐式反馈没有“用户给物品打了几分”这样的直接标签,只能根据行为推断兴趣强度。最简单的做法是给不同行为设置权重,例如浏览为 1、点击为 2、收藏为 3、购买为 5,再把同一用户对同一物品的有效行为累积起来。
权重表达的是业务中的相对强弱,而不是客观概率。购买通常比浏览更能表示偏好,但不能因此把权重无限放大,否则少量强行为会完全淹没其他信号。正式训练前应通过离线指标和线上实验校准这些值。
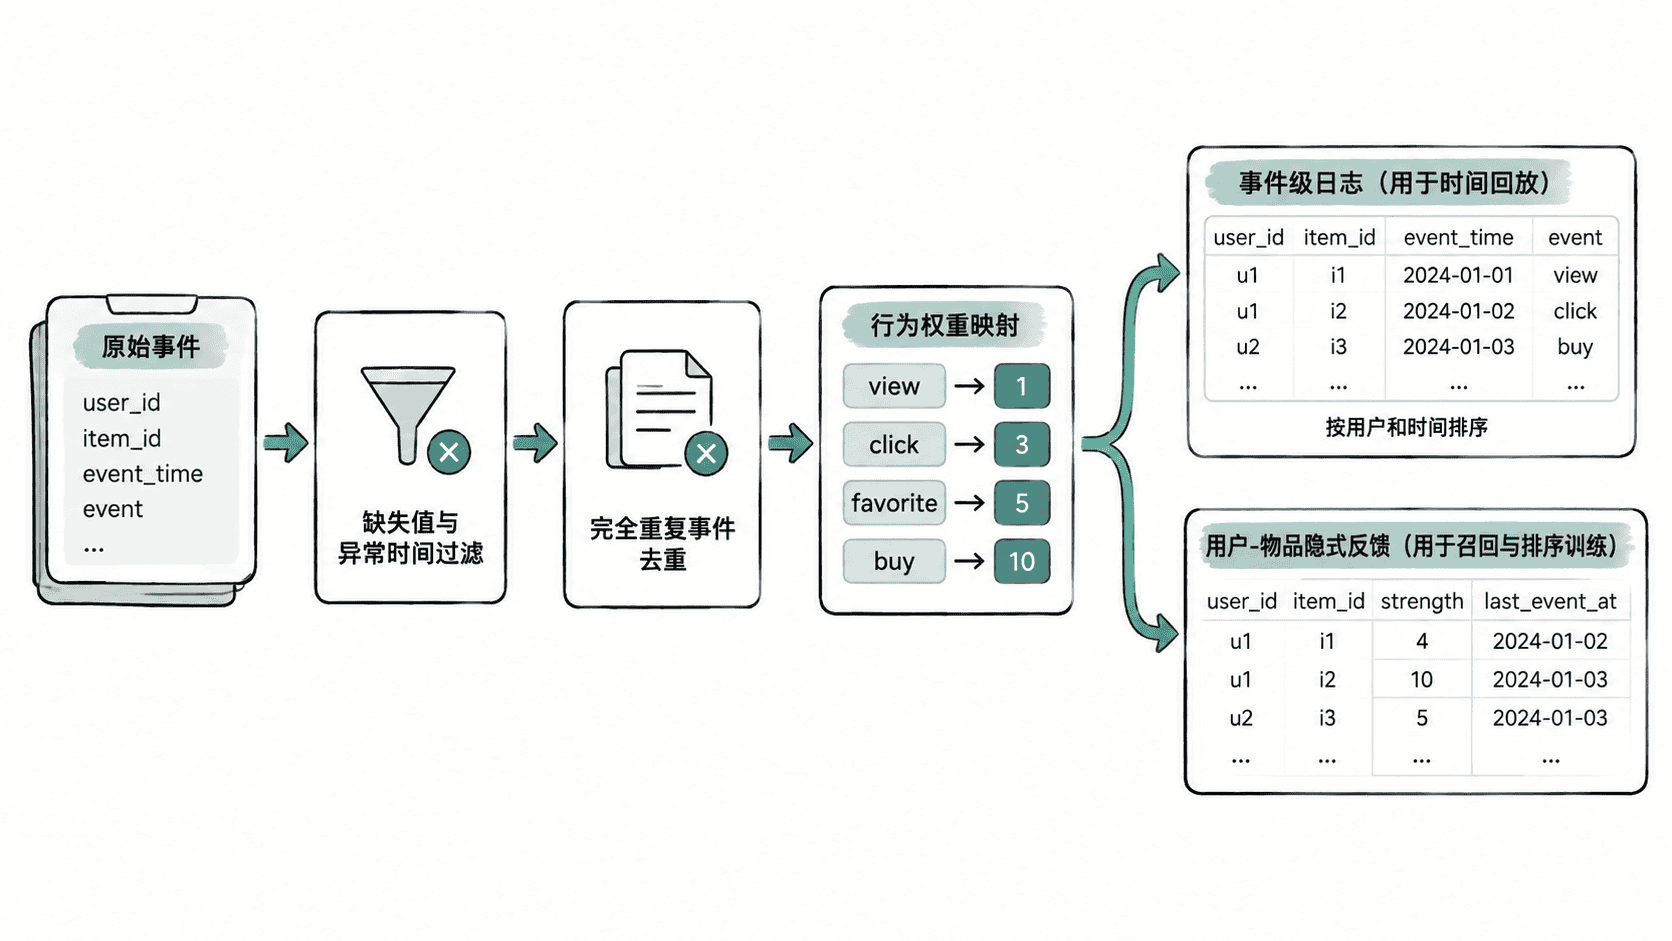
清洗并保留事件顺序
下面的示例故意加入完全重复事件、缺失物品和非法时间。清洗顺序很重要:先解析时间并删除关键字段缺失的数据,再去掉完全重复事件,之后映射行为权重,最后按用户和事件时间排序并生成用户内部的事件序号。
import pandas as pd

rows = [
    ('u1', 'i1', '2026-09-01 10:00:00', 'view'),
    ('u1', 'i1', '2026-09-01 10:02:00', 'click'),
    ('u1', 'i1', '2026-09-01 10:02:00', 'click'),
    ('u1', 'i2', '2026-09-01 10:05:00', 'buy'),
    ('u2', 'i1', '2026-09-01 10:06:00', 'view'),
    ('u2', 'i3', '2026-09-01 10:08:00', 'favorite'),
    ('u2', None, '2026-09-01 10:09:00', 'click'),
    ('u2', 'i3', 'bad-time', 'click'),
]

df = pd.DataFrame(rows, columns=['user_id', 'item_id', 'event_time', 'event'])
weights = {'view': 1.0, 'click': 2.0, 'favorite': 3.0, 'buy': 5.0}

# 非法时间转为 NaT,随后与其他关键字段缺失记录一起删除。
df['event_time'] = pd.to_datetime(df['event_time'], errors='coerce')
clean = (
    df.dropna(subset=['user_id', 'item_id', 'event_time'])
      .drop_duplicates(['user_id', 'item_id', 'event_time', 'event'])
      .assign(weight=lambda x: x['event'].map(weights))
      .dropna(subset=['weight'])
      .sort_values(['user_id', 'event_time'])
      .reset_index(drop=True)
)

# 顺序字段供后续时间切分和历史行为回放使用。
clean['event_order'] = clean.groupby('user_id').cumcount() + 1

interactions = (
    clean.groupby(['user_id', 'item_id'], as_index=False)
         .agg(strength=('weight', 'sum'), last_event_at=('event_time', 'max'))
         .sort_values(['user_id', 'item_id'])
)

clean_out = clean.copy()
clean_out['event_time'] = clean_out['event_time'].dt.strftime('%Y-%m-%d %H:%M:%S')
interactions['last_event_at'] = interactions['last_event_at'].dt.strftime('%Y-%m-%d %H:%M:%S')

print(clean_out[['user_id', 'item_id', 'event_time', 'event', 'weight', 'event_order']].to_dict('records'))
print(interactions.to_dict('records'))
预期输出:重复点击只保留一次,缺失物品和非法时间被删除;同一用户对同一物品的行为强度被累积。
[{'user_id': 'u1', 'item_id': 'i1', 'event_time': '2026-09-01 10:00:00', 'event': 'view', 'weight': 1.0, 'event_order': 1}, {'user_id': 'u1', 'item_id': 'i1', 'event_time': '2026-09-01 10:02:00', 'event': 'click', 'weight': 2.0, 'event_order': 2}, {'user_id': 'u1', 'item_id': 'i2', 'event_time': '2026-09-01 10:05:00', 'event': 'buy', 'weight': 5.0, 'event_order': 3}, {'user_id': 'u2', 'item_id': 'i1', 'event_time': '2026-09-01 10:06:00', 'event': 'view', 'weight': 1.0, 'event_order': 1}, {'user_id': 'u2', 'item_id': 'i3', 'event_time': '2026-09-01 10:08:00', 'event': 'favorite', 'weight': 3.0, 'event_order': 2}]
[{'user_id': 'u1', 'item_id': 'i1', 'strength': 3.0, 'last_event_at': '2026-09-01 10:02:00'}, {'user_id': 'u1', 'item_id': 'i2', 'strength': 5.0, 'last_event_at': '2026-09-01 10:05:00'}, {'user_id': 'u2', 'item_id': 'i1', 'strength': 1.0, 'last_event_at': '2026-09-01 10:06:00'}, {'user_id': 'u2', 'item_id': 'i3', 'strength': 3.0, 'last_event_at': '2026-09-01 10:08:00'}]
为什么不能只保存聚合结果
strength 很适合协同过滤、召回候选生成或作为排序特征,但聚合会抹掉事件发生的先后关系。如果只保存一行 u1-i1-strength=3,以后无法判断浏览和点击发生在训练截止时间之前还是之后,也无法按历史时刻重建用户画像。
因此工程上通常保留两层数据:事件级表作为事实来源,保存原始时间和事件顺序;训练数据再从事件级表按指定时间窗口派生。这样改变切分日期、行为权重或去重策略时,都可以重新计算,而不必依赖已经丢失时间信息的聚合表。
去重和异常处理的边界
完全相同的用户、物品、时间和行为通常可以视为重复上报,但同一用户连续两次点击不一定是重复数据。若只按 user_id 与 item_id 去重,会错误删除真实的重复消费行为。生产系统最好使用事件 ID 去重;没有事件 ID 时,再结合时间窗口和业务语义制定规则。
验收这一步时,应确认关键字段没有空值、非法时间已被隔离、事件顺序单调、未知行为不会静默得到错误权重,并且事件级数据仍能重建聚合结果。做到这些后,隐式反馈才既能用于当前模型训练,也能安全支持后续按时间切分和离线回放。