
机器学习与深度学习 / 系统课时
跑通热门推荐作为效果下限
跑通热门推荐作为效果下限
本节要得到一个可重复的热门 TopK 基线:热度只从训练集统计,推荐前过滤用户已交互物品,并同时输出命中、覆盖率和平均热门度。它不追求个性化,而是给后续召回、排序模型提供一把稳定的比较尺子。
学习目标
- 用训练集物品交互次数生成全局热门 TopK,并正确过滤已交互物品
- 用 Recall@K、覆盖率和平均热门度同时观察效果与头部偏置
- 识别数据泄漏、候选不足和只看命中指标这三类常见基线错误
先把基线边界固定下来
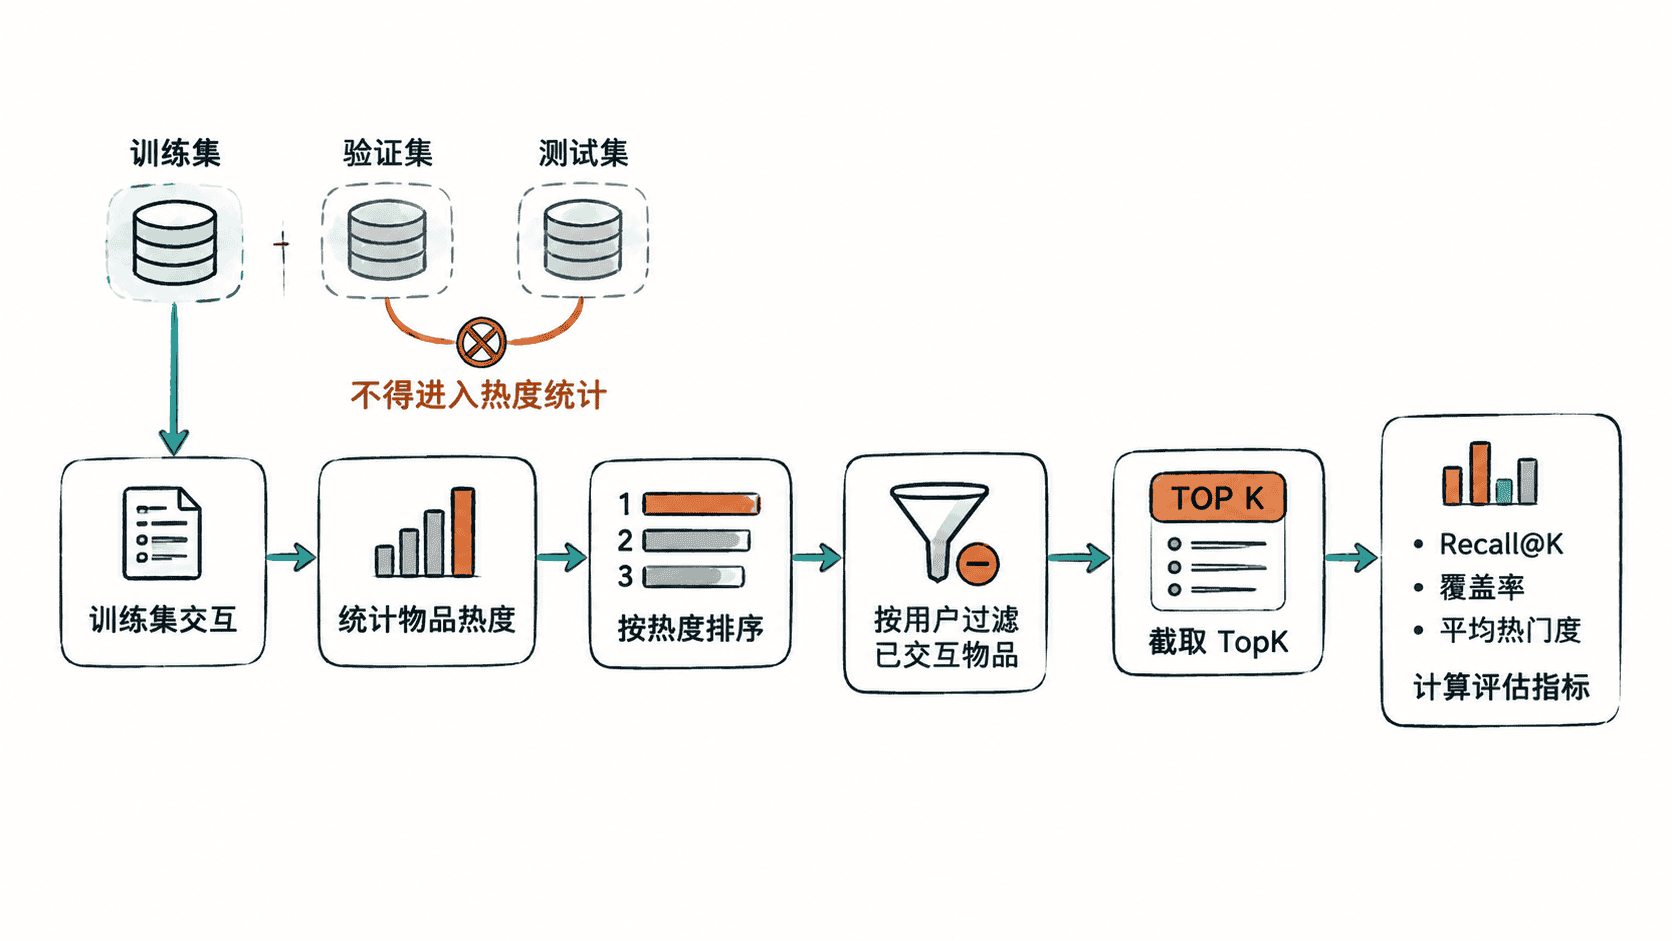
热门推荐的规则很简单:统计训练集中每个物品的交互次数,按热度降序排列;给某个用户推荐时,从这个全局序列中跳过他已经交互过的物品,直到取满 K 个或候选耗尽。
关键点是热度只能由训练集计算。如果把验证集或测试集交互也计入热度,相当于提前看到了未来行为,后面的 Recall@K 会被虚高。热门推荐因此不只是几行排序代码,它同时检查了数据切分、过滤和评估链路是否可信。
跑通一个可验证的 TopK 实现
下面的示例使用 4 个用户、5 个物品。测试集只用于检查命中,不参与热门度统计;同热度物品再按物品 ID 排序,保证多次运行结果一致。
from collections import Counter

train = {
    'u1': ['A', 'B', 'C'],
    'u2': ['A', 'B', 'D'],
    'u3': ['A', 'C', 'D'],
    'u4': ['A', 'B', 'E'],
}
test = {'u1': 'D', 'u2': 'C', 'u3': 'B', 'u4': 'D'}
TOP_K = 2


def build_popularity(interactions):
    return Counter(item for items in interactions.values() for item in items)


def recommend(seen, popularity, k):
    ranked = sorted(popularity, key=lambda item: (-popularity[item], item))
    return [item for item in ranked if item not in seen][:k]


def evaluate(recs, popularity):
    catalog = set(popularity)
    hits = sum(test[user] in recs[user] for user in test)
    recommended = [item for items in recs.values() for item in items]
    recall = hits / len(test)
    coverage = len(set(recommended)) / len(catalog)
    avg_popularity = sum(popularity[item] for item in recommended) / len(recommended)
    return recall, coverage, avg_popularity


def main():
    popularity = build_popularity(train)
    recs = {user: recommend(set(items), popularity, TOP_K) for user, items in train.items()}

    print('popularity:', dict(sorted(popularity.items())))
    for user in sorted(recs):
        print(f'{user}: {recs[user]}')

    recall, coverage, avg_popularity = evaluate(recs, popularity)
    print(f'recall@{TOP_K}: {recall:.2f}')
    print(f'coverage: {coverage:.2f}')
    print(f'avg_popularity: {avg_popularity:.2f}')


if __name__ == '__main__':
    main()
预期输出
popularity: {'A': 4, 'B': 3, 'C': 2, 'D': 2, 'E': 1}
u1: ['D', 'E']
u2: ['C', 'E']
u3: ['B', 'E']
u4: ['C', 'D']
recall@2: 1.00
coverage: 0.80
avg_popularity: 1.75
这里的高 Recall@2 只是这个极小样例的结果,不代表热门推荐在真实数据上也会很强。真正有价值的是整条链路可复现:过滤正确、K 值明确、指标口径固定,后续算法才能在同一条件下比较。
不要只盯着命中指标
Recall@K 反映测试目标是否出现在推荐列表里,但热门推荐天然偏向头部。如果只看命中,很容易得到“推荐的全是爆款也没问题”的错误结论。因此至少同时记录两个辅助指标。
覆盖率定义为“被推荐过的不同物品数 / 训练目录物品数”,它能暴露推荐结果是否长期挤在少量头部物品上。平均热门度则统计推荐列表中物品的训练集交互次数均值;在同一数据集、同一切分下,它越高,通常意味着越依赖热门物品。
候选不足时保持规则正确
当用户已经看过大量热门物品时,过滤后可能不足 K 个。不要为了凑满列表把已交互物品重新塞回去,否则离线指标和线上体验都会被污染。更合理的做法是允许基线返回少于 K 个,或者在真实系统中接入更大的候选目录、分层热门榜或其他召回源补足。
这个热门基线达到可用状态的标准不是“指标够高”,而是训练数据无泄漏、已交互过滤正确、TopK 结果稳定、命中与覆盖/热门度能一起复现。后续 UserCF、ItemCF 或向量召回若不能稳定超过它,就应该先检查算法和评估链路,而不是急着上线更复杂的模型。