
机器学习与深度学习 / 系统课时
给高频行为降低相似度偏置
给高频行为降低相似度偏置
这一课处理 ItemCF 中常见的高频偏置:活跃用户会一次制造大量物品对,热门物品又天然获得更多共现。我们给单次共现和热门候选加入惩罚,并用排名与长尾指标验证结果是否更个性化。
学习目标
- 能识别活跃用户和热门物品如何放大 ItemCF 共现统计。
- 能在共现贡献与相似度阶段加入可调节的惩罚项。
- 能用长尾覆盖和用户间列表差异验证惩罚是否有效。
高频偏置从哪里产生
如果一个高活跃用户一次交互 100 个物品,他会产生大量物品对;这些共现并不一定代表强兴趣相似。另一方面,热门物品拥有更多交互用户,即便做了基础归一化,也可能凭借更稳定、更密集的共现进入大量用户的候选集。
一种直接做法是把用户 u 对每个物品对的贡献从 1 改为 :用户交互越多,单个共现贡献越小。随后还可以对候选物品频次施加轻度惩罚,例如把相似度再除以 ,其中 beta 常从较小值开始离线搜索。
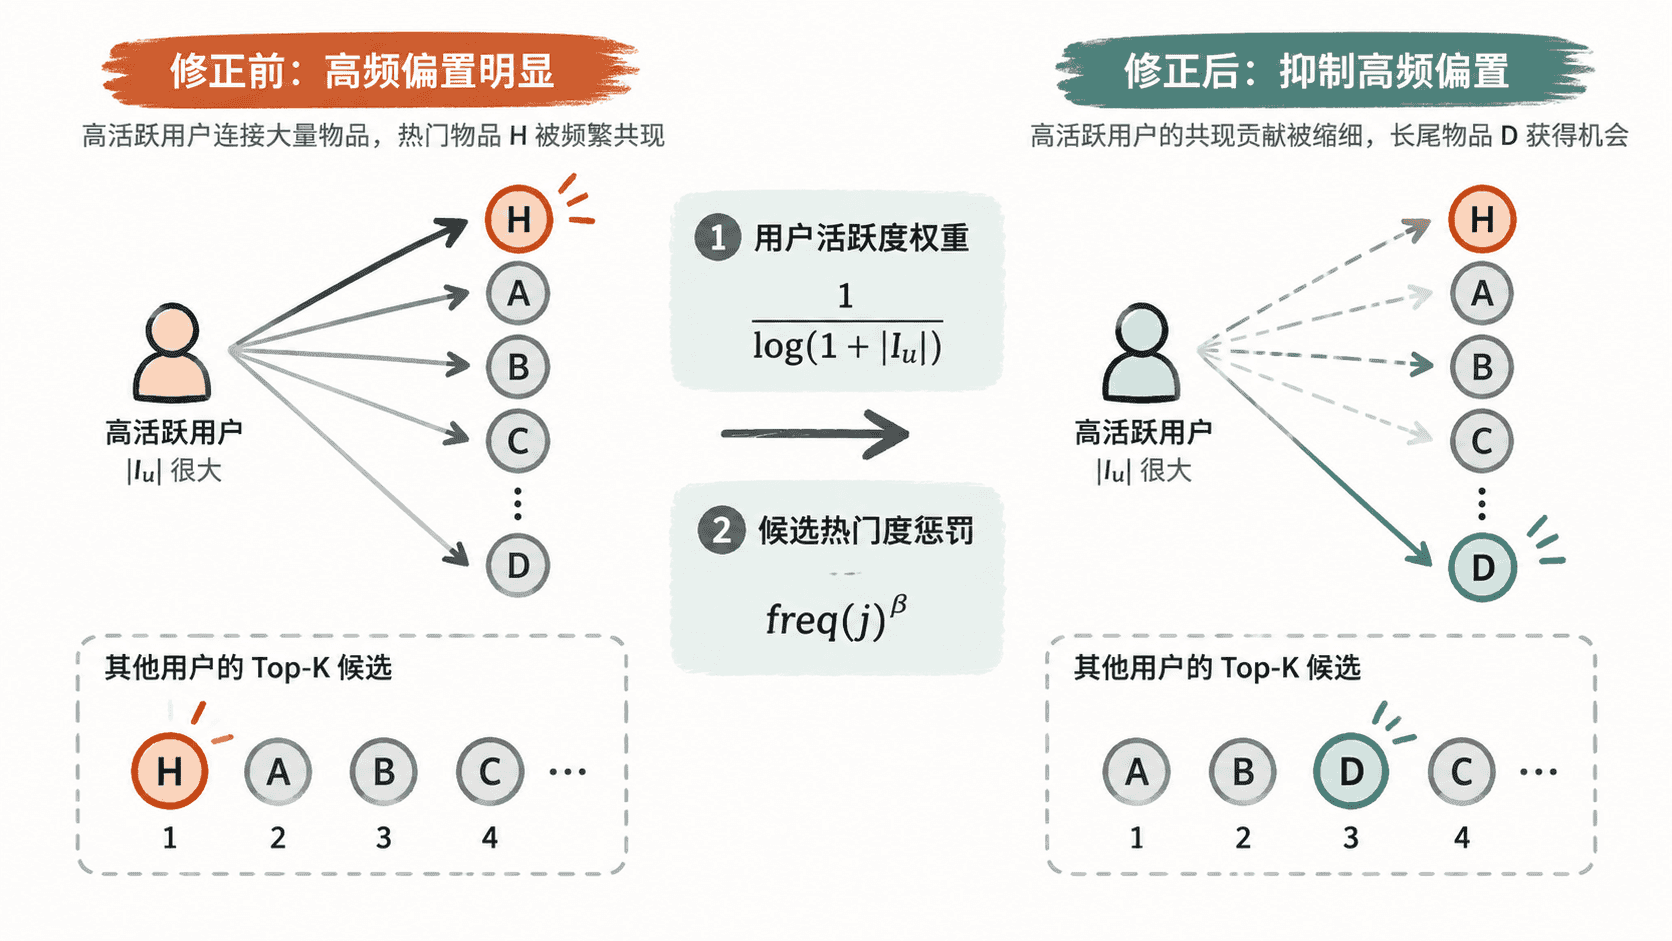
同时加入活跃度与热门度惩罚
下面用聚合后的共现事件演示两层修正。co_events 保存种子物品 A 与候选物品共现时对应用户的活跃度;生产环境中这些值应直接从原始行为日志聚合,而不是手工填写。
from math import log, sqrt

seed_freq = 10
item_freq = {'H': 20, 'B': 12, 'C': 8, 'D': 2}
co_events = {
    'H': [20] * 10,  # H 的共现主要来自高活跃用户
    'B': [2] * 6,
    'C': [2] * 4,
    'D': [2] * 2,
}

baseline = {}
penalized = {}
beta = 0.25
for item, activities in co_events.items():
    raw_co = len(activities)
    baseline[item] = raw_co / sqrt(seed_freq * item_freq[item])

    # 高频用户每次共现的贡献更小,防止一个用户制造过多物品对
    weighted_co = sum(1 / log(1 + activity) for activity in activities)
    normalized = weighted_co / sqrt(seed_freq * item_freq[item])
    # 再轻度惩罚热门候选;beta 应通过离线实验选择
    penalized[item] = normalized / (item_freq[item] ** beta)

rank = lambda scores: [k for k, _ in sorted(scores.items(), key=lambda x: (-x[1], x[0]))]
before = rank(baseline)
after = rank(penalized)
tail = {'D'}
print('baseline=', before)
print('penalized=', after)
print('tail_top3_before=', len(set(before[:3]) & tail) / 3)
print('tail_top3_after=', len(set(after[:3]) & tail) / 3)
预期输出
baseline= ['H', 'B', 'C', 'D']
penalized= ['D', 'B', 'C', 'H']
tail_top3_before= 0.0
tail_top3_after= 0.3333333333333333
这个例子里,热门物品 H 原本排第一;由于它的共现主要来自高活跃用户,并且自身频次较高,两次惩罚后降到第四。低频物品 D 进入 Top-3,因此示例中的长尾占比从 0 提升到约 0.33。
参数不要靠直觉一次定死
惩罚越强并不一定越好。beta 太大时,极冷物品可能因为分母很小被过度抬高;活跃度惩罚过强,也可能错误压低真正有稳定兴趣的重度用户。工程上应在固定训练集和验证集上搜索参数,并至少同时记录 Recall@K、长尾覆盖、候选覆盖率和热门物品占比。
验证个性化有没有真的提升
长尾覆盖只回答“是否更多地触达低频物品”,还不能证明用户之间更有差异。可以对不同用户的 Top-K 候选集合计算 Jaccard 距离:两个用户列表交集越小、并集越大,距离越高,说明候选更不雷同。评估时应比较惩罚前后的平均用户间距离,而不是只看单个用户案例。
同时要防止指标互相欺骗:如果个性化距离大幅上升但 Recall@K 明显下降,说明系统只是变得更随机;如果 Recall@K 不变且长尾覆盖、用户间距离同步提升,才更像是成功削弱了高频偏置。合理的目标不是“打压热门”,而是让热门度不再替代真正的协同关系。