
机器学习与深度学习 / 系统课时
批量推理降低模型服务开销
批量推理降低模型服务开销
排序模型逐候选调用时,每次 RPC、张量准备和模型调度都会重复付出固定成本。批量推理把同一请求中的候选特征组装成一个 batch,一次完成模型前向计算;但 batch 过大也会增加排队、内存占用和 P95 延迟。本节给出批量推理的实现方式和压测方法,找出吞吐提升开始反噬尾延迟的拐点。
学习目标
- 把候选特征组装成批量输入,并保持候选与模型分数一一对应。
- 理解 batch size 对吞吐、P95 延迟和内存占用的共同影响。
- 通过压力测试选择安全批大小,并限制排队时间与最大批量。
批量推理省掉了什么
假设一个请求有 100 个候选。如果逐个候选调用模型 100 次,模型服务会重复执行序列化、RPC、运行时调度和 kernel 启动等固定操作;批量后,这些固定成本只发生一次或少量几次,计算设备也更容易获得较高利用率。
批量输入通常可以表示为形状为 的二维张量,其中 是候选数量, 是每个候选的特征数。模型一次返回长度为 的分数向量,再按原候选顺序回填分数。
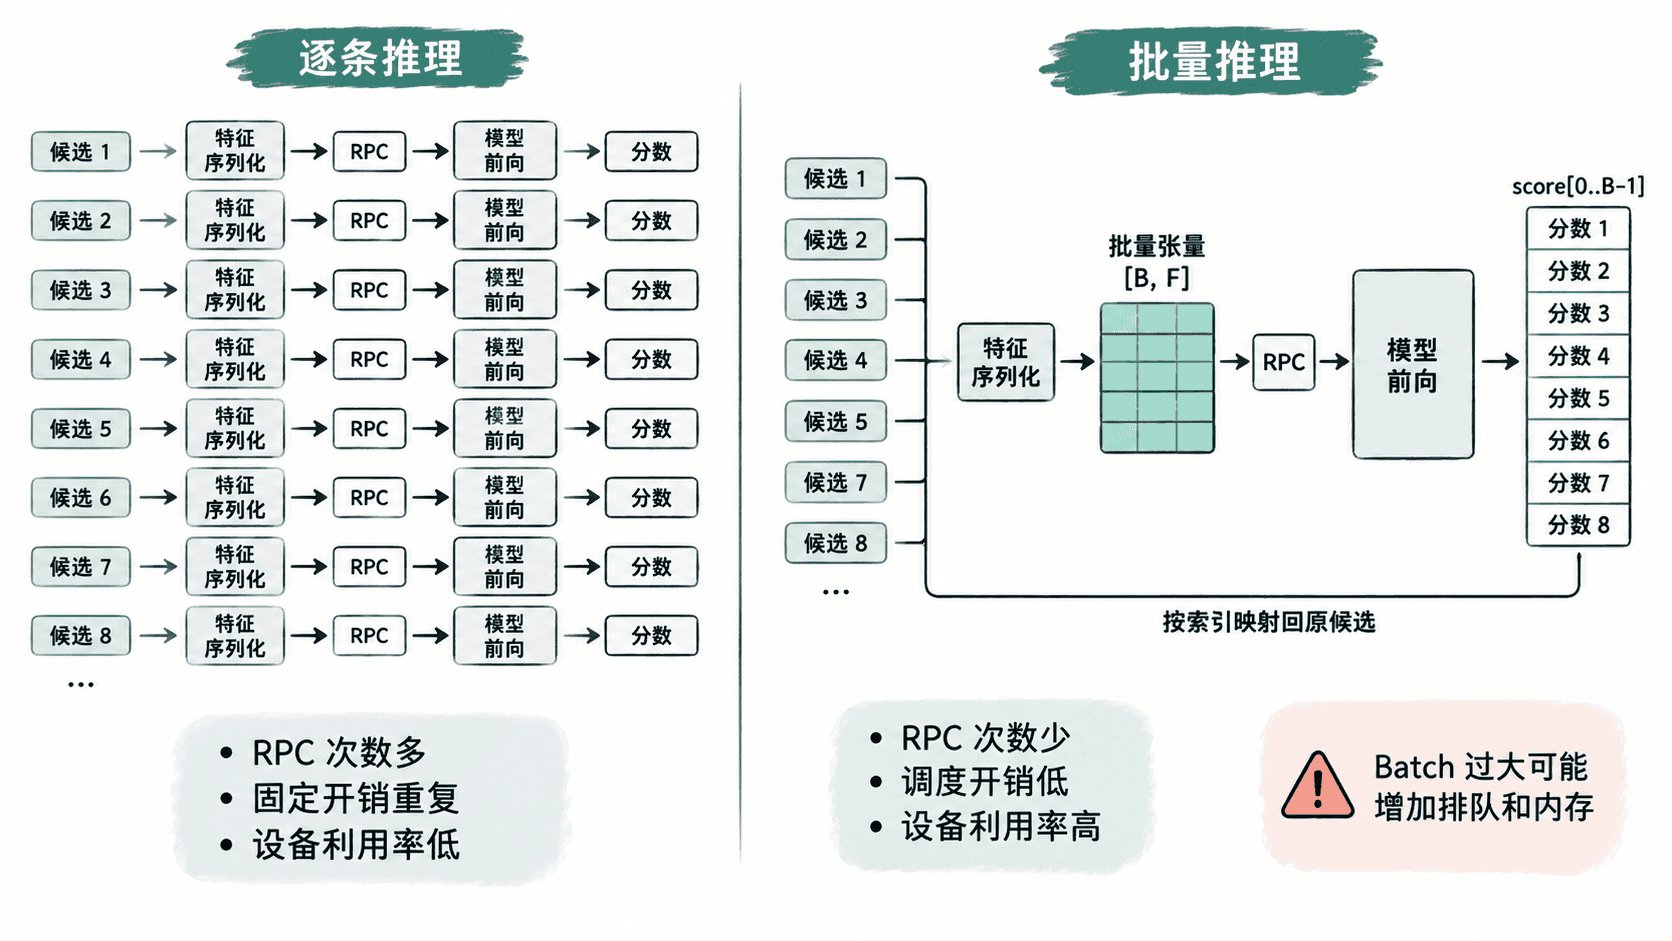
批量化的关键不是简单把列表拼起来,而是保证特征顺序和 shape 固定。线上模型一般要求同一 batch 内每条样本具有相同的特征维度;变长序列则需要 padding、截断或预先分桶,否则会因为最长样本拖大整个 batch 的计算量。
先实现请求内批处理
最简单也最安全的是请求内 batching:只把同一个推荐请求中的候选合并,不等待其他用户的请求。这样没有额外排队时间,尾延迟更可控,也不会引入跨请求取消、超时和优先级问题。
下面的可运行示例用纯 Python 模拟模型调用固定开销,并比较不同 batch size 下处理 256 个候选的总耗时。它不是实际模型性能数据,但可以复现“批量减少固定开销、过大 batch 又增加单批成本”的测量方法。
import math
import statistics
import time

TOTAL_ITEMS = 256

def mock_model_infer(batch_size: int) -> None:
    fixed_overhead = 0.0015
    per_item_cost = 0.00008
    large_batch_penalty = max(0, batch_size - 64) * 0.00001
    time.sleep(
        fixed_overhead
        + per_item_cost * batch_size
        + large_batch_penalty
    )

def run_once(batch_size: int) -> float:
    start = time.perf_counter()
    batch_count = math.ceil(TOTAL_ITEMS / batch_size)
    for index in range(batch_count):
        remaining = TOTAL_ITEMS - index * batch_size
        current = min(batch_size, remaining)
        mock_model_infer(current)
    return (time.perf_counter() - start) * 1000

def percentile(values, p: float) -> float:
    ordered = sorted(values)
    index = math.ceil(len(ordered) * p) - 1
    return ordered[index]

for batch_size in (1, 8, 32, 64, 128):
    samples = [run_once(batch_size) for _ in range(8)]
    print(
        f"batch={batch_size:>3} "
        f"avg={statistics.mean(samples):.1f}ms "
        f"p95={percentile(samples, 0.95):.1f}ms"
    )
预期结果
batch=  1 avg=<HIGH>ms p95=<HIGH>ms
batch=  8 avg=<LOWER>ms p95=<LOWER>ms
batch= 32 avg=<LOWER>ms p95=<LOWER>ms
batch= 64 avg=<NEAR_BEST>ms p95=<NEAR_BEST>ms
batch=128 avg=<MAY_INCREASE>ms p95=<MAY_INCREASE>ms
示例中的具体毫秒数会随操作系统调度而变化,因此用趋势占位表示。真实系统不能只看平均耗时,而要在固定并发下同时记录 QPS、P50、P95、P99、CPU/GPU 利用率和显存或内存峰值。
为什么 batch 越大不一定越快
batch size 增大后,单次调用效率通常先提高,但不会无限线性增长。设备计算单元达到较高利用率后,继续增大 batch 只会让单批计算更久,并占用更多中间张量内存。
如果服务采用跨请求动态 batching,问题会更明显。系统为了凑满 batch,往往会等待几毫秒;低流量时这段等待几乎全部转化为额外延迟,高流量时又可能因为队列增长放大 P95/P99。因此动态 batching 必须同时设置 max_batch_size 和 max_queue_delay,不能只设一个“越大越好”的批大小。
可以把单请求延迟粗略理解为:
优化批处理时,目标不是最小化 ,而是在延迟 SLO 约束下最大化整体吞吐。也就是说,单样本成本最低的 batch size 不一定是线上最佳 batch size。
用压力测试找拐点
压测时保持模型、特征维度、候选数量和并发模型不变,只改变 batch size。建议从 1、8、16、32、64、128 这类倍增序列开始,记录每档的吞吐、P95、P99 和内存峰值。
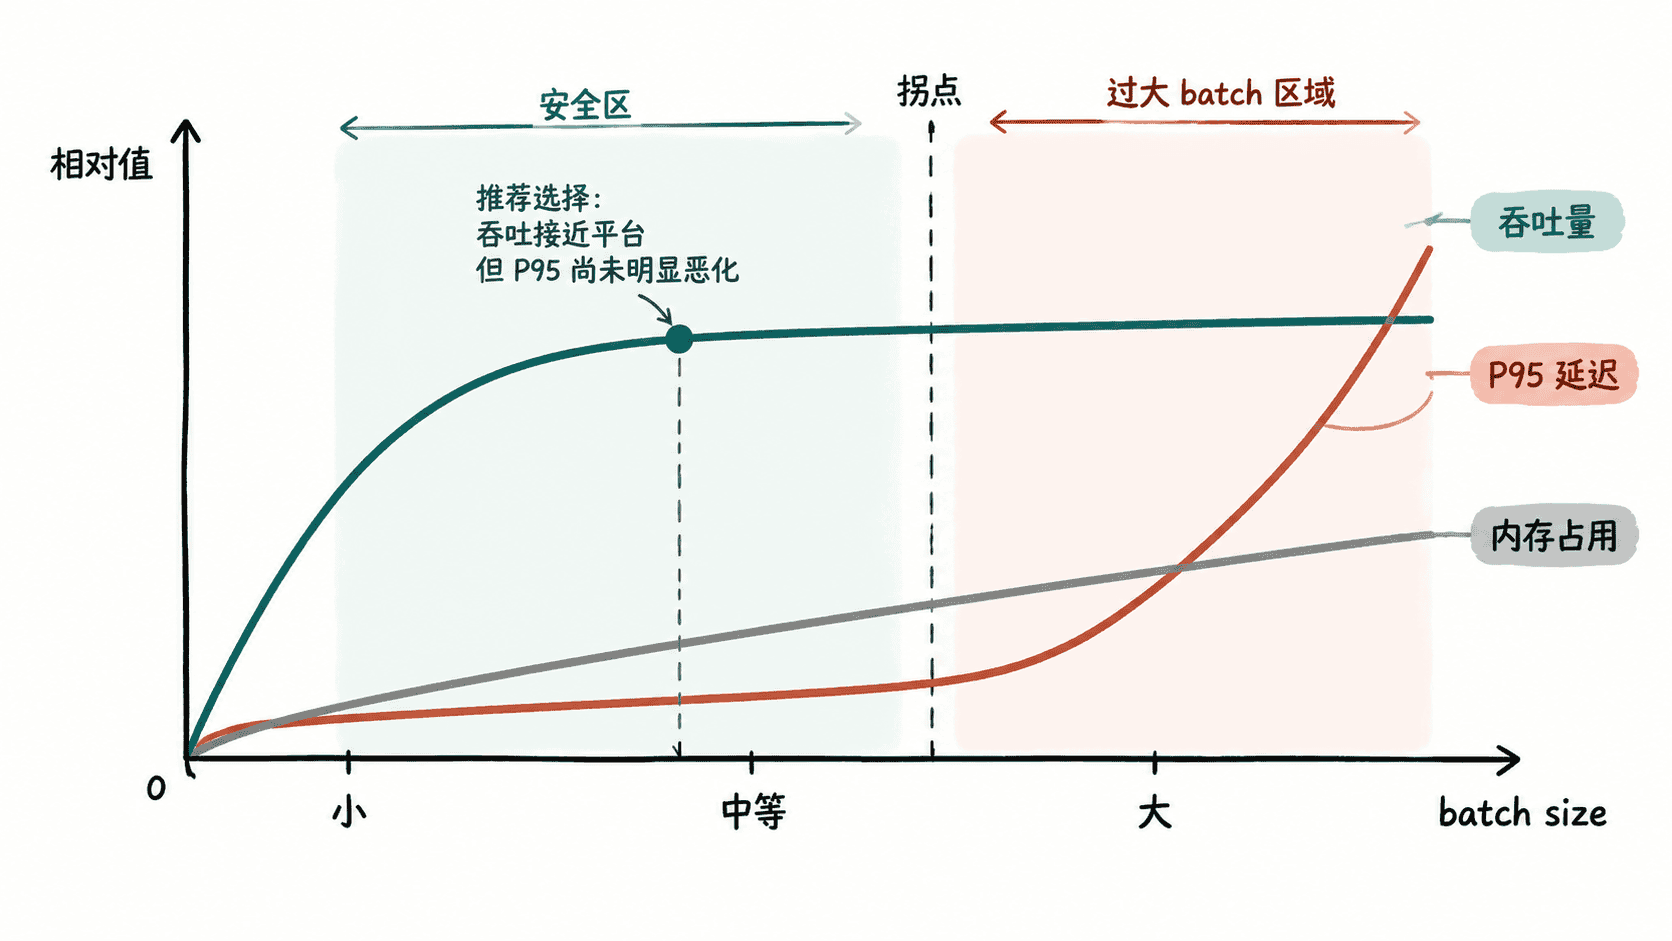
判定拐点时不要只看最高 QPS。例如 batch 64 比 batch 32 吞吐只高 5%,但 P95 增加 25%,通常已经不值得。最终配置应留出流量抖动空间,不要刚好卡在压测得到的极限点。
上线时守住三个边界
第一,限制单请求候选数,避免异常请求直接形成超大 batch。第二,特征拼接前校验维度和缺失值,防止一个坏样本让整批推理失败。第三,把 batch size、排队时间和超时策略做成可观测配置,并持续记录实际 batch 分布。
当线上流量变化较大时,最佳 batch size 也可能变化。稳定做法不是追求最大批量,而是把 batch 控制在设备高利用率且 P95 尚未明显恶化的区间,并通过压测和线上指标共同验证。