
机器学习与深度学习 / 系统课时
用物品相似度完成 ItemCF 召回
用物品相似度完成 ItemCF 召回
这一课把用户历史交互转成可直接在线使用的 ItemCF 召回器:先统计物品共现并归一化为相似度,再从用户近期物品向外扩展候选,最后检查长尾物品是否还能进入召回结果。
学习目标
- 能从用户—物品交互构造共现计数与物品相似度。
- 能用近期交互物品完成候选扩展、去重和打分。
- 能用长尾命中率检查相似物品列表是否只覆盖热门区域。
从共现关系得到物品相似度
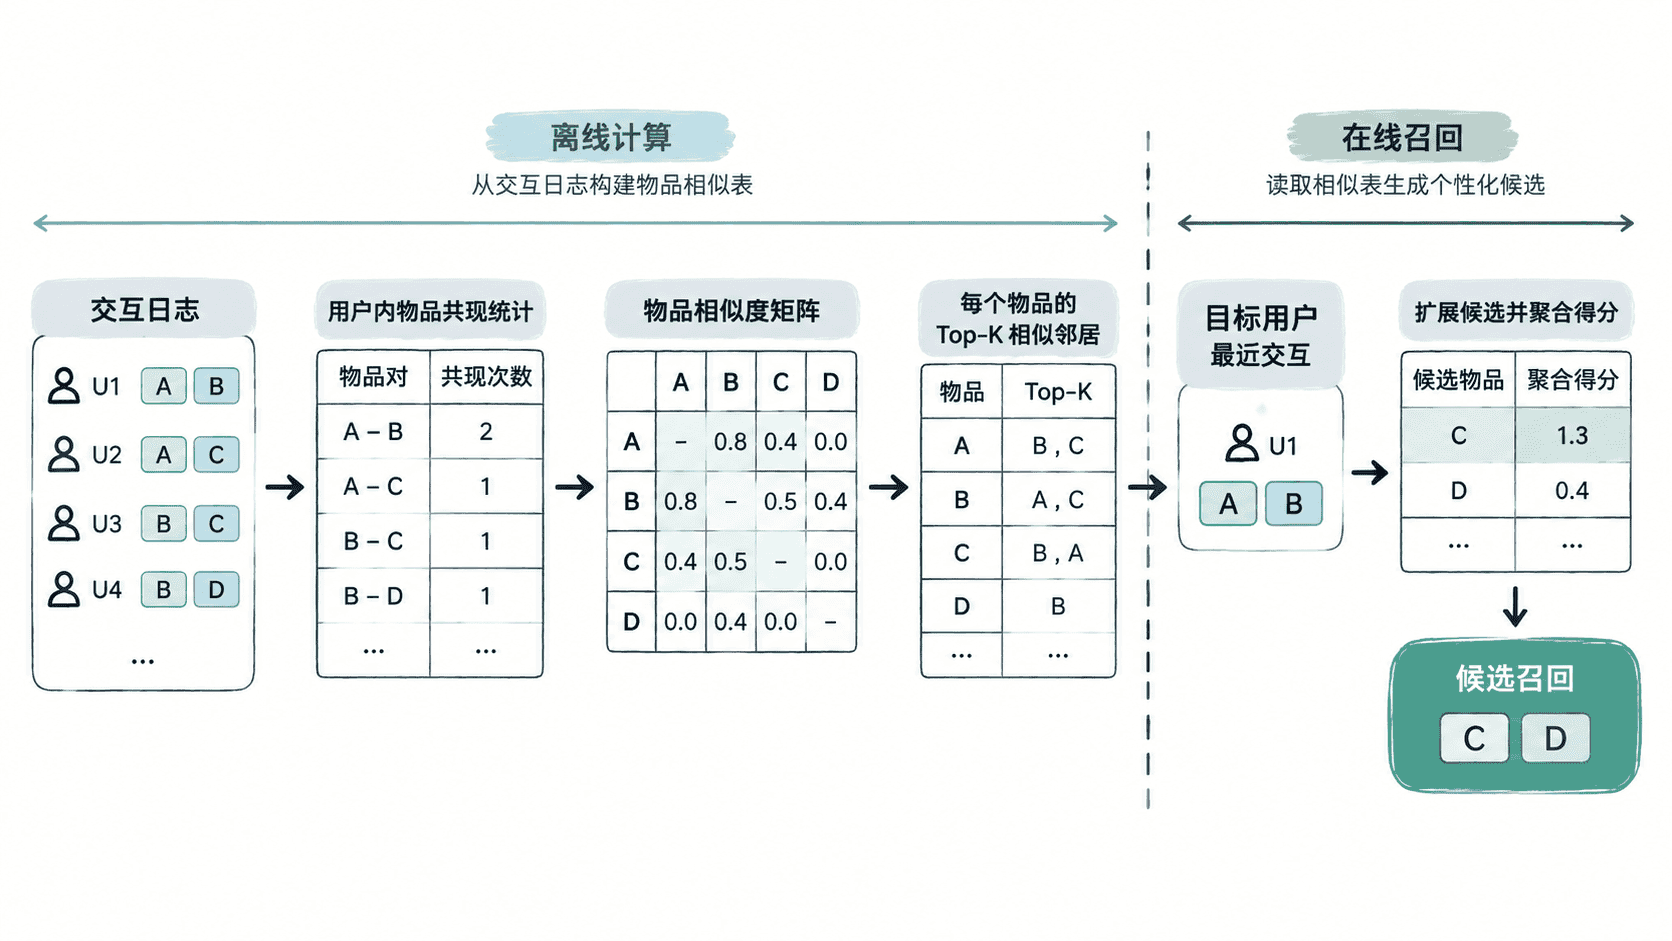
ItemCF 不直接比较物品内容,而是利用“被相似用户一起交互”的协同信号。对物品 i 和 j,先统计同时包含二者的用户数 c_ij,再用各自交互用户数做归一化:。这样能避免仅靠绝对共现次数把热门物品全部推到前面。
实际工程里通常先把每个用户的重复行为压成一次共现,再离线计算每个物品的 Top-K 相似邻居。在线请求只需要读取用户近期交互物品及其邻居列表,不必临时扫描全量行为。
构造一个可运行的 ItemCF 召回器
下面的示例只使用二值交互,先计算余弦式物品相似度,再把目标用户最近交互的 A、B 作为种子,对未见物品累加相似度。真实系统还可以叠加时间衰减、行为类型权重和业务过滤。
from collections import Counter, defaultdict
from math import sqrt

interactions = {
    'u1': ['A', 'B', 'C'],
    'u2': ['A', 'B'],
    'u3': ['A', 'C', 'D'],
    'u4': ['B', 'C', 'D'],
}

item_users = defaultdict(set)
co = defaultdict(Counter)
for user, items in interactions.items():
    items = list(dict.fromkeys(items))  # 同一用户内去重,避免重复点击放大共现
    for item in items:
        item_users[item].add(user)
    for i in items:
        for j in items:
            if i != j:
                co[i][j] += 1

# 用交互用户数归一化,减弱纯热门度带来的共现优势
sim = {
    i: {j: c / sqrt(len(item_users[i]) * len(item_users[j])) for j, c in row.items()}
    for i, row in co.items()
}

recent = ['A', 'B']
seen = set(recent)
scores = Counter()
for seed in recent:
    for candidate, score in sim[seed].items():
        if candidate not in seen:  # 已交互物品不再进入召回候选
            scores[candidate] += score

result = [(item, round(score, 3)) for item, score in scores.most_common()]
tail_items = {'D'}
tail_ratio = sum(item in tail_items for item, _ in result) / len(result)
print(result)
print(f'tail_ratio={tail_ratio:.2f}')
预期输出
[('C', 1.333), ('D', 0.816)]
tail_ratio=0.50
C 同时与 A、B 有较强共现,因此累加后排在第一;D 只通过较弱邻接关系进入候选,但仍被召回。这里把 D 人工定义为长尾物品,因此当前候选中的长尾占比为 0.50。
在线召回时怎样控制候选规模
线上通常不会遍历某个种子的全部邻居,而是只读取每个种子的 Top-K 相似物品。例如用户取最近 20 个交互,每个种子读取 50 个邻居,理论候选上限约为 1000 个,随后再做去重、已看过滤、库存或状态过滤,并截取固定数量送给排序层。
种子本身也不应一视同仁。越近期、越强意图的行为可以赋更高权重,例如购买高于收藏、收藏高于点击;但权重属于在线聚合逻辑,不应破坏离线相似表的可复用性。
检查长尾覆盖而不是只看命中率
只看 Recall@K 或点击率,可能掩盖“所有用户都被推向同一批热门物品”的问题。离线评估时至少同时观察候选覆盖率、长尾候选占比,以及不同用户候选列表的重合度。长尾可以按训练集交互频次分位点定义,例如把后 80% 低频物品作为长尾区。
如果相似邻居长期只落在热门头部,应先检查共现归一化、最低共现阈值和热门度偏置,而不是盲目增大 K。ItemCF 的工程价值在于用一张稳定、可缓存的物品邻接表完成低成本个性化扩展;真正可靠的召回,需要同时保证相关性、候选规模和长尾覆盖。