
机器学习与深度学习 / 系统课时
监控分布漂移与效果退化
监控分布漂移与效果退化
推荐系统出现“点击率下降”时,不能直接把原因归到模型。更有效的做法是同时观察特征分布、候选覆盖、模型得分、业务效果和服务延迟,再用这些信号的组合判断是数据漂移、模型老化还是在线服务异常,并为不同模式准备独立告警与排查入口。
学习目标
- 建立覆盖数据、召回、排序、效果和服务层的监控指标。
- 用分布变化与指标联动区分数据漂移、模型老化和服务异常。
- 为不同退化模式设置可执行的告警阈值与排查顺序。
把监控拆成五层信号
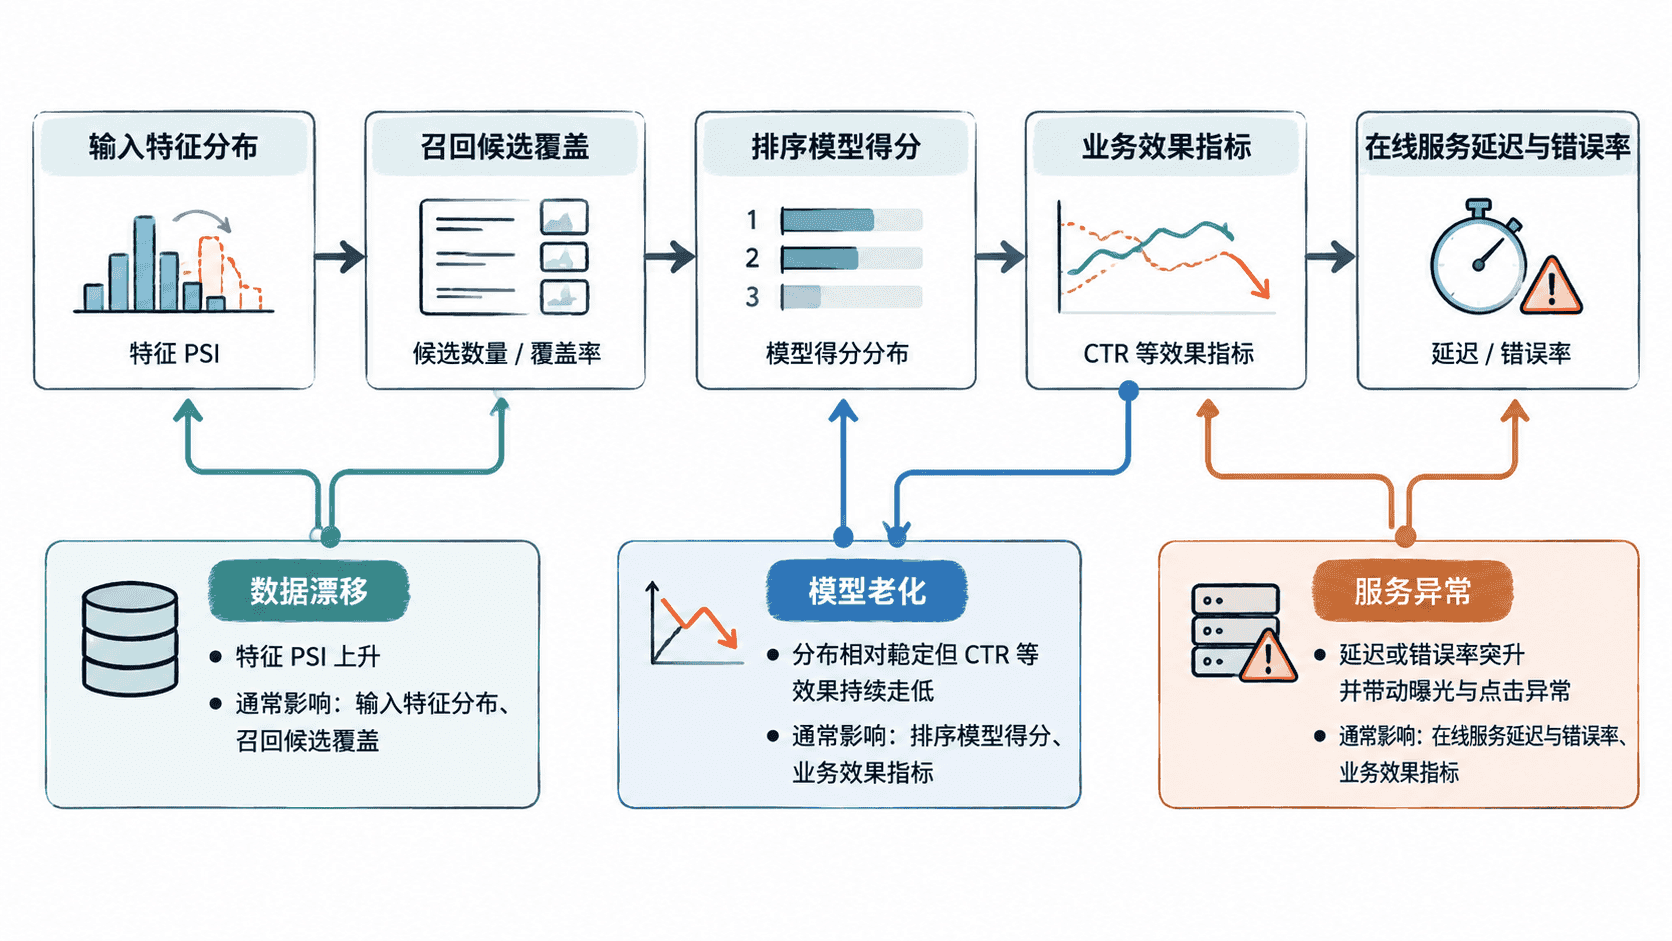
只监控 CTR 容易把结果指标当成根因。推荐链路至少要覆盖五层:输入特征是否变化、候选是否还召得回来、排序分数是否异常、用户反馈是否退化、在线服务是否稳定。单点变化只能说明“哪里不一样”,多层联动才有助于定位原因。
| 监控层 | 代表指标 | 异常时优先怀疑 |
|---|---|---|
| 特征输入 | PSI、缺失率、枚举占比、均值/分位数 | 埋点变更、上游数据异常、用户结构变化 |
| 召回候选 | 候选数、去重后覆盖率、空召回率 | 召回服务、索引更新、过滤规则 |
| 排序得分 | 均值、分位数、饱和比例、分桶分布 | 特征错位、模型输入异常、模型漂移 |
| 业务效果 | CTR、完播率、转化率、负反馈率 | 模型老化、流量结构变化、产品改版 |
| 在线服务 | P95/P99 延迟、错误率、超时率 | 服务容量、依赖故障、发布回归 |
用分布指标识别输入漂移
连续特征可以按基线分桶后比较当前占比,类别特征则直接比较各枚举值占比。PSI 是工程上常用的漂移指标之一,它不等价于“模型一定失效”,但适合作为触发进一步排查的信号。
下面用固定分桶比例计算 PSI。真实系统应使用同一套基线分桶,并对极小占比做下限保护。
import math

baseline = [0.40, 0.30, 0.20, 0.10]
current = [0.25, 0.25, 0.25, 0.25]

def psi(expected, actual):
    total = 0.0
    for e, a in zip(expected, actual):
        # 避免 0 占比导致对数不可计算。
        e = max(e, 1e-6)
        a = max(a, 1e-6)
        total += (a - e) * math.log(a / e)
    return total

value = psi(baseline, current)
print(f"PSI={value:.3f}")
print("ALERT" if value >= 0.20 else "OK")
预期输出:
PSI=0.228
ALERT
PSI 阈值不能脱离业务直接照抄。更稳妥的做法是先回放历史正常时段,得到每个特征自己的波动基线,再按特征重要性和误报成本设置阈值;核心特征还应同时监控缺失率与取值范围,避免“分布没明显变,但字段已经错位”。
用联动模式区分三类退化
数据漂移通常先发生在输入侧。若多个关键特征 PSI、缺失率或类别占比同时变化,而服务延迟正常,随后模型得分分布和 CTR 一起偏移,应优先检查埋点、ETL、特征口径以及用户流量结构。
模型老化更像慢性退化。输入分布没有显著突变,服务也稳定,但 CTR、转化率等效果指标连续数天走低,且新鲜内容、长尾内容或某些用户群体下降更明显,此时应检查训练样本时效、标签延迟、负样本策略和模型版本年龄。
服务异常往往具有突发性。P95/P99 延迟、超时率或错误率突然升高,同时候选数减少、兜底比例升高或曝光量下降,应先处理容量、依赖、发布和缓存问题,而不是立刻回滚模型。
为不同模式建立独立告警
告警最好同时包含“阈值、持续时间、切片条件、排查入口”。瞬时尖峰适合延迟和错误率,分布漂移则通常需要更长观察窗口,否则很容易被小时级流量波动触发。
可以把严重级别分成两层:单一指标越界先进入观察告警;多个相关指标在同一切片内同时越界,再升级为事故告警。例如关键特征 PSI 超阈值且排序分数分布同步偏移,可直接进入数据链路排查;延迟和超时率同时升高则进入在线服务排查。
排查时按“服务可用性 → 数据新鲜度与完整性 → 候选覆盖 → 得分分布 → 业务效果”的顺序推进。这样先排除会污染所有下游指标的基础故障,再判断是否真的是模型能力退化。最终目标不是堆更多监控图,而是让每一种异常都有明确的触发条件、负责人和第一跳排查入口。