
机器学习与深度学习 / 系统课时
用缓存与降级守住延迟预算
用缓存与降级守住延迟预算
在线推荐接口的难点不是让平均延迟更低,而是在用户向量、候选集、物品特征等下游偶发变慢时,仍能把 P95/P99 控制在预算内。本节给出缓存分层、过期策略、回源保护与超时降级的完整落地方式,并用一个可运行示例验证“慢依赖不会拖垮整条链路”。
学习目标
- 为用户向量、热门候选和物品特征选择合适的缓存粒度、TTL 与更新方式。
- 设计缓存穿透、缓存失效和回源失败时的保护策略。
- 用超时、旧值兜底和热门结果降级守住推荐接口延迟预算。
先拆清楚延迟预算
假设推荐接口的目标是 P95 不超过 120 ms。这个 120 ms 不能全部留给排序模型,而要按链路拆分,例如缓存读取 10 ms、候选召回 35 ms、特征补全 25 ms、模型排序 35 ms、结果组装与网络余量 15 ms。这样一旦某个阶段逼近上限,就能在局部触发降级,而不是等到整个请求超时。
缓存的作用也不是“把所有东西都存起来”,而是优先覆盖读取频繁、允许短时间陈旧、回源代价高的数据。推荐链路中,用户向量、热门候选和物品特征通常都满足这个条件,但三者的更新频率和一致性要求不同。
| 数据 | 推荐缓存方式 | 典型 TTL 思路 | 失效后的首选动作 |
|---|---|---|---|
| 用户向量 | 按用户 ID 缓存 | 分钟级,活跃用户可异步刷新 | 回源用户画像服务,超时则用旧向量或默认向量 |
| 热门候选 | 按场景或频道缓存 | 秒到分钟级 | 直接使用最近一版热门列表 |
| 物品特征 | 按 item ID 批量缓存 | 分钟到小时级 | 批量回源,缺失项使用默认特征或过滤 |
TTL 不宜所有 key 同一时刻到期。生产环境应在基础 TTL 上增加小幅随机抖动,避免大量 key 同时失效形成缓存雪崩。
把缓存与降级放进同一条请求链
推荐接口应先命中本地或远端缓存,再决定是否回源;回源必须受超时控制,失败时优先返回可接受的旧数据。真正需要保护的是“请求是否还能在预算内完成”,而不是“这次是否拿到了最新数据”。
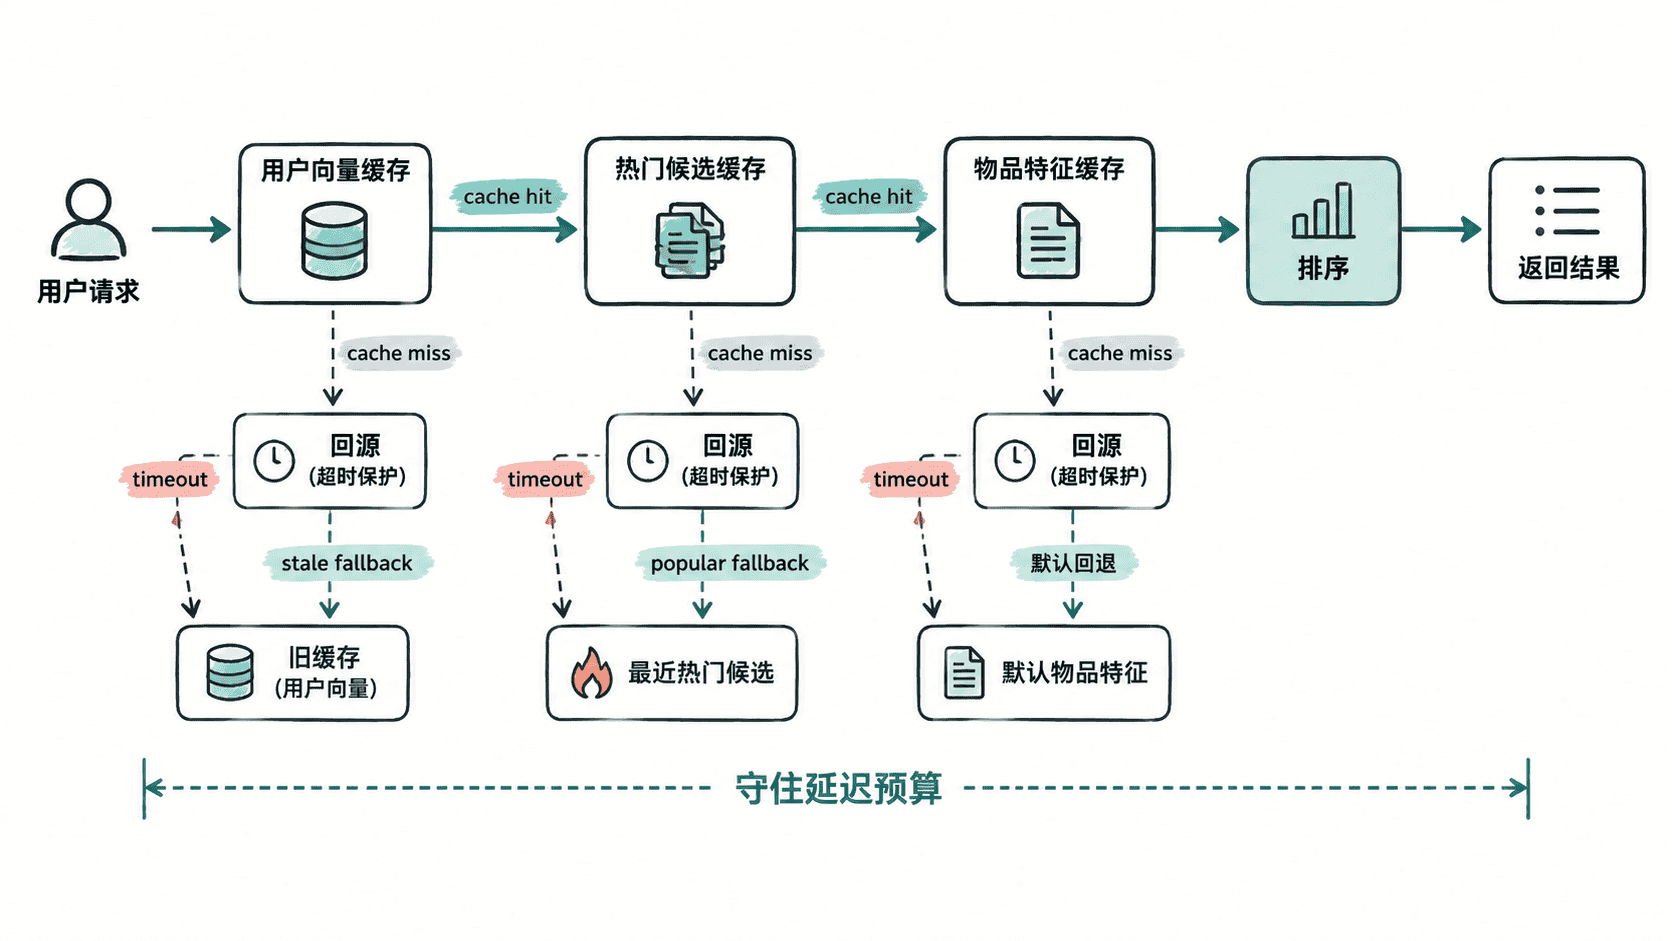
可以把策略概括为四层:命中缓存直接返回;未命中时尝试回源;回源超时则使用旧值;旧值也不存在时才进入业务级降级。对于热门候选,业务级降级通常仍能给出合理结果;对于用户向量,则可以退化为人群向量或全局默认向量。
用可运行示例验证超时降级
下面的 Python 示例模拟用户向量缓存。缓存命中直接返回;缓存过期后允许短时间使用旧值;真正回源时设置 50 ms 超时;若下游更慢,则立即退回旧向量。
import asyncio
import time

CACHE = {
    "u-1": {
        "value": [0.2, 0.7, 0.1],
        "expire_at": time.time() - 1,
        "stale_until": time.time() + 30,
    }
}

async def load_user_vector_from_source(user_id: str):
    await asyncio.sleep(0.2)
    return [0.3, 0.6, 0.1]

async def get_user_vector(user_id: str):
    cached = CACHE.get(user_id)
    now = time.time()

    if cached and now < cached["expire_at"]:
        return cached["value"], "fresh-cache"

    try:
        value = await asyncio.wait_for(
            load_user_vector_from_source(user_id),
            timeout=0.05,
        )
        return value, "source"
    except asyncio.TimeoutError:
        if cached and now < cached["stale_until"]:
            return cached["value"], "stale-cache"
        return [0.0, 0.0, 0.0], "default-vector"

async def main():
    vector, source = await get_user_vector("u-1")
    print(source)
    print(vector)

asyncio.run(main())
预期输出
stale-cache
[0.2, 0.7, 0.1]
实际耗时会受机器调度影响,但结果来源应为 stale-cache,因为模拟下游需要约 200 ms,而回源超时只有 50 ms。这个例子说明降级必须由明确的时间预算驱动,不能依赖下游“通常很快”。
处理穿透、击穿与回源失败
缓存穿透常见于非法用户 ID、已下架物品或持续不存在的 key。对明确不存在的数据可以缓存一个短 TTL 的空值,避免每次请求都打到源服务;对用户可控的 key,还应先做格式与权限校验。
热点 key 失效时容易出现缓存击穿。可采用单飞请求(singleflight)或互斥刷新:同一 key 只允许一个请求回源,其余请求继续读旧值或短暂等待。这样既避免并发回源,也不会因为加锁把所有请求串行化。
回源失败时不要立刻删除旧缓存。更稳妥的做法是区分“逻辑过期”和“物理删除”:逻辑过期后触发刷新,但在一个短暂 stale 窗口内仍允许读取旧值。只有超过 stale 窗口,才退到默认值或热门结果。
用故障注入完成验收
上线前要主动制造失败,而不是只测健康路径。把用户画像服务延迟提高到 200 ms、让 Redis 返回超时、随机删除部分物品特征 key,再确认接口仍能在预算内返回。
验收时重点检查三件事:第一,单个下游超时不会把整个请求拖到总超时;第二,缓存失效不会造成瞬时回源洪峰;第三,降级结果虽然个性化程度下降,但仍然是合法、可展示、可排序的推荐结果。缓存和降级真正要守住的是服务可用性与尾延迟,而不是每一次请求的数据绝对新鲜度。