
机器学习与深度学习 / 系统课时
诊断召回缺失与候选重复
诊断召回缺失与候选重复
召回结果出现候选不足、重复过多、热门物品扎堆或新物品完全缺失时,不能只盯着向量模型。本节建立一条可执行的排查链路,从向量索引、过滤规则、多路配额到最终去重逐层统计,快速定位候选是在什么阶段丢失或被重复放大。
学习目标
- 能用分阶段计数判断候选缺失发生在检索、过滤、配额还是去重环节
- 能识别热门集中、新物品缺失和多路候选重复对应的典型配置问题
- 能通过分路统计验证修复是否真正扩大召回覆盖
先把召回链路拆开观察
线上看到的最终候选通常经历“多路召回 → 过滤 → 配额截断 → 合并 → 去重”。如果只记录最终数量,例如“最终只有 120 个候选”,就无法判断是向量索引只返回了 120 个,还是前面有 800 个却被过滤掉了大半。
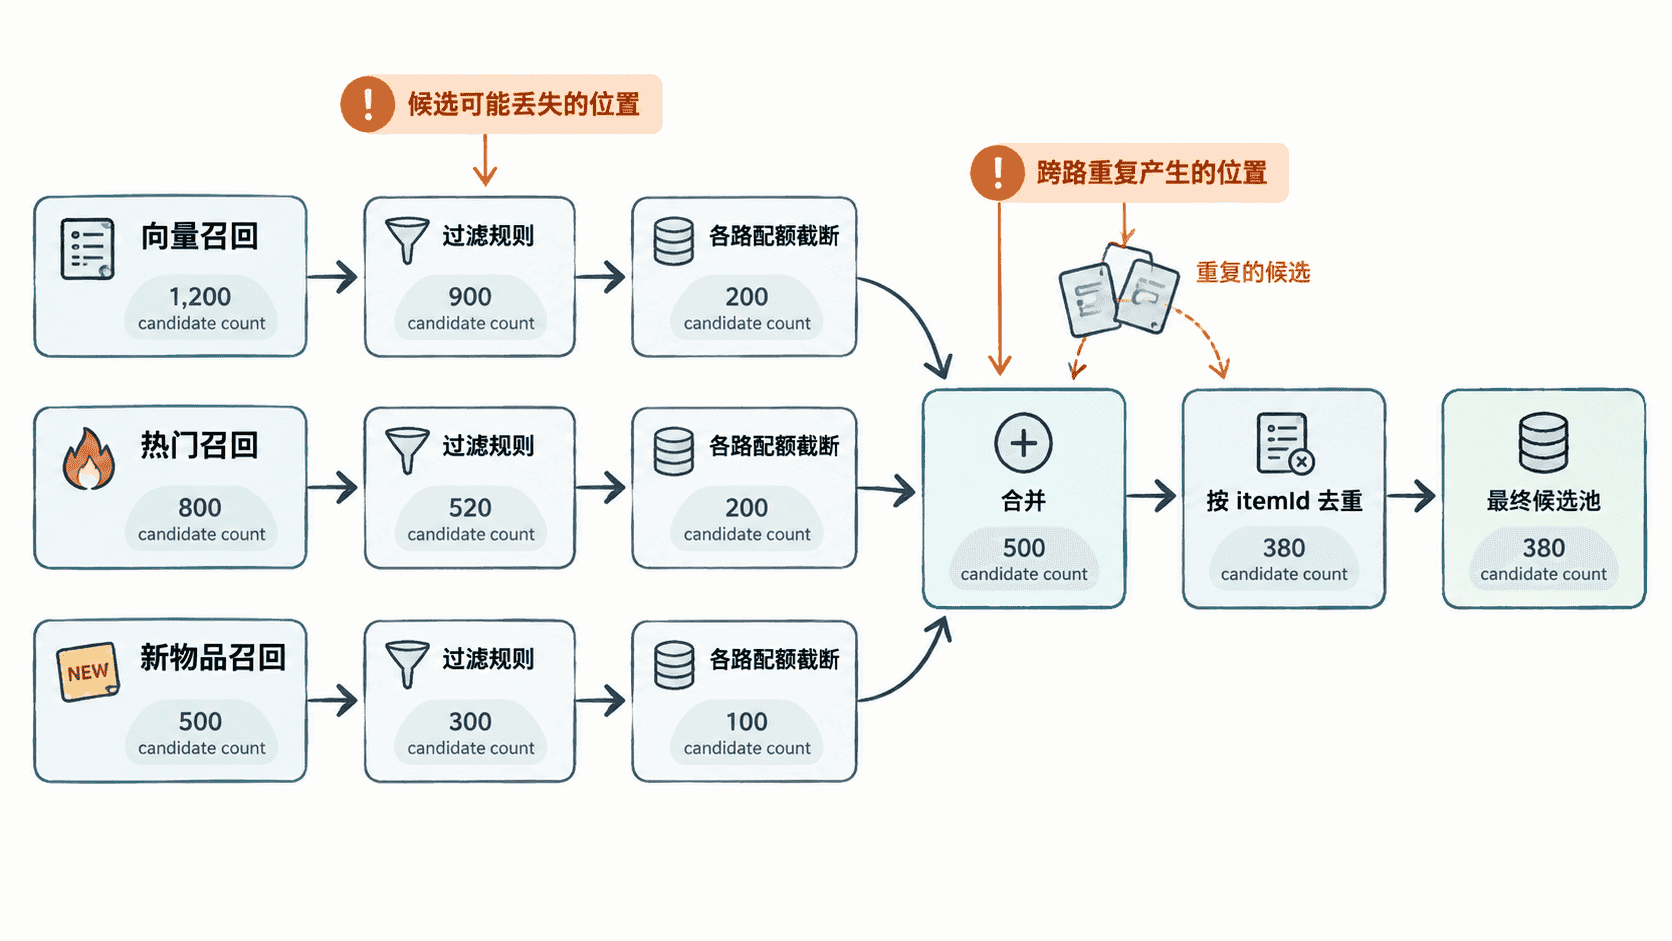
诊断时至少保留四类指标:每一路原始返回数、过滤后数量、合并前数量以及去重后数量。再配合唯一物品数和重复率,就能判断问题来自“召不回来”还是“召回了但后处理丢掉了”。
重复率可以定义为:。例如合并前 600 个候选只有 360 个唯一物品,重复率就是 40%,此时继续提高各路 topK 往往只会产生更多重复。
用分路统计定位异常
下面的 Python 示例模拟三路召回,并输出过滤、合并和去重后的关键统计。实际系统可以把同样的指标写入日志或监控平台。
from collections import Counter

routes = {
    "vector": [101, 102, 103, 104, 105],
    "popular": [101, 102, 106, 107],
    "new_item": [108, 109, 110],
}
blocked = {104, 109}
quota = {"vector": 4, "popular": 3, "new_item": 3}

merged = []
for route, items in routes.items():
    filtered = [item for item in items if item not in blocked]
    selected = filtered[:quota[route]]
    print(f"{route}: raw={len(items)}, filtered={len(filtered)}, selected={len(selected)}")
    merged.extend(selected)

unique_items = list(dict.fromkeys(merged))
counts = Counter(merged)
duplicated = {item: count for item, count in counts.items() if count > 1}

print(f"merged={len(merged)}, unique={len(unique_items)}")
print(f"duplicates={duplicated}")
预期输出:
vector: raw=5, filtered=4, selected=4
popular: raw=4, filtered=4, selected=3
new_item: raw=3, filtered=2, selected=2
merged=9, unique=7
duplicates={101: 2, 102: 2}
这组输出已经暴露两个问题:新物品一路在过滤阶段损失了候选,而向量召回和热门召回共享了 101、102,导致合并数量看似正常,但唯一候选只有 7 个。
按现象检查最可能的根因
候选总量明显低于目标值时,先比较向量索引实际返回数和请求 topK。如果请求 500、索引稳定只返回几十个,应检查索引是否覆盖全部可推荐物品、向量是否成功写入,以及过滤条件是否被错误下推到检索阶段。
如果热门物品扎堆,但候选数量并不少,通常不是“召回不足”,而是多路结果高度重叠。应分别计算每一路唯一物品数和两两交集,并限制热门召回配额,避免它覆盖个性化向量召回的候选空间。
新物品缺失时,要重点检查发布时间、库存、状态和历史交互条件。有些过滤规则会要求“必须已有点击或购买行为”,这会天然把冷启动物品全部排除。新物品召回应该使用独立准入条件,而不是直接复用成熟物品过滤逻辑。
验证修复是否真正扩大覆盖
修复后不要只看最终候选数,应同时比较各路原始数量、过滤损失率、配额利用率、合并前重复率和最终唯一物品数。真正有效的修复通常表现为最终唯一候选增加,同时某一路异常损失率或跨路重叠率下降。
在线上还应按用户活跃度、地域、新老用户等维度拆分这些统计。全局平均值正常,并不代表所有用户都正常;例如只有新用户缺少历史向量时,全量指标可能几乎看不出变化。
当排查链路能够回答“哪一路召回了多少、在哪个阶段丢了多少、重复来自哪两路”时,召回问题就从模糊的效果异常变成了可以逐段验证的工程问题。