
机器学习与深度学习 / 系统课时
用 DeepFM 学习稀疏特征交叉
用 DeepFM 学习稀疏特征交叉
本节把用户、物品和上下文离散特征统一映射为嵌入,搭建一个最小可运行的 DeepFM 排序模型。你会看到 FM 分支如何直接学习二阶交叉,DNN 分支如何继续组合更高阶关系,并掌握用特征组消融验证交叉是否真正带来增益的方法。
学习目标
- 说清 DeepFM 中一阶、FM 二阶交叉和 DNN 三条信号的职责
- 用 PyTorch 构造多字段稀疏特征并完成一次前向计算
- 用离线消融判断用户、物品、上下文特征交叉是否值得保留
DeepFM 为什么适合高维稀疏特征
推荐排序常把 user_id、item_id、城市、设备、类目、时段等离散字段做成 one-hot。字段一多,显式枚举“用户×类目”“设备×时段”会迅速膨胀,而且很多组合在训练集中只出现过很少几次。
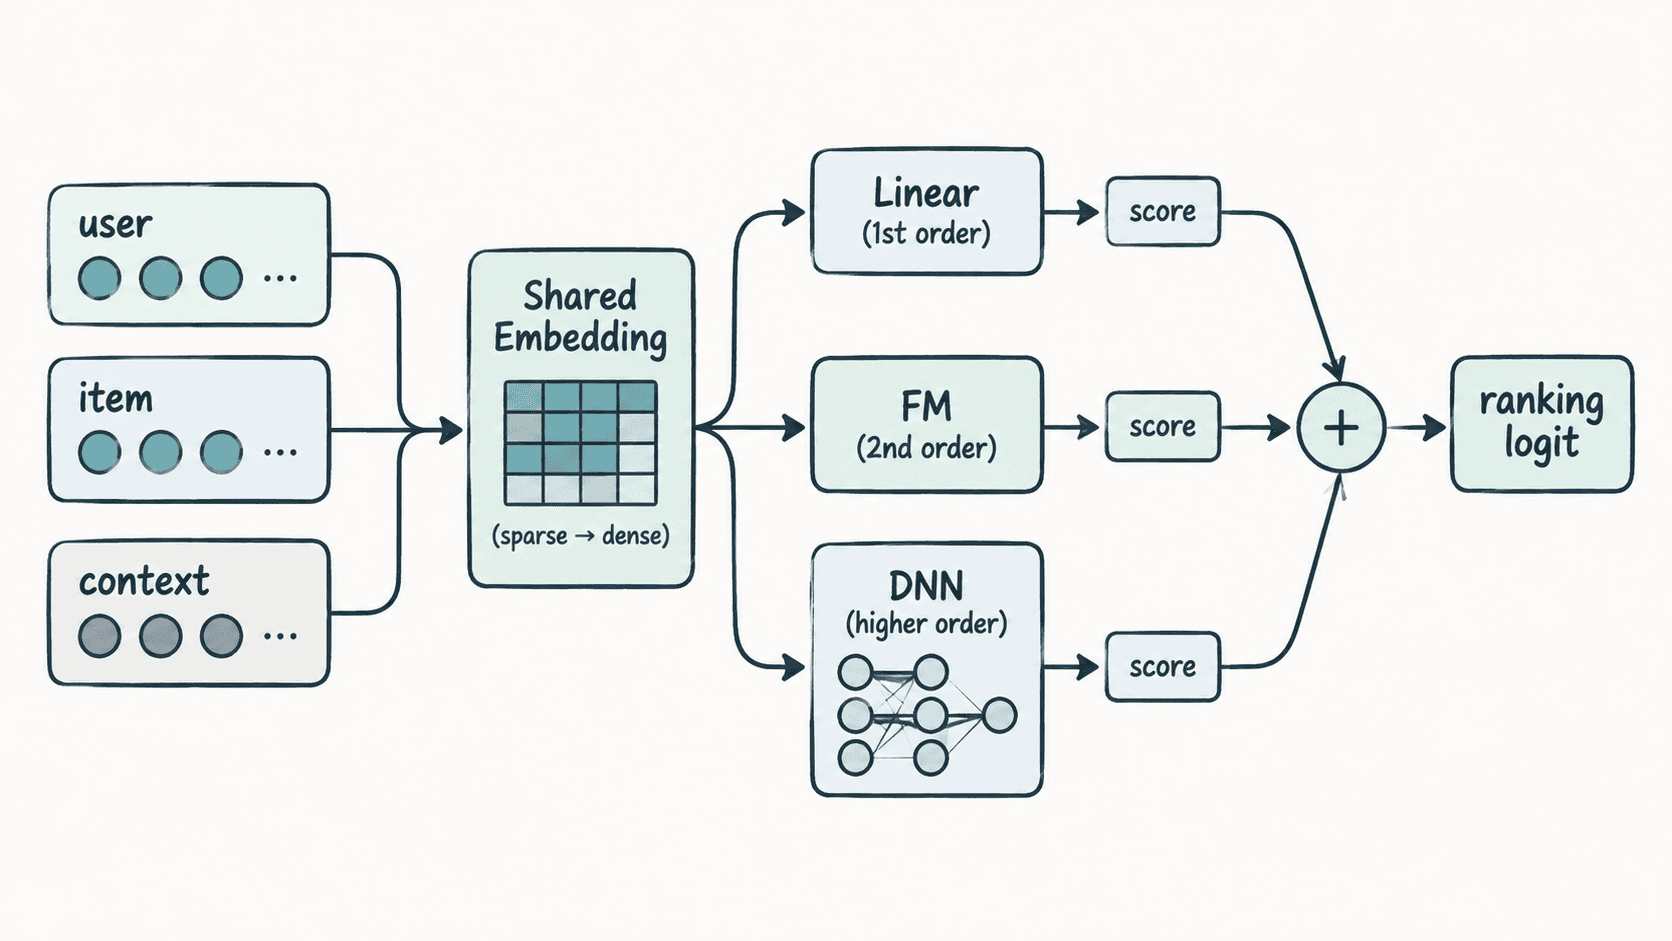
DeepFM 不要求提前人工列出全部交叉。它共享每个字段的低维 embedding,再把同一份 embedding 同时送入 FM 和 DNN:FM 擅长学习二阶组合,DNN 负责继续组合更高阶关系,最后把各分支得分相加得到排序 logit。
FM 二阶项可以理解为:对每对字段 embedding 做内积,再把结果相加。若有 个字段,每个 embedding 维度为 ,可用等价公式把两两计算从 降到 :
这里的关键不是公式本身,而是“相似方向的 embedding 会产生较大的正交互,方向相反则产生负交互”,模型因此能从稀疏样本中共享统计强度。
最小可运行实现
下面用四个离散字段模拟用户、物品、类目和设备。代码包含一阶项、FM 二阶项和 DNN,并让 FM 与 DNN 共享同一组 embedding。
import torch
import torch.nn as nn

torch.manual_seed(7)

class DeepFM(nn.Module):
    def __init__(self, vocab_sizes, embed_dim=8):
        super().__init__()
        self.embeddings = nn.ModuleList([
            nn.Embedding(size, embed_dim) for size in vocab_sizes
        ])
        self.linear_embeddings = nn.ModuleList([
            nn.Embedding(size, 1) for size in vocab_sizes
        ])
        input_dim = len(vocab_sizes) * embed_dim
        self.dnn = nn.Sequential(
            nn.Linear(input_dim, 32),
            nn.ReLU(),
            nn.Linear(32, 1),
        )
        self.bias = nn.Parameter(torch.zeros(1))

    def forward(self, x):
        # x: [batch, field],每列是一个离散字段的局部编号
        field_embs = [
            emb(x[:, i]) for i, emb in enumerate(self.embeddings)
        ]
        stacked = torch.stack(field_embs, dim=1)

        linear = torch.stack([
            emb(x[:, i]).squeeze(-1)
            for i, emb in enumerate(self.linear_embeddings)
        ], dim=1).sum(dim=1)

        # FM 二阶项:0.5 * ((sum v)^2 - sum(v^2))
        summed = stacked.sum(dim=1)
        fm = 0.5 * (summed.pow(2) - stacked.pow(2).sum(dim=1))
        fm = fm.sum(dim=1)

        dnn_input = stacked.flatten(start_dim=1)
        deep = self.dnn(dnn_input).squeeze(-1)
        return self.bias + linear + fm + deep

# 字段依次为 user_id、item_id、category_id、device_id
model = DeepFM(vocab_sizes=[100, 500, 20, 4])
features = torch.tensor([
    [1, 10, 3, 0],
    [2, 11, 3, 1],
    [3, 80, 7, 0],
    [4, 81, 7, 2],
], dtype=torch.long)

logits = model(features)
probs = torch.sigmoid(logits)

print("logits shape:", tuple(logits.shape))
print("probability range valid:", bool(((probs >= 0) & (probs <= 1)).all()))
预期输出:
logits shape: (4,)
probability range valid: True
示例只验证结构与张量流是否正确;真实训练还需要标签、损失函数、优化器和训练集。二分类点击排序通常以 BCEWithLogitsLoss 训练,评估则关注 AUC、LogLoss 以及业务侧的排序指标。
特征组怎样进入交叉层
不要把所有离散字段无差别塞进模型。首先要按业务含义划分用户、物品和上下文特征,再决定哪些字段应该参与共享 embedding 与 FM 交叉。例如用户长期偏好与物品类目通常值得交叉,纯展示流水号这类无稳定语义的字段则可能只带来记忆而非泛化。
FM 自动计算二阶交叉,但“自动”不等于“无需筛选”。高基数 ID 特征如果样本极少,embedding 可能只记住训练样本;上下文字段如果与标签存在泄漏关系,离线指标还会虚高。因此进入交叉层前仍要检查覆盖率、频次分布和是否含未来信息。
用消融验证交叉是否真的有增益
判断“加入某组特征后是否更好”时,不要只看一次训练结果。应固定训练集、验证集、随机种子和主要超参数,至少比较三个版本:仅基础用户与物品特征、加入上下文特征、再加入 FM 交叉。若只改一个变量,离线差异才有解释力。
建议同时看 AUC 与 LogLoss。AUC 反映正负样本的相对排序能力,LogLoss 对概率是否校准更敏感。若 AUC 只提升极小但模型参数和在线延迟明显增加,就要继续检查收益是否足以覆盖工程成本,而不是因为 DeepFM“更复杂”就默认更好。
真正可上线的 DeepFM 不是把所有字段塞进去,而是让有稳定语义、训练覆盖充分且在线可获得的稀疏特征参与交叉,再用严格消融证明新增交叉带来了可复现的排序收益。