
机器学习与深度学习 / 系统课时
滚动更新模型与向量索引
滚动更新模型与向量索引
在线推荐链路更新的难点不是把新文件拷到机器上,而是保证模型、向量索引和特征协议始终成套切换。本课把更新拆成版本绑定、校验预热、双版本切换和回滚观测四步,目标是在不中断服务的前提下让每次发布都可验证、可追踪、可撤回。
学习目标
- 为模型、向量索引和特征协议设计可校验的发布版本。
- 用预热、双版本加载和原子指针完成低风险切换。
- 建立切换前后观测与快速回滚规则,避免异常版本持续放大。
把版本绑定成一次可发布单元
模型与向量索引不能各自独立“取最新”。排序模型可能依赖特定特征 schema,向量召回模型也可能要求固定维度、归一化方式和索引构建参数;任意一项错配,都可能表现为加载成功但结果悄悄变差。
更稳妥的做法是引入 release_id,让一次发布显式绑定 model_version、index_version、embedding_dim、feature_schema 和校验摘要。线上实例只接受完整发布单元,不直接接受“某个新模型”或“某个新索引”。
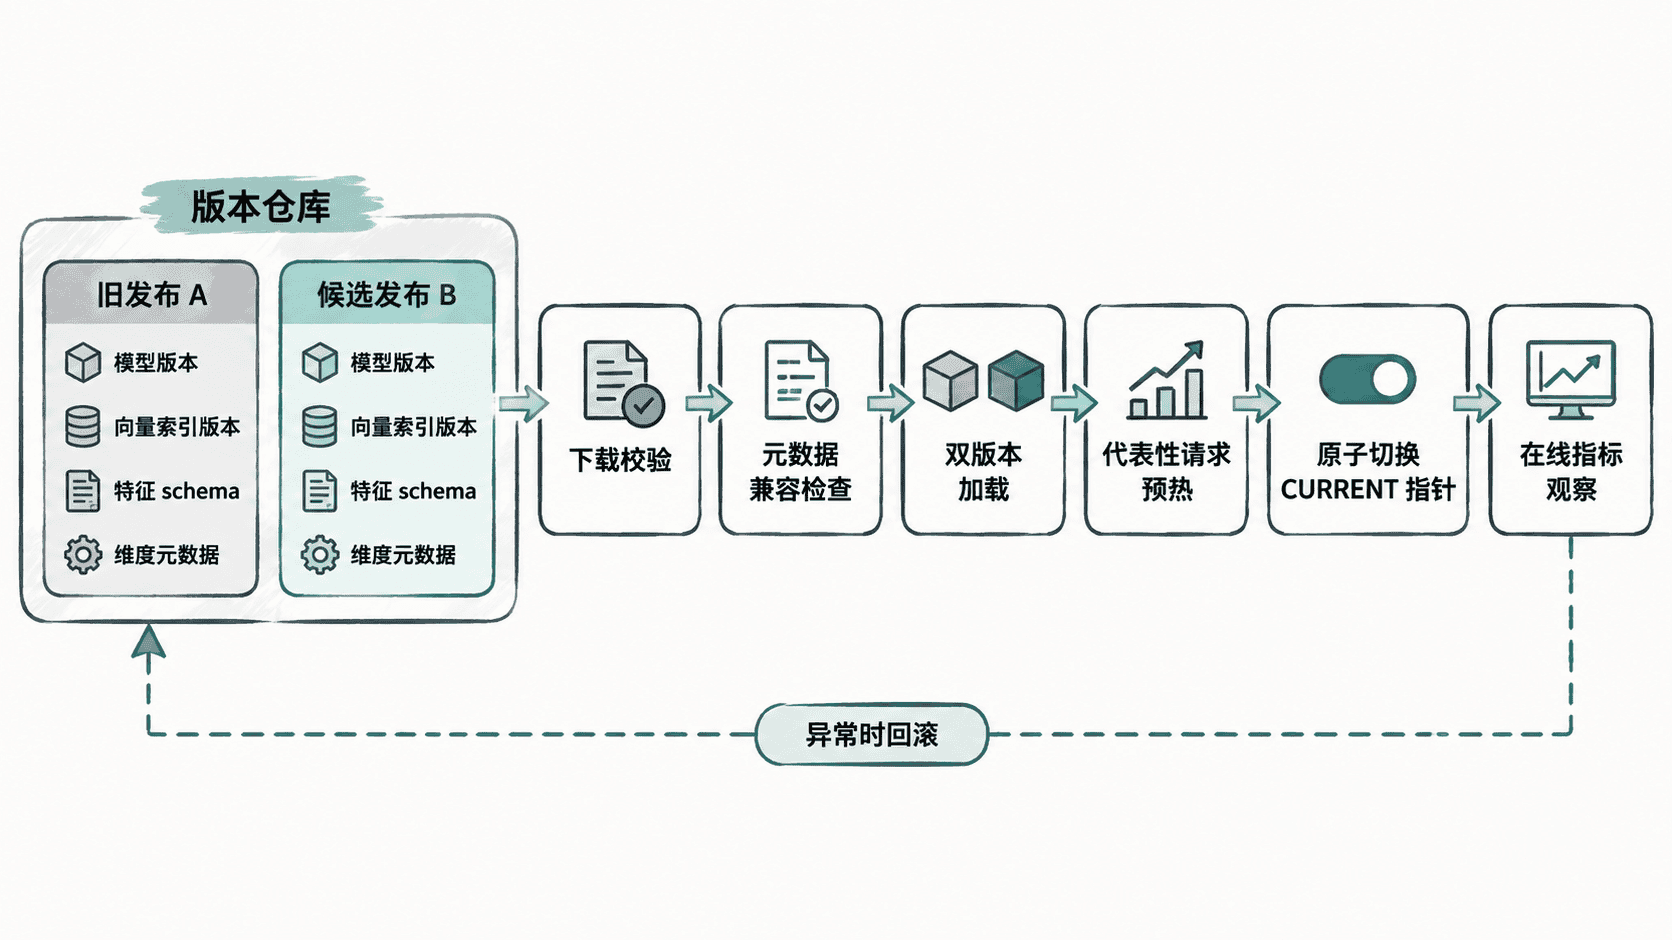
发布清单至少要回答三个问题:文件是不是预期文件、模型和索引是否互相兼容、当前服务代码是否理解这份特征协议。校验失败时应在候选版本阶段终止,不能等流量切过去后再发现问题。
先校验再预热
候选版本进入实例后,先校验元数据和文件摘要,再加载到独立内存区域。加载完成不代表可服务,还要用一组代表性请求完成预热,使模型页、向量页、连接池和必要缓存进入稳定状态。
下面的可运行示例用临时目录模拟发布元数据校验、预热和 CURRENT 指针原子替换。真实系统可把同样的状态机接到对象存储、模型仓库或服务注册配置上。
from dataclasses import dataclass
from pathlib import Path
import json
import os
import tempfile

@dataclass(frozen=True)
class ReleaseMeta:
    release_id: str
    model_version: str
    index_version: str
    embedding_dim: int
    feature_schema: str
    required_index_version: str

def load_meta(path: Path) -> ReleaseMeta:
    data = json.loads(path.read_text(encoding="utf-8"))
    return ReleaseMeta(**data)

def validate(meta: ReleaseMeta) -> None:
    if meta.index_version != meta.required_index_version:
        raise ValueError("model/index version mismatch")
    if meta.embedding_dim != 128:
        raise ValueError("embedding dimension mismatch")
    if meta.feature_schema != "v5":
        raise ValueError("feature schema mismatch")

def warmup(meta: ReleaseMeta) -> None:
    # 真实服务中应执行代表性请求,建立模型页缓存、向量页缓存和连接池。
    sample_ids = ("item-1", "item-2", "item-3")
    if len(sample_ids) < 3:
        raise RuntimeError("warmup failed")

def atomic_switch(pointer: Path, release_id: str) -> None:
    tmp = pointer.with_suffix(".tmp")
    tmp.write_text(release_id, encoding="utf-8")
    os.replace(tmp, pointer)

with tempfile.TemporaryDirectory() as directory:
    root = Path(directory)
    current = root / "CURRENT"
    current.write_text("release-20260914-01", encoding="utf-8")

    candidate = {
        "release_id": "release-20260914-02",
        "model_version": "ranker-20260914-02",
        "index_version": "itemvec-20260914-17",
        "embedding_dim": 128,
        "feature_schema": "v5",
        "required_index_version": "itemvec-20260914-17"
    }
    meta_path = root / "candidate.json"
    meta_path.write_text(json.dumps(candidate), encoding="utf-8")

    before = current.read_text(encoding="utf-8")
    meta = load_meta(meta_path)
    validate(meta)
    warmup(meta)
    atomic_switch(current, meta.release_id)
    after = current.read_text(encoding="utf-8")

    print(f"validated={meta.release_id}")
    print("warmup=ok")
    print(f"switch={before}->{after}")
    print(f"rollback_target={before}")
预期输出:
validated=release-20260914-02
warmup=ok
switch=release-20260914-01->release-20260914-02
rollback_target=release-20260914-01
示例中的实际目录由系统临时创建,因此路径值每次不同;这里不输出动态路径。生产环境还应校验模型文件和索引文件的 checksum,并把校验结果写入发布记录。
用双版本和原子切换缩短风险窗口
更新期间同时保留旧版本 A 和候选版本 B。B 完成加载和预热后,单个实例只切换一个不可分割的活动引用,例如从 release-A 指向 release-B;请求处理线程只读取这个活动引用,避免一个请求拿到新模型却访问旧索引。
多实例服务仍要分批滚动。先让少量实例切到 B,观察错误率与延迟,再扩大比例;但每个实例内部都应保证模型和索引同时生效。双版本会暂时增加内存,发布前必须预留足以容纳 A、B 以及预热峰值的容量。
记录证据并保留整包回滚
切换记录至少保存 release_id、模型版本、索引版本、发布时间、操作者或流水线 ID,以及切换前后的 QPS、错误率、空召回率和 p50/p95/p99 延迟。效果指标往往有延迟,还应记录曝光版本,保证后续 CTR、转化率等业务结果能准确归因到发布版本。
回滚条件要在发布前写清。例如错误率突破阈值、p99 延迟持续恶化、空召回率突升或关键特征缺失时,立即把活动引用切回上一完整发布单元。回滚后继续保留异常版本的元数据与观测记录,用于复盘,但不要在现场重新拼装“旧模型加新索引”。
真正可靠的滚动更新,不是追求永远不出问题,而是让不兼容版本进不了流量、异常版本能在分钟级撤回,并且每次切换都有完整证据可以解释发生了什么。