
机器学习与深度学习 / 系统课时
保持训练与在线特征一致
保持训练与在线特征一致
本节解决推荐模型中最隐蔽的一类效果问题:训练时看到的特征和线上推理时实际读取的特征并不一致。你将建立统一特征定义、对齐时间口径与缺失值策略,并用同一批样本自动核对离线与在线结果。
学习目标
- 为特征统一名称、类型、时间窗口和默认值定义
- 识别离线回填与在线读取在时间口径、聚合逻辑和缺失值上的偏差
- 用同一请求执行离线与在线特征对账,并定位差异来源
把特征定义变成唯一事实来源
训练脚本和在线服务分别手写特征逻辑,短期开发快,长期几乎必然漂移。更可靠的做法是把每个特征的名称、数据类型、窗口、默认值和版本集中定义,再让离线回填与在线读取都引用这份定义。
以“用户近 7 天点击数”为例,定义至少要明确:窗口是自然日还是滚动 168 小时;事件时间还是处理时间;是否排除当前请求之后到达的迟到数据;无历史行为时返回 0 还是空值。只写一个 user_click_7d 名称远远不够。
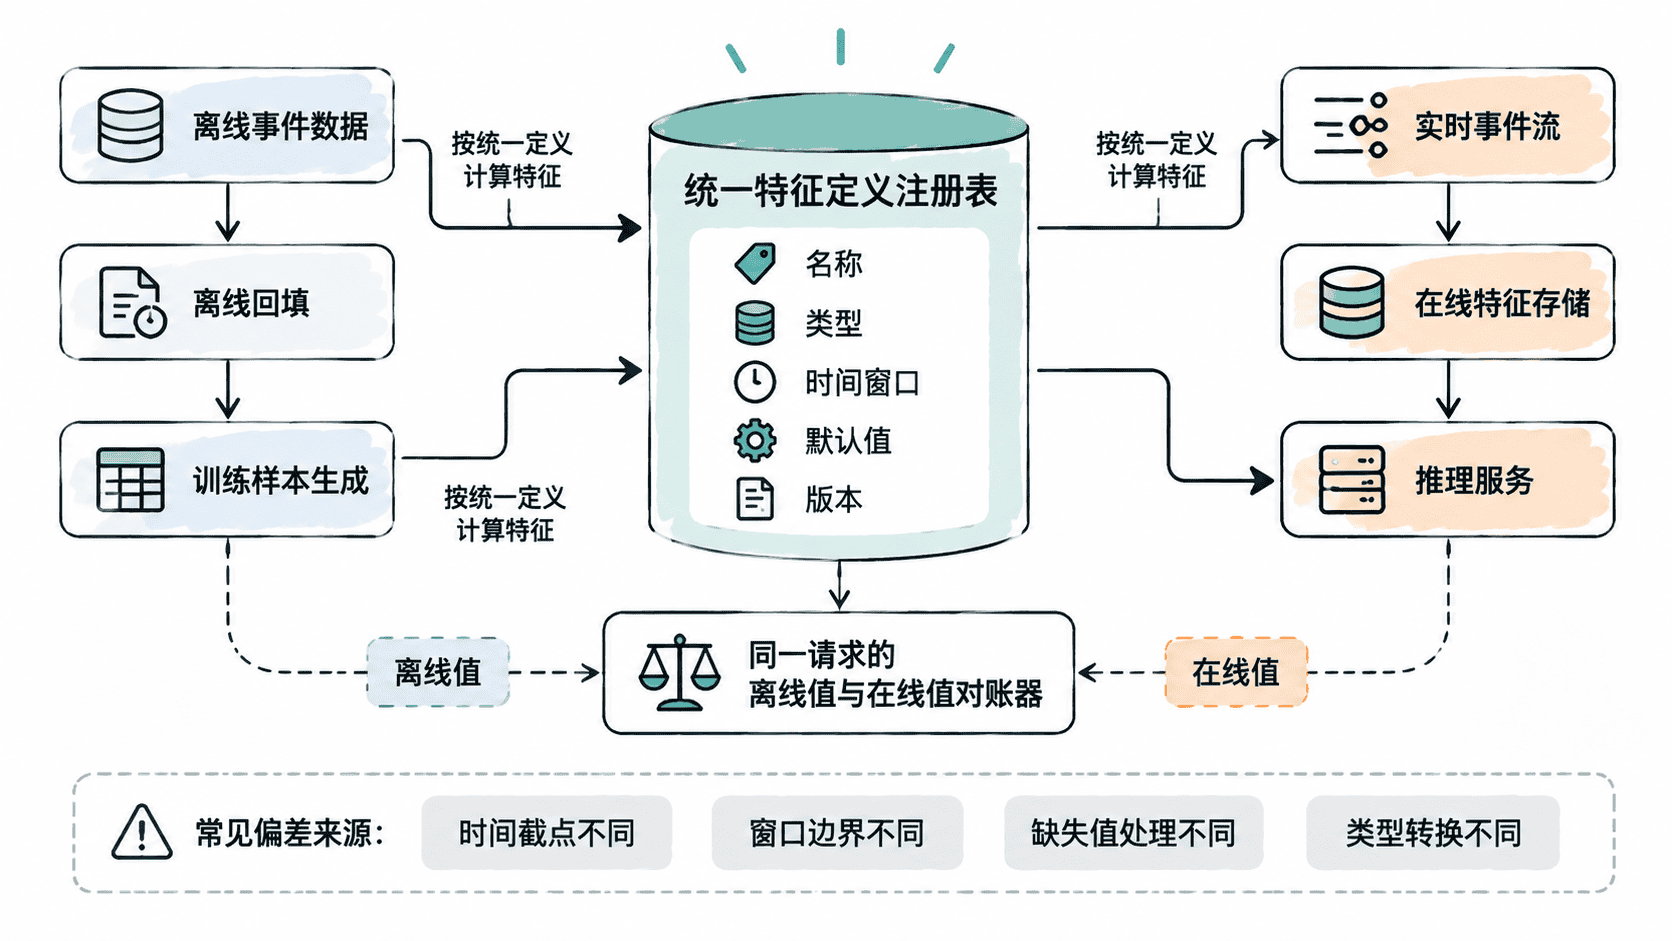
统一定义的目标不是把所有特征计算都放到同一个系统,而是让“语义”只有一个版本。离线可以用 SQL 或批处理,在线可以用流处理和 KV 存储,但两边必须对同一个定义负责。
最容易漂移的是时间口径
训练特征必须模拟“当时线上能看到什么”。如果用今天的完整行为表回填昨天样本,却没有按样本时间截断,就会把未来信息泄漏进训练数据。模型离线指标可能很好,线上却明显变差,这类问题通常不是模型结构本身导致的。
对于时间窗口特征,应固定一个样本时间 eventTime,离线与在线都以它作为窗口右边界。例如 7 天点击数应只统计 (eventTime - 7d, eventTime] 范围内事件。对实时请求,eventTime 可以是请求时间;对历史训练样本,则必须使用样本发生当时的时间。
缺失值与类型转换必须完全一致
常见差异并不复杂,却很难从模型日志里直接看出来:离线 SQL 的 NULL 被填成 0,在线代码却填成 -1;离线把金额保留两位小数,在线转换成整数;离线类别特征使用字符串,在线服务却先转枚举编号。
默认值不能临时写在模型调用前。它应该是特征契约的一部分,并在训练样本生成与在线读取时复用。同样,数值裁剪、归一化、分桶和类别映射也应有版本,模型发布时记录自己依赖的特征版本。
用同一请求做离线与在线对账
最直接的校验方式,是保存一批带时间戳的样本请求,同时计算离线特征和在线特征,再逐字段比较。下面的 Python 示例模拟三个特征的对账:数值特征允许极小浮点误差,其他类型要求完全相等。
from math import isclose

offline = {
    "user_click_7d": 12,
    "user_pay_rate_30d": 0.25,
    "device_type": "ios",
}

online = {
    "user_click_7d": 12,
    "user_pay_rate_30d": 0.20,
    "device_type": "ios",
}

diffs = {}

for name, offline_value in offline.items():
    online_value = online.get(name)

    if isinstance(offline_value, float) and isinstance(online_value, float):
        equal = isclose(offline_value, online_value, rel_tol=0.0, abs_tol=1e-9)
    else:
        equal = offline_value == online_value

    if not equal:
        diffs[name] = {"offline": offline_value, "online": online_value}

print(diffs)
预期输出如下,说明只有 user_pay_rate_30d 存在不一致。
{'user_pay_rate_30d': {'offline': 0.25, 'online': 0.2}}真实系统中不要只比较最终模型输入向量,因为那会丢掉特征名和来源。应按特征名输出差异,并附上样本时间、特征版本、离线任务版本和在线服务版本,才能把问题追到具体计算链路。
把一致性检查放进发布流程
一次人工对账只能发现当前问题,持续发布需要自动门禁。模型上线前,可固定一组回放样本,对关键特征做逐字段比较;对于严格特征要求完全一致,对于近似实时特征则配置允许误差或允许延迟。超过阈值时,应阻止模型继续放量。
上线后还要持续看特征缺失率、默认值命中率、分布漂移和版本命中情况。训练与在线一致性并不是“特征值永远一模一样”,而是同一语义、同一时间口径和同一缺失策略下,差异必须可解释、可量化,并且在模型允许范围内。