
机器学习与深度学习 / 系统课时
用时间回放还原离线推荐场景
用时间回放还原离线推荐场景
静态随机切分很容易让测试样本“看到未来”:训练集可能含有测试时点之后的行为,候选集可能出现尚未上架的物品,特征也可能来自未来快照。本课用时间回放把数据恢复到当时可见状态,并与随机切分并排检查偏差。
学习目标
- 识别行为、候选物品和特征三类常见时间泄漏
- 按测试时点构造只使用历史信息的回放上下文
- 用同一批测试点比较随机切分与时间回放的偏差
随机切分为什么会显得更好
推荐系统的数据天然有时间方向。若直接把交互随机分成训练集和测试集,某个 10:00 的测试行为可能对应一条 12:00 的训练行为;模型等于从未来学习了用户偏好。类似问题还会发生在物品池和特征表中。
| 泄漏位置 | 错误做法 | 时间回放做法 |
|---|---|---|
| 用户行为 | 随机训练集含测试时点后的行为 | 只保留 event_time < t |
| 候选物品 | 用今天完整商品库评估昨天请求 | 只保留 created_at <= t |
| 特征快照 | 直接取当前最新特征 | 取 feature_time <= t 的最后一版 |
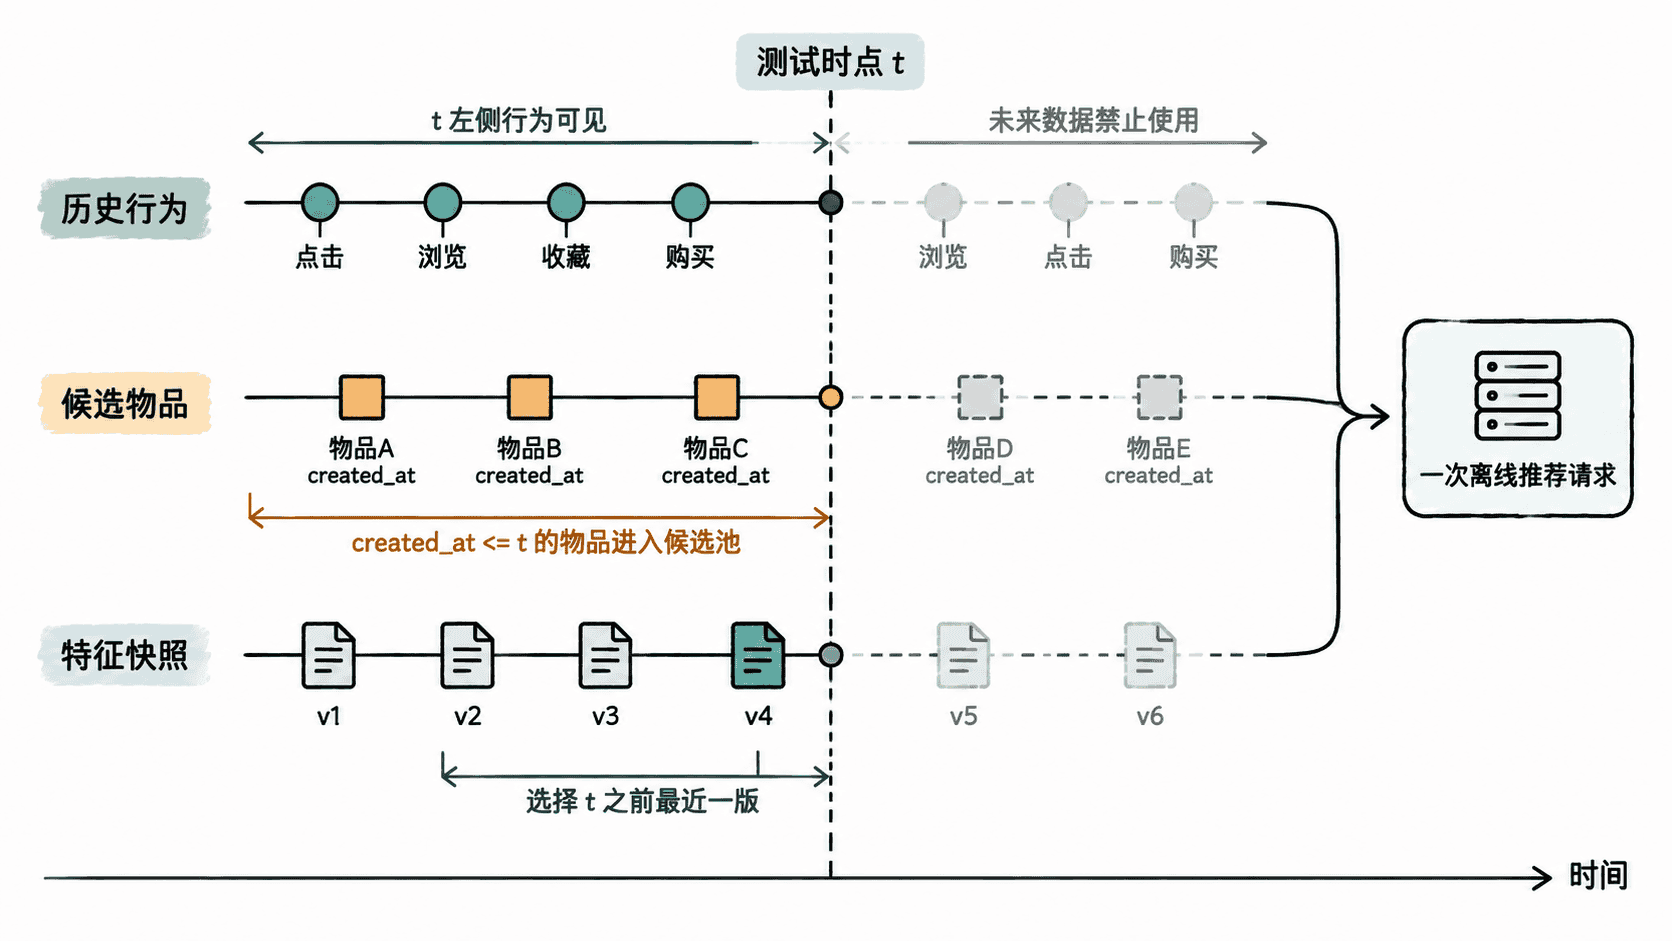
时间回放要固定四条边界
对每个测试事件,都把其时间记为 t,随后按同一规则重建当时的请求上下文。
- 训练和用户历史只能读取
t之前已经发生的行为。 - 候选池只能包含
t时刻已经创建且处于可推荐状态的物品。 - 用户、物品和上下文特征必须做 point-in-time join,只取
t之前最近一次快照。 - 召回、排序和指标代码保持不变,避免把“评估协议变化”与“算法变化”混在一起。
如果线上模型按小时、按天或按版本发布,离线回放还应复刻相同的模型更新时间边界,而不是让每个测试点都使用全量未来训练结果。
最小可运行回放
下面用一个无第三方依赖的 Python 示例,对同一批测试点同时计算随机切分的未来泄漏和时间回放的泄漏。示例中的整数时间可理解为连续的业务时点。
python
import random

items = {"A": 1, "B": 3, "C": 6, "D": 9}
events = [
    (1, "u1", "A"),
    (2, "u1", "A"),
    (3, "u1", "B"),
    (4, "u1", "B"),
    (5, "u1", "A"),
    (6, "u1", "C"),
    (7, "u1", "C"),
    (8, "u1", "B"),
    (9, "u1", "D"),
    (10, "u1", "D"),
]
features = {
    "A": [(1, 0.1), (5, 0.7)],
    "B": [(3, 0.2), (8, 0.9)],
    "C": [(6, 0.4)],
    "D": [(9, 0.6)],
}

def latest_feature(item, t):
    valid = [(ts, value) for ts, value in features[item] if ts <= t]
    return valid[-1] if valid else None

indices = list(range(len(events)))
random.Random(7).shuffle(indices)
test_idx = sorted(indices[:3])
train_idx = sorted(indices[3:])

random_future_train = 0
static_future_candidates = 0

for i in test_idx:
    t, _, _ = events[i]
    # 随机切分可能让测试时点之后的行为进入训练集。
    random_future_train += int(any(events[j][0] > t for j in train_idx))
    static_future_candidates += sum(
        created_at > t for created_at in items.values()
    )

for i in test_idx:
    t, user, _ = events[i]
    history = [e for e in events if e[1] == user and e[0] < t]
    candidates = [
        item for item, created_at in items.items() if created_at <= t
    ]
    point_in_time_features = {
        item: latest_feature(item, t) for item in candidates
    }

    # 三个断言分别保护行为、候选物品和特征的时间边界。
    assert all(e[0] < t for e in history)
    assert all(items[item] <= t for item in candidates)
    assert all(
        snapshot is None or snapshot[0] <= t
        for snapshot in point_in_time_features.values()
    )

print("test_times=", [events[i][0] for i in test_idx], sep="")
print(
    f"random_split future_train_leak_rate="
    f"{random_future_train / len(test_idx):.1%} "
    f"future_candidate_count={static_future_candidates}"
)
print(
    "time_replay  future_train_leak_rate=0.0% "
    "future_candidate_count=0"
)
预期输出:
text
test_times=[2, 4, 9]
random_split future_train_leak_rate=100.0% future_candidate_count=5
time_replay  future_train_leak_rate=0.0% future_candidate_count=0
这里的数字不是推荐质量本身,而是在验证评估协议是否可信。随机切分的三个测试点全部受到未来训练行为影响,并额外暴露了 5 个当时尚不存在的候选物品;时间回放把这两类泄漏都压到 0。
把两套结果并排看
真实项目中应对同一模型同时记录随机切分与时间回放下的 Recall@K、NDCG@K、覆盖率等指标,再把差值写进评估报告。若随机切分明显更高,先检查时间泄漏、候选池构造和特征快照,不要急着把差值解释成模型能力。
时间回放的目标不是让离线分数更漂亮,而是让每个测试时点只能使用线上当时真正拥有的信息。只有先把评估协议做成“不可穿越时间”的系统,后续召回、排序和重排实验的收益才值得相信。
按自己的节奏,确认真正理解。