
机器学习与深度学习 / 系统课时
用用户相似度完成 UserCF 召回
用用户相似度完成 UserCF 召回
本节实现一个最小可运行的 UserCF 召回器:先用共同交互计算用户相似度,再选 TopN 近邻,把近邻看过而目标用户没看过的物品按相似度加权汇总。最后改变近邻数量,直接观察召回率、覆盖率与候选扫描量如何一起变化。
学习目标
- 用二值交互计算用户间相似度并选出稳定的 TopN 近邻
- 汇总近邻的未交互物品,完成已看过滤和候选分数排序
- 理解近邻数量、活跃用户偏置、召回覆盖与计算量之间的权衡
UserCF 真正要产出的是候选
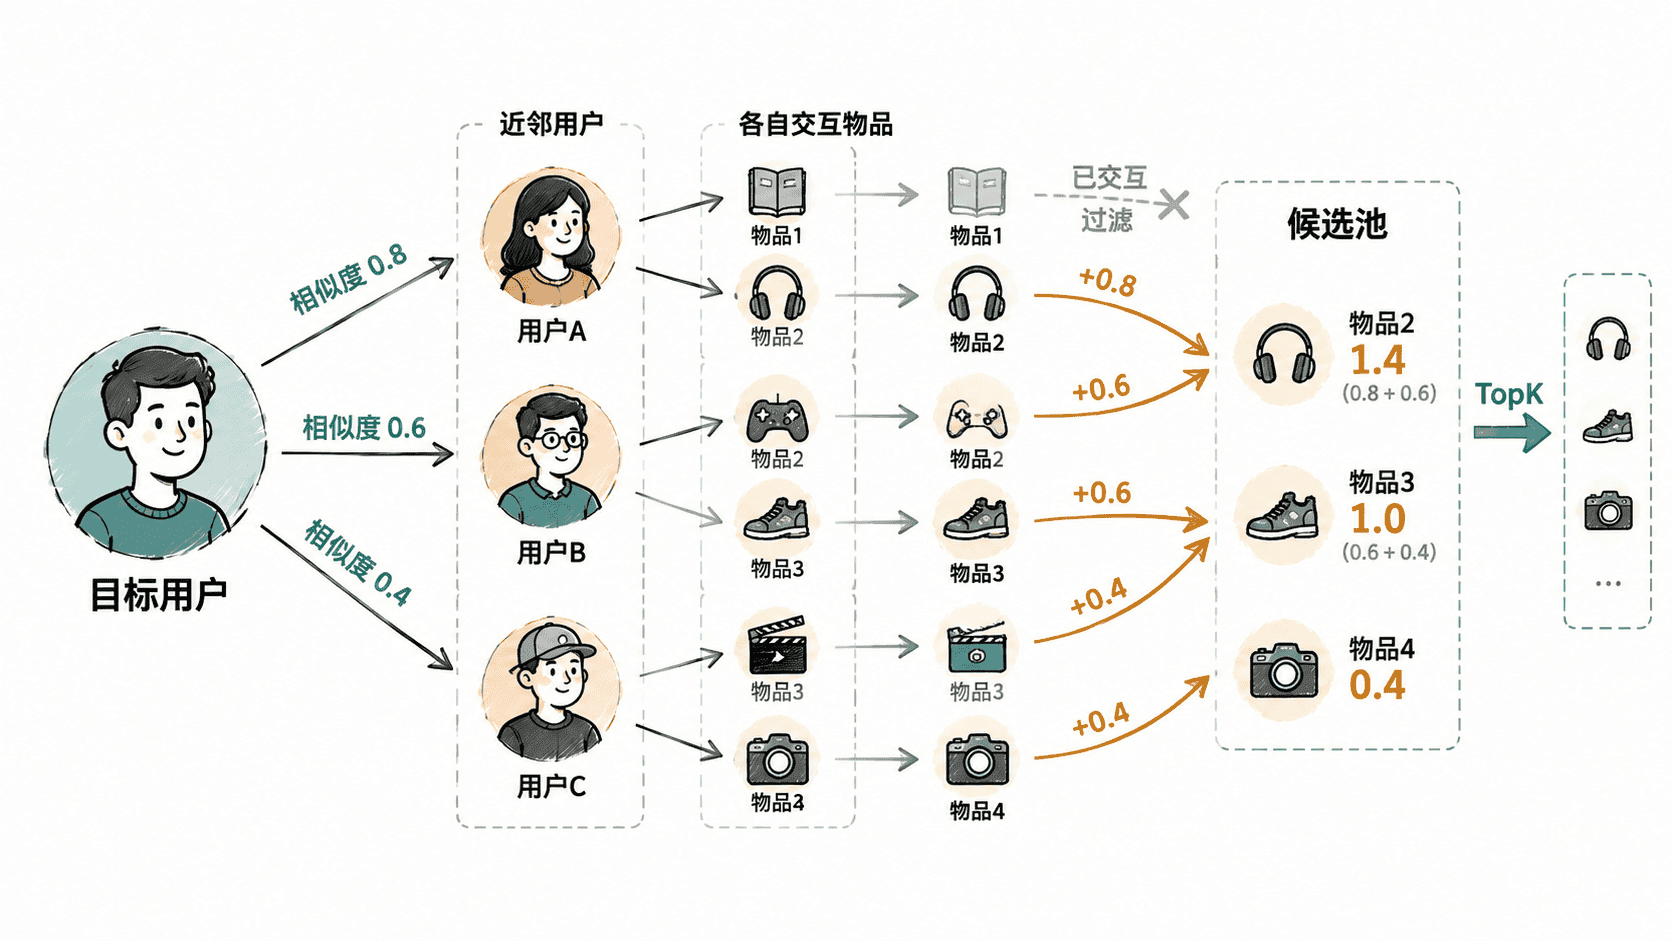
设用户 u 交互过的物品集合为 。最基础的二值余弦相似度可以写成 。共同交互越多,相似度越高;同时分母会抑制“谁都看很多”的活跃用户直接占据近邻榜。
得到近邻后,对每个近邻,把目标用户已经看过的物品剔除,再把该近邻与目标用户的相似度累加到剩余物品上。最终按候选分数降序取 TopK,这一步才真正形成召回结果。
跑通近邻召回与离线评估
下面把每个用户的训练交互保存为集合。scan_ops 统计“选中近邻后实际扫描了多少个未看物品”,用于直观看到近邻数量增加后候选聚合工作的增长;示例仍然只让测试集参与命中判断。
from math import sqrt

train = {
    'u1': {'A', 'B'},
    'u2': {'A', 'C', 'D'},
    'u3': {'B', 'C', 'E'},
    'u4': {'A', 'B', 'D'},
}
test = {'u1': 'C', 'u2': 'B', 'u3': 'D', 'u4': 'E'}
TOP_K = 2


def cosine_binary(left, right):
    if not left or not right:
        return 0.0
    return len(left & right) / sqrt(len(left) * len(right))


def recommend(user, neighbor_k):
    neighbors = []
    for other in sorted(train):
        if other == user:
            continue
        similarity = cosine_binary(train[user], train[other])
        if similarity > 0:
            neighbors.append((other, similarity))

    neighbors.sort(key=lambda pair: (-pair[1], pair[0]))
    item_scores = {}
    scan_ops = 0

    for other, similarity in neighbors[:neighbor_k]:
        for item in train[other] - train[user]:
            scan_ops += 1
            item_scores[item] = item_scores.get(item, 0.0) + similarity

    ranked = sorted(item_scores.items(), key=lambda pair: (-pair[1], pair[0]))
    return [item for item, _ in ranked[:TOP_K]], scan_ops


def evaluate(neighbor_k):
    recs = {}
    total_scan_ops = 0
    for user in sorted(train):
        recs[user], scan_ops = recommend(user, neighbor_k)
        total_scan_ops += scan_ops

    hits = sum(test[user] in recs[user] for user in test)
    catalog = set().union(*train.values())
    recommended = {item for items in recs.values() for item in items}
    recall = hits / len(test)
    coverage = len(recommended) / len(catalog)
    return recall, coverage, total_scan_ops


def main():
    for neighbor_k in (1, 2, 3):
        recall, coverage, scan_ops = evaluate(neighbor_k)
        print(
            f'neighbors={neighbor_k} recall@{TOP_K}={recall:.2f} '
            f'coverage={coverage:.2f} scan_ops={scan_ops}'
        )


if __name__ == '__main__':
    main()
预期输出
neighbors=1 recall@2=0.25 coverage=0.60 scan_ops=3
neighbors=2 recall@2=0.75 coverage=0.80 scan_ops=9
neighbors=3 recall@2=1.00 coverage=1.00 scan_ops=17
这个小样例说明了典型趋势:近邻变多后,可汇总的候选更丰富,Recall@2 和覆盖率可能上升,但扫描和聚合的工作也同步增加。真实数据上指标不会单调变好,因此应在固定数据切分下做参数扫描,而不是默认近邻越多越好。
活跃用户偏置不能只靠共同次数
如果直接把“共同交互数量”当相似度,交互数很多的活跃用户会更容易与所有人产生较大交集,近邻列表会被他们占据。二值余弦通过用户集合长度做了归一化,已经比裸共同次数稳健,但热门物品仍可能让两个兴趣并不相近的用户产生虚假相似。
数据更大时,可以进一步降低超热门物品的贡献,例如给“被很多用户交互的物品”更低权重;也可以对只靠一两个共同物品得到的高相似度加入收缩。无论采用哪种修正,都应保持只用训练交互计算相似度,否则仍会发生离线数据泄漏。
近邻数量要和计算路径一起调
上例的 scan_ops 只统计候选聚合,不包含全量用户两两相似度计算。朴素 UserCF 若在线现算相似度,用户规模一大就会先卡在近邻搜索,而不是候选排序。因此工程上通常会离线预计算 TopN 相似用户,或把用户表示放入近邻检索结构,线上只做少量近邻读取与候选汇总。
一个可用于后续实验的 UserCF 召回器,应同时满足四个条件:相似度只由训练集产生、近邻排序可复现、已交互物品严格过滤、近邻数量变化能用离线指标和计算量共同解释。做到这些后,再比较不同相似度修正或近邻检索方案才有意义。