
机器学习与深度学习 / 系统课时
阻断特征泄漏与训练穿越
阻断特征泄漏与训练穿越
推荐模型离线指标异常漂亮,却在线毫无提升,最常见的原因之一就是特征看到了“未来”。本节用样本时间戳统一检查统计窗口、标签时间和特征快照,确保每个训练样本只使用当时真实可获得的信息。
学习目标
- 能识别未来点击、全量热度和测试期统计等典型泄漏
- 能用样本时间戳验证每个特征的可用时间边界
- 能建立训练、验证与在线一致的时间快照规则
先确定样本能够看到的时间边界
对任意训练样本,都应先定义一个样本时间 t0。在 t0 之后发生的点击、成交、曝光结果和统计数据,都不能用于构造这个样本在 t0 时刻的输入特征。
标签则通常来自未来窗口。例如以 t0 的一次曝光作为样本,观察之后 30 分钟内是否点击,那么特征窗口必须截止到 t0,而标签窗口可以位于 t0 之后。二者用途不同,不能因为标签需要未来数据,就允许特征也读取未来数据。
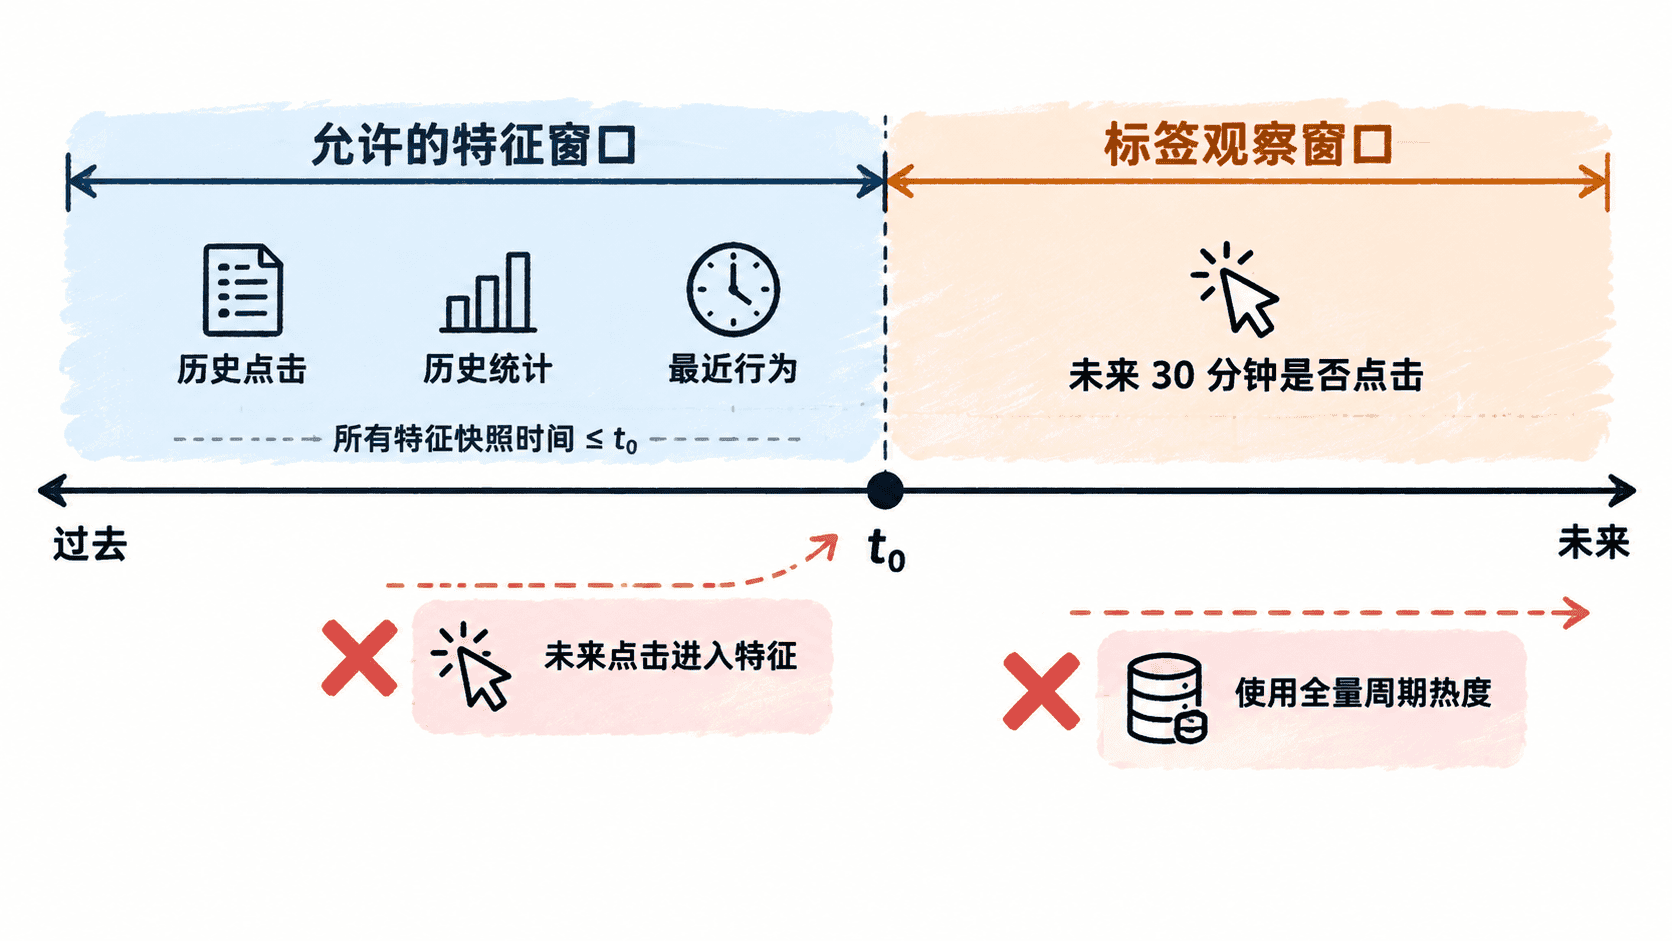
最重要的检查条件可以直接写成:对每一个特征值,都应该存在一个 feature_available_time <= sample_time 的事实依据。只要某个值必须等到样本发生之后才能算出来,它就不应该出现在当前样本中。
三种最常见的穿越方式
第一类是未来行为直接进入序列。例如样本时间为 10:00,却在构造“最近 20 次点击”时从整天日志中直接取最后 20 条,这些记录可能包含 11:00、15:00 甚至晚上发生的点击。
第二类是全量统计特征。假设要训练 9 月 1 日的样本,却用“9 月整月物品点击率”作为热度特征,那么 9 月 20 日、30 日的数据已经泄漏给月初样本。离线模型会提前知道哪些物品后来变热门。
第三类是数据集切分之后仍使用全局聚合。例如先按时间切出训练集和测试集,再用训练加测试的全部数据计算用户点击次数、类别 CTR 或标准化均值。即使标签列没有直接进入特征,测试期信息仍然通过统计量渗入训练过程。
用时间戳自动验证特征
人工审查 SQL 或特征代码容易漏掉窗口边界,最好让样本携带 sample_time,并让关键特征同时记录其来源数据的最大时间。只要发现来源时间晚于样本时间,就立即失败。
下面的 Python 示例模拟一个最小泄漏检查器。它验证每个样本的历史事件时间是否都早于样本时间,并显式报告穿越记录。
from datetime import datetime


def validate_history(sample_time, history_events):
    # 任意历史事件晚于或等于样本时刻,都不应进入当前特征。
    leaked = [event for event in history_events if event["time"] >= sample_time]
    if leaked:
        latest = max(event["time"] for event in leaked)
        raise ValueError(
            f"feature leakage: latest_event={latest.isoformat()} "
            f">= sample_time={sample_time.isoformat()}"
        )
    return "OK"

sample_time = datetime(2026, 9, 14, 10, 0, 0)
history_events = [
    {"item_id": 101, "time": datetime(2026, 9, 14, 9, 20, 0)},
    {"item_id": 205, "time": datetime(2026, 9, 14, 9, 50, 0)},
]

print(validate_history(sample_time, history_events))
预期输出:
OK如果把第二条事件改为 10:05,程序会抛出 ValueError。这种断言适合放进离线特征测试、训练数据构建任务或数据质量检查中,让时间边界从文档约定变成可执行约束。
统计特征必须使用历史快照
热度、CTR、用户活跃度等聚合特征尤其容易穿越。正确做法不是维护一个“最终统计表”再回填所有历史样本,而是根据样本时间查询对应快照,或者只聚合样本时间之前的数据。
例如构造过去 7 天物品点击次数时,对 9 月 14 日 10:00 的样本,应统计 9 月 7 日 10:00 到 9 月 14 日 10:00 之前的数据,而不是使用 9 月 14 日全天数据。若批处理只能按天生成快照,则必须明确当天样本究竟只能使用前一日快照,还是系统能够提供小时级快照。
一个可靠的特征表通常至少要能追踪 entity_id、特征值和 snapshot_time。训练关联时必须保证 snapshot_time <= sample_time,并在满足条件的记录中选择最近一份快照。
SELECT
    s.sample_id,
    s.item_id,
    s.sample_time,
    f.click_count_7d,
    f.snapshot_time
FROM training_sample AS s
LEFT JOIN item_feature_snapshot AS f
    ON f.item_id = s.item_id
   AND f.snapshot_time = (
       SELECT MAX(f2.snapshot_time)
       FROM item_feature_snapshot AS f2
       WHERE f2.item_id = s.item_id
         AND f2.snapshot_time <= s.sample_time
   );
这是查询片段示例,依赖 training_sample 与 item_feature_snapshot 两张已有表。其生效行为是:每个训练样本只关联样本时刻之前最近的一份物品特征快照。验证时应额外检查结果中不存在 snapshot_time > sample_time 的记录。
在训练前做时间一致性验收
上线前不要只看 AUC、NDCG 等模型指标,还要对数据做时间审计。最有效的方法是随机抽取若干样本,从最终训练行反查原始日志,逐项确认用户历史、物品统计、上下文特征和快照时间在 sample_time 当时都确实存在。
训练集、验证集和测试集的统计计算也要彼此隔离。验证集特征只能使用验证样本当时可获得的历史,测试集同理,不能为了“方便统一计算”而先聚合完整周期再切分。
当离线指标突然大幅提升时,首先检查时间边界往往比继续调参更有价值。推荐系统里的高质量训练样本,不只是标签正确,还必须保证每个特征都来自那个时间点真实可见的世界。