
机器学习与深度学习 / 系统课时
把序列行为转成兴趣特征
把序列行为转成兴趣特征
用户最近浏览、点击、收藏的内容,本质上是一段带时间顺序的行为序列。本节把这段不定长序列压缩成固定长度特征,包括序列长度、类别分布、目标相似度和时间间隔,并通过截断控制极端活跃用户的计算成本。
学习目标
- 能从最近 N 次行为中构造稳定的统计与相似度特征
- 理解序列截断、时间衰减和目标相关特征各自解决的问题
- 能为轻量排序模型与深度排序模型准备一致的特征输入
从行为序列得到固定长度向量
排序模型通常要求每个候选样本拥有固定结构的输入,但用户行为数并不固定。有人只有 2 次点击,也有人一天产生上千次行为,因此不能直接把完整历史无上限地塞给模型。
常用做法是以当前待排序物品为目标,只读取目标发生时间之前最近 N 次行为,再把序列转换为几组固定维度特征:序列规模、类别偏好、与目标物品的相似程度,以及行为距离当前时刻的时间间隔。
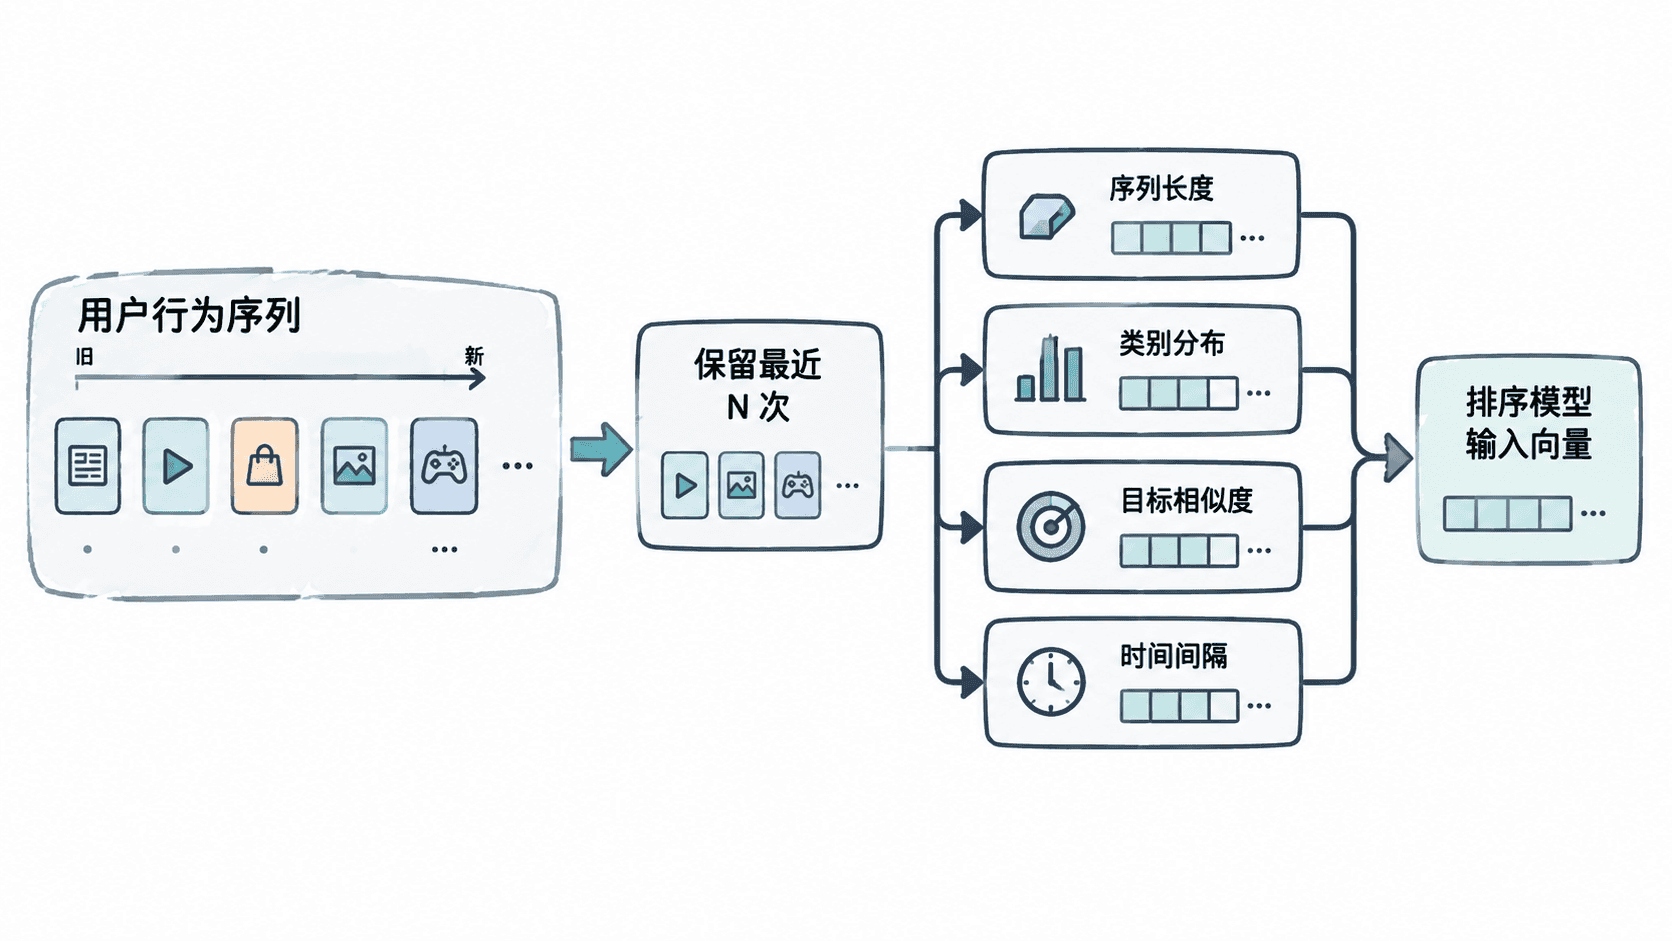
序列长度本身也有价值。较长的近期序列通常意味着用户当前更活跃,但直接使用原始长度容易让极端用户形成异常大值,所以实践中经常同时保留 raw_length 与截断后的 used_length,或者对长度取 log1p。
构造四类核心特征
假设候选物品属于“数码”类别,用户最近 5 次行为类别依次是“数码、数码、图书、数码、运动”。类别分布可以表示为数码占比 0.6、图书占比 0.2、运动占比 0.2。相比只记录最后一次点击,这种统计更抗噪声。
目标相似度需要围绕当前候选物品计算。最简单的版本可以使用“最近 N 次行为中与目标同类别的比例”;如果已有物品向量,则可以进一步计算目标向量与历史物品向量的最大、平均或加权余弦相似度。
时间间隔描述兴趣的新鲜程度。常见特征包括距最近一次行为的秒数、最近若干次行为平均间隔,以及各行为距当前样本时间的衰减权重。时间值跨度很大时,通常对秒数使用 log1p,避免几秒与几个月直接落在同一线性尺度上。
下面用一个可运行的 Python 示例生成轻量模型可直接消费的序列特征。示例只保留最近 5 次行为,并且严格忽略样本时间之后的事件。
from collections import Counter
from datetime import datetime
from math import log1p

MAX_SEQ_LEN = 5

def build_features(events, target_category, sample_time):
    # 只保留样本时刻之前的行为,防止把未来事件带入当前样本。
    valid = [e for e in events if e["time"] < sample_time]
    valid.sort(key=lambda e: e["time"])

    raw_length = len(valid)
    recent = valid[-MAX_SEQ_LEN:]
    used_length = len(recent)

    counts = Counter(e["category"] for e in recent)
    same_category_ratio = (
        counts[target_category] / used_length if used_length else 0.0
    )

    # 时间差取 log1p,压缩从秒级到天级的巨大数值跨度。
    if recent:
        last_gap_seconds = (sample_time - recent[-1]["time"]).total_seconds()
        last_gap_log = log1p(last_gap_seconds)
    else:
        last_gap_log = 0.0

    return {
        "raw_length": raw_length,
        "used_length": used_length,
        "target_category_ratio": round(same_category_ratio, 3),
        "last_gap_log": round(last_gap_log, 3),
    }

sample_time = datetime(2026, 9, 14, 12, 0, 0)
events = [
    {"category": "图书", "time": datetime(2026, 9, 14, 9, 0, 0)},
    {"category": "数码", "time": datetime(2026, 9, 14, 9, 30, 0)},
    {"category": "运动", "time": datetime(2026, 9, 14, 10, 0, 0)},
    {"category": "数码", "time": datetime(2026, 9, 14, 10, 30, 0)},
    {"category": "数码", "time": datetime(2026, 9, 14, 11, 0, 0)},
    {"category": "家居", "time": datetime(2026, 9, 14, 11, 30, 0)},
]

print(build_features(events, "数码", sample_time))
预期输出:
{'raw_length': 6, 'used_length': 5, 'target_category_ratio': 0.6, 'last_gap_log': 7.496}其中 raw_length 反映用户真实活跃度,used_length 表示模型实际消费的序列长度。因为最近 5 次行为中有 3 次属于“数码”,所以目标类别占比为 0.6。
限制序列长度而不是无限堆历史
序列越长并不一定越好。很久以前的点击通常只能提供弱信号,却会持续放大内存、特征计算和在线延迟。如果深度模型直接编码序列,复杂度还可能随长度明显上升。
实践中可以先从 20、50、100 等几个上限做离线实验,再根据指标与延迟选择折中点。对于轻量树模型,通常保留最近 N 次后做统计即可;对于 Transformer 一类深度排序模型,则还需要统一补齐、掩码和截断策略。
序列截断规则必须在训练与在线服务中保持一致。训练使用最近 50 次、线上却只读取 20 次,会产生训练与服务偏差,即使字段名完全一样,特征分布也已经不同。
让同一套特征服务不同模型
轻量模型和深度模型可以共享相同的原始序列预处理。先统一完成事件过滤、时间排序、长度截断和缺失值处理,再分别派生统计特征或序列张量,能显著减少两套流水线不一致的问题。
对 GBDT、LR 等轻量模型,可以直接输入长度、类别占比、相似度统计和时间间隔;对深度排序模型,则可以在这些聚合特征之外继续保留物品 ID、类别 ID、行为类型和相对时间组成的序列张量。
真正需要稳定的是“样本时刻能看到哪些行为”和“最多保留多少条”。只要先固定这两个边界,后续增加相似度、衰减权重或深度编码器时,特征工程就不会因为用户历史无限增长而失控。