
机器学习与深度学习 / 系统课时
构造排序训练样本与标签
构造排序训练样本与标签
排序模型能否学到可靠偏好,首先取决于训练样本是否准确描述“用户看到了什么,以及后来是否发生目标行为”。本节以曝光为样本单位,把点击和上下文按时间连接起来,定义观察窗口与正负标签,并检查标签在不同时间窗口下是否稳定。
学习目标
- 能以曝光事件为基准构造排序模型的正负训练样本
- 能正确设置点击观察窗口,避免把未来行为错误归因到历史曝光
- 能识别只使用点击日志造成的选择偏差,并检查标签稳定性
为什么样本必须从曝光开始
如果直接把点击日志当作正样本,再随机抽未点击物品作为负样本,模型会混淆“用户看到了但没点”和“用户根本没有看到”。后者并不能证明用户不喜欢这个物品,因此不是可靠负样本。
正确做法是以每一次曝光作为样本单位。曝光发生时冻结用户、物品和场景特征,再观察随后一段时间内是否产生目标行为。这样每个正样本和负样本都来自模型曾经真正展示过的候选。
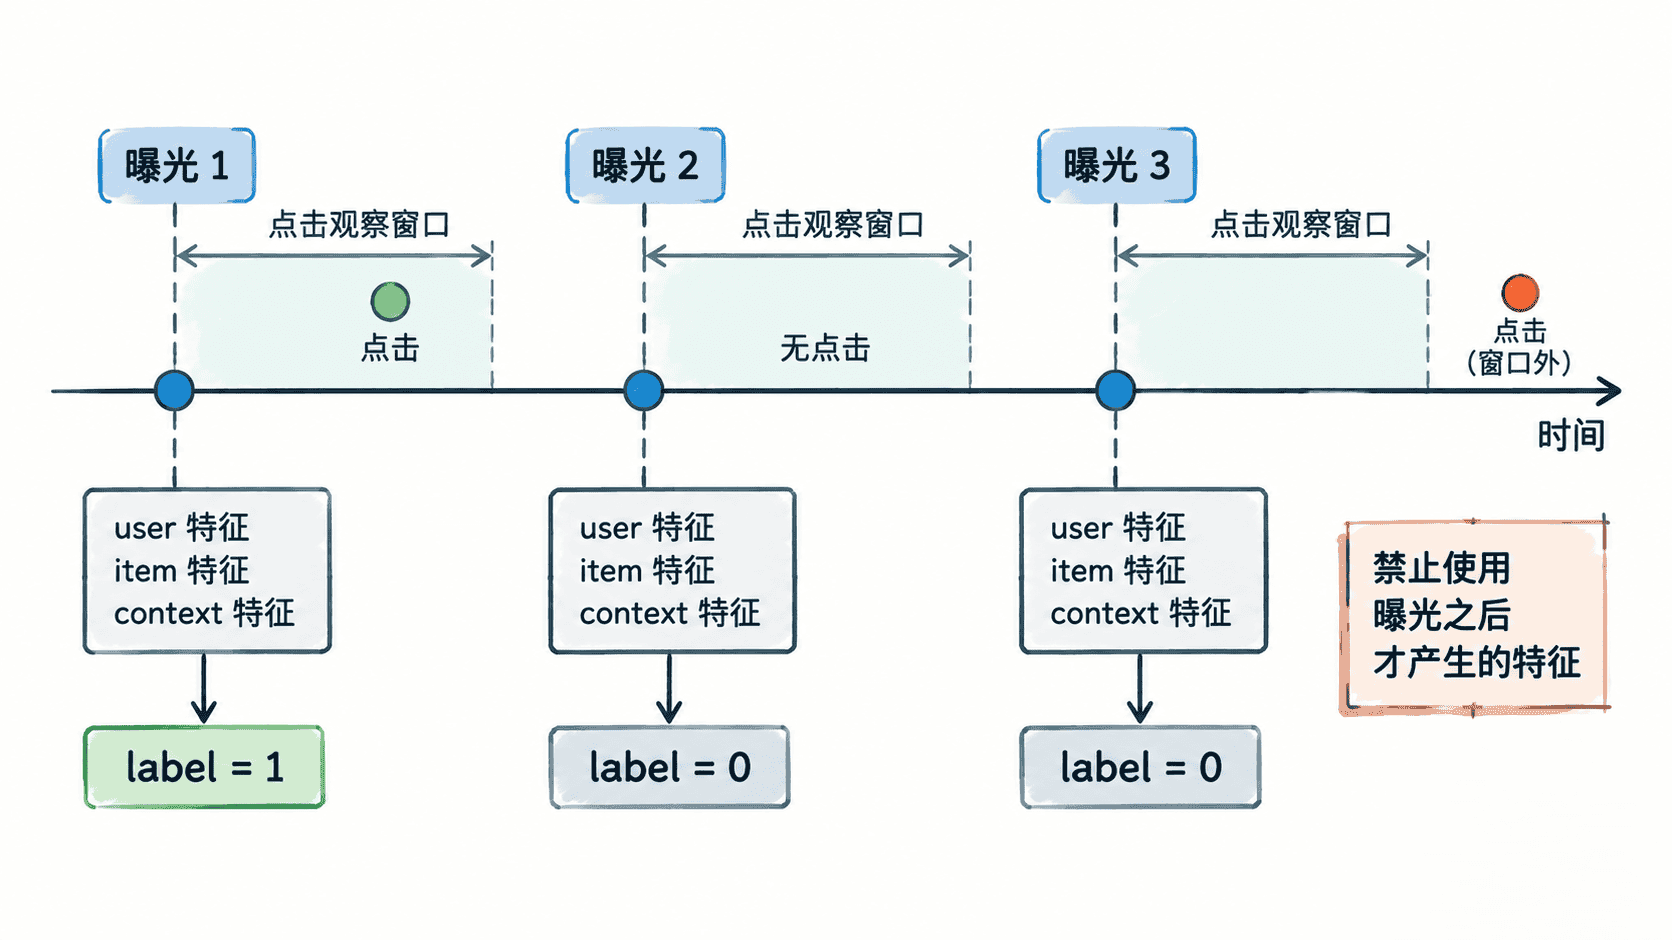
用观察窗口生成正负标签
点击标签最常见的定义是:曝光后 分钟内存在对应用户和物品的点击,则标签为 1,否则为 0。窗口不能无限延长,否则一次很晚发生的点击可能被错误归因给很早以前的曝光。
下面使用 PostgreSQL 的 VALUES 构造一个可直接执行的最小示例。观察窗口设为 10 分钟,并且只接受曝光之后发生的点击。
WITH exposure_log AS (
    SELECT * FROM (VALUES
        (1, 'u1', 'i1', TIMESTAMP '2026-09-14 10:00:00'),
        (2, 'u1', 'i2', TIMESTAMP '2026-09-14 10:05:00'),
        (3, 'u2', 'i3', TIMESTAMP '2026-09-14 11:00:00')
    ) AS t(exposure_id, user_id, item_id, exposure_time)
),
click_log AS (
    SELECT * FROM (VALUES
        ('u1', 'i1', TIMESTAMP '2026-09-14 10:03:00'),
        ('u1', 'i2', TIMESTAMP '2026-09-14 10:30:00')
    ) AS t(user_id, item_id, click_time)
)
SELECT
    e.exposure_id,
    e.user_id,
    e.item_id,
    CASE WHEN COUNT(c.click_time) > 0 THEN 1 ELSE 0 END AS label
FROM exposure_log e
LEFT JOIN click_log c
    ON c.user_id = e.user_id
   AND c.item_id = e.item_id
   AND c.click_time >= e.exposure_time
   AND c.click_time < e.exposure_time + INTERVAL '10 minutes'
GROUP BY e.exposure_id, e.user_id, e.item_id
ORDER BY e.exposure_id;
预期结果:
 exposure_id | user_id | item_id | label
-------------+---------+---------+-------
           1 | u1      | i1      |     1
           2 | u1      | i2      |     0
           3 | u2      | i3      |     0
第二条曝光虽然最终发生了点击,但点击时间距离曝光 25 分钟,已经超出 10 分钟观察窗口,因此本次样本仍然记为负样本。这个规则保证标签含义固定,不会随着后续无限增长的日志反复变化。
特征时间必须与曝光时间对齐
训练样本不仅要正确连接标签,还要防止特征穿越。用户过去 7 天点击数、物品累计热度、库存和价格等特征,都应该取曝光发生时已经可知的值,而不是直接读取今天最新的离线快照。
例如模型预测 10:00 的一次曝光,却使用了当天 23:00 才汇总出的物品点击量,那么模型实际上提前看到了未来信息。离线指标可能异常漂亮,但线上无法获得同样信息,效果通常会明显下降。
检查标签在不同窗口下是否稳定
观察窗口太短会把真实的延迟点击判成负样本,太长又会增加错误归因。实际训练前可以分别生成 5 分钟、10 分钟和 30 分钟标签,比较正样本率以及同一曝光的标签变化比例。
如果从 10 分钟扩大到 30 分钟后,正样本率只增加很少,说明 10 分钟已经覆盖大部分点击;如果大量样本从 0 变成 1,则需要结合业务决策周期重新选择窗口。电商详情页点击、长视频消费和高客单价购买的合理观察窗口往往不同,不能统一照搬。
还要按用户活跃度、推荐场景和物品类型拆分统计。某个全局窗口可能对高频用户稳定,却对低频用户产生大量延迟行为,因此标签稳定性应和实际业务节奏一起判断。
避免训练数据继承旧策略偏差
即使以曝光为基准,样本仍然来自旧推荐策略展示过的物品。旧策略从未展示的内容没有机会获得点击,因此训练数据并不是整个物品空间的随机样本。这就是排序训练中的选择偏差来源之一。
工程上可以先保证曝光日志完整记录候选来源、位置和策略版本,再通过随机流量、探索流量或合适的样本加权逐步缓解偏差。首要任务不是立即加入复杂校正算法,而是确保每条训练样本都能追溯到真实曝光、确定的观察窗口和当时可用的特征。
当曝光、特征时间点和标签窗口三者严格对齐后,排序模型看到的才是一个可复现的学习问题:给定当时真实可见的信息,预测用户是否会在规定时间内产生目标行为。