
机器学习与深度学习 / 系统课时
定义信息流推荐项目目标
定义信息流推荐项目目标
信息流推荐项目最容易失败在“模型指标很好,但上线不解决业务问题”。开始实现前,应先把推荐位置、候选规模、延迟预算、主指标、护栏指标、数据边界和验收标准写成一份可检查的项目契约,让离线实验、在线服务和最终验收围绕同一目标推进。
学习目标
- 把业务目标转换为可计算的主指标、护栏指标和性能预算。
- 明确训练、评估与在线服务的数据边界,避免离线结果不可复现。
- 把最终验收条件写成可重复执行的离线与在线检查项。
先固定推荐场景与链路边界
“做一个信息流推荐系统”仍然太宽。项目首先要明确推荐发生在哪里、一次请求处理多少候选、谁负责过滤、排序输出多少条,以及端到端允许消耗多少时间。否则团队会在不同假设下优化各自的局部指标。
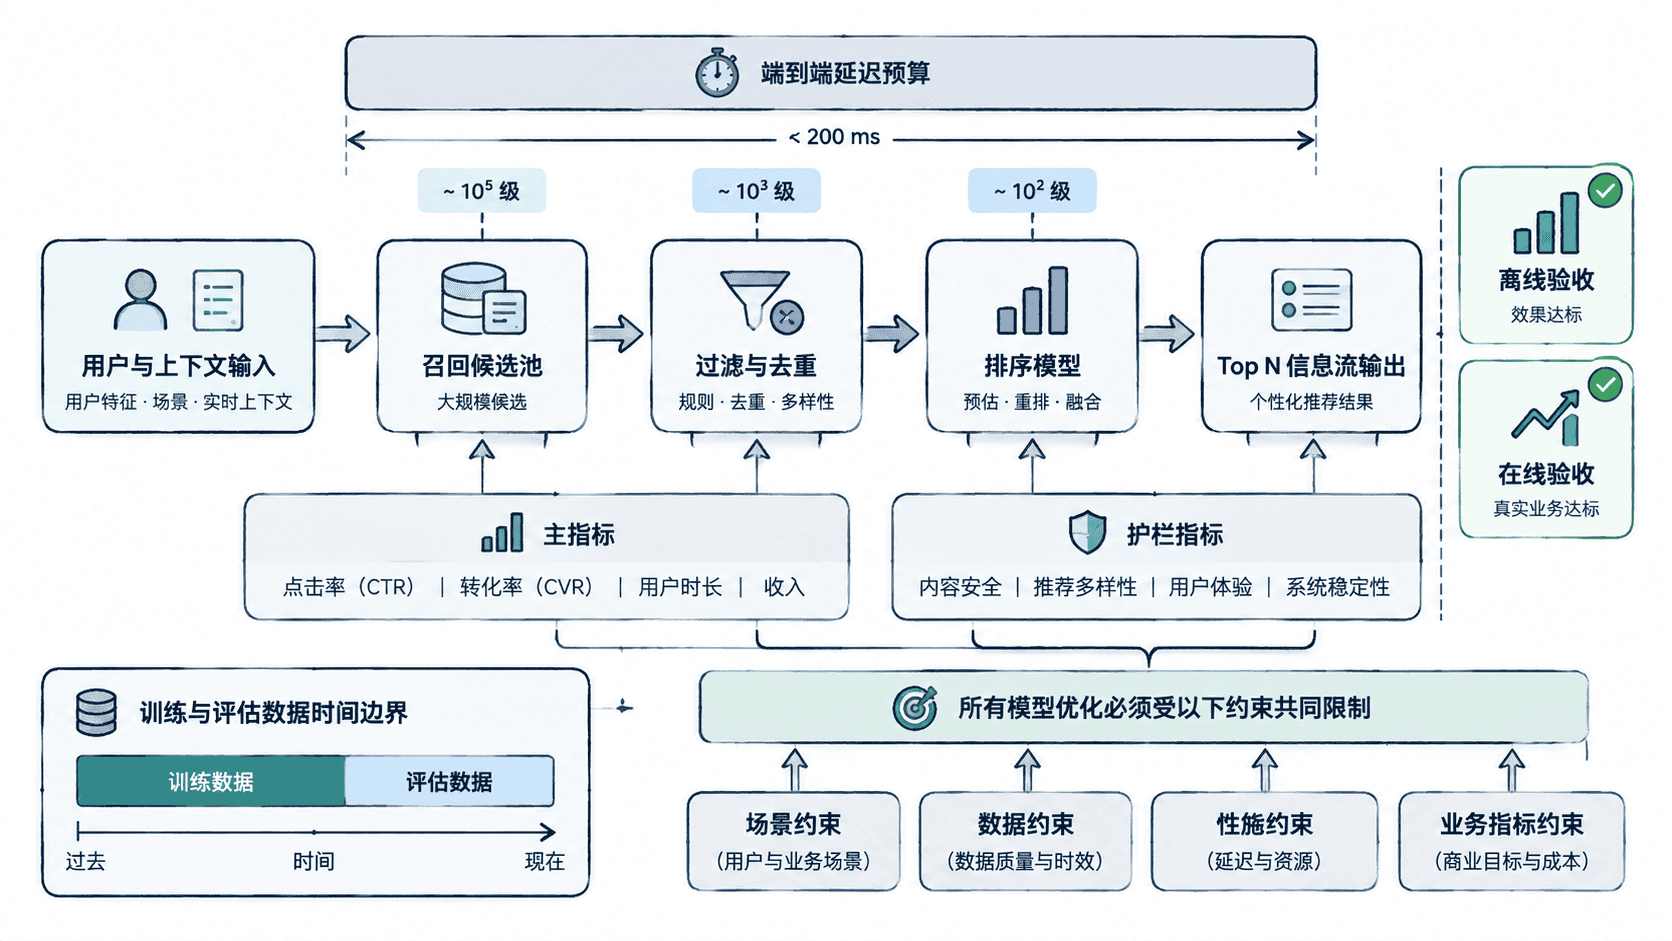
一个可执行的项目定义至少回答这些问题:推荐位置是首页首屏还是无限下拉;一次请求初始候选是几百还是几千;最终返回多少条;是否允许热门内容兜底;P95 延迟预算是多少;哪些内容必须过滤;哪些用户或内容不进入实验。
候选规模与延迟预算要一起确定。候选越多,理论上的可选空间越大,但召回、特征获取和排序成本也会上升。项目目标不是“候选越多越好”,而是在给定延迟和资源预算下获得足够覆盖。
把业务目标写成指标契约
主指标只保留一个最能代表当前阶段价值的指标,例如 CTR、有效播放率或下单转化率。若同时把多个指标都写成“必须最大化”,模型优化很容易失去方向。其余不可明显恶化的指标应作为护栏。
| 类型 | 示例 | 作用 |
|---|---|---|
| 主指标 | CTR 提升不少于 3% | 决定实验是否达到主要业务目标 |
| 体验护栏 | 负反馈率不升高超过 0.2 个百分点 | 防止用点击收益换来明显体验损失 |
| 供给护栏 | 内容覆盖率不低于基线的 98% | 防止流量过度集中 |
| 性能护栏 | 排序服务 P95 不高于 80 ms | 保证效果提升可以在线落地 |
相对提升和绝对变化必须写清楚。“CTR 提升 3%”通常表示相对提升,而“提升 3 个百分点”表示绝对变化,两者不能混用。所有在线指标还要提前确定统计窗口、实验单位和显著性规则。
固定数据边界与离线协议
离线数据必须使用明确的时间窗口,并保证特征只来自样本发生时已经可获得的信息。若训练样本使用未来行为、评估集与训练集按用户泄漏,离线指标再高也没有验收价值。
可以把关键约束写成项目配置,作为训练、评估和验收脚本共同读取的契约。下面是片段示例,依赖具体项目的数据表和服务名称,但字段应保持机器可读。
scene: home_feed
candidate_size: 1000
result_size: 20
latency_budget_ms:
  p95: 80
offline_split:
  train_end: "2026-08-31"
  eval_start: "2026-09-01"
  eval_end: "2026-09-07"
acceptance:
  auc_min: 0.72
  coverage_min: 0.85
  ctr_relative_lift_min: 0.03
  negative_feedback_delta_max: 0.002
这类配置本身不产生控制台输出。验证方法是让训练、离线评估、压测和实验验收都读取同一份阈值,避免指标名称、时间窗口或性能预算在不同脚本里各写一套。
把验收条件做成可重复检查
最终验收不要写成“效果明显提升”或“延迟基本可接受”,而要把条件变成确定的布尔判断。下面用一个最小 Python 示例检查四个核心条件,真实项目可把测量值替换为离线评估、压测和 A/B 实验产出的结果。
measured = {
    "auc": 0.735,
    "coverage": 0.88,
    "ctr_relative_lift": 0.041,
    "p95_latency_ms": 74,
}

checks = {
    "auc": measured["auc"] >= 0.72,
    "coverage": measured["coverage"] >= 0.85,
    "ctr_lift": measured["ctr_relative_lift"] >= 0.03,
    "latency": measured["p95_latency_ms"] <= 80,
}

for name, passed in checks.items():
    print(f"{name}: {'PASS' if passed else 'FAIL'}")

print("ACCEPT" if all(checks.values()) else "REJECT")
预期输出:
auc: PASS
coverage: PASS
ctr_lift: PASS
latency: PASS
ACCEPT
离线验收应至少固定数据版本、模型版本、评估集时间窗口和随机种子;在线验收则固定实验流量、持续时间、主指标、护栏指标与延迟预算。只有这些条件都可复现,项目目标才真正具备工程约束力。
用一页项目定义约束后续迭代
项目启动前应形成一页可执行定义:场景边界明确,候选规模和返回条数固定,P95 延迟有预算,主指标只有一个,护栏覆盖体验、供给和性能,训练与评估时间窗可追溯,离线与在线验收都有明确通过条件。
后续更换召回算法、排序模型或特征方案时,都只是在这份契约内寻找更优解。若业务场景或约束发生变化,应先更新项目定义再比较新旧方案,而不是用新的统计口径解释旧实验结果。