
CI/CD / 系统课时
演练故障与回滚
演练故障与回滚
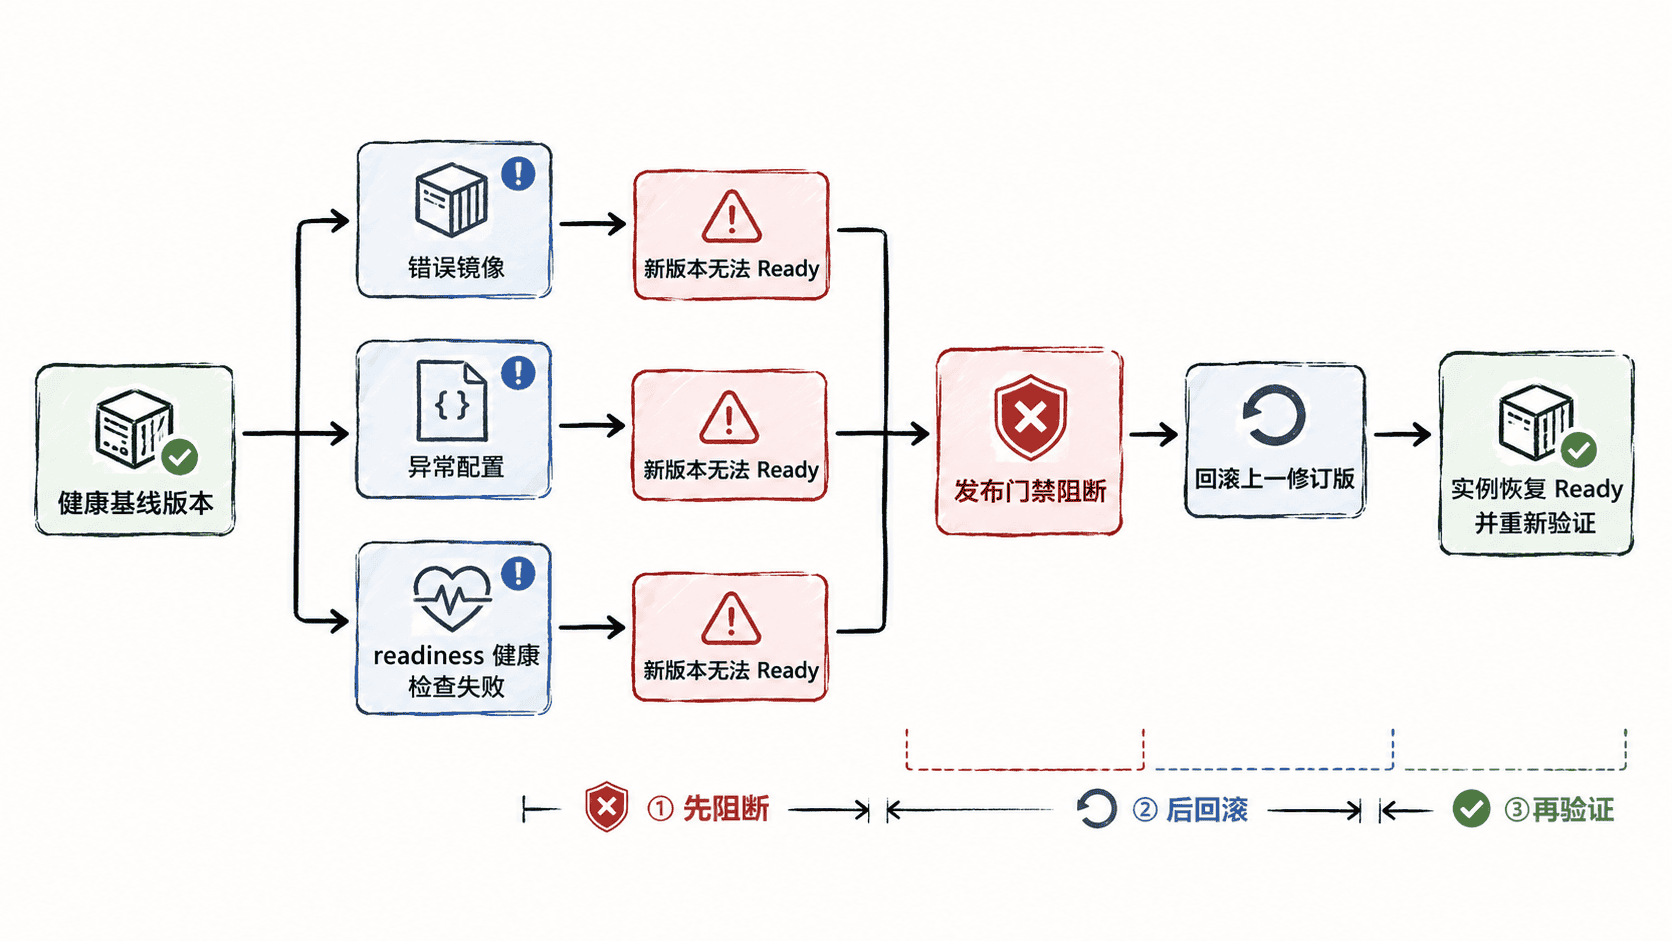
回滚能力只有在故障真正发生时验证过才可信。本课用受控 Deployment 分别制造镜像错误、配置异常和健康检查失败,观察发布门禁如何阻断新版本,并确认 rollout undo 能把工作负载恢复到上一版可用状态。
学习目标
- 用可重复方式注入三类常见发布故障
- 验证失败版本不会被继续放量
- 检查回滚后的工作负载是否重新达到 Ready
建立受控演练对象
故障演练不要直接破坏整组生产实例。更稳妥的做法是在独立命名空间、预发布环境或极小灰度批次中复现相同发布机制,再验证门禁与回滚动作。本例创建两个副本,并把配置值和 readiness probe 都放进 Deployment,便于后续精确注入故障。
apiVersion: v1
kind: Namespace
metadata:
  name: release-drill
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: release-drill
  namespace: release-drill
spec:
  replicas: 2
  selector:
    matchLabels:
      app: release-drill
  template:
    metadata:
      labels:
        app: release-drill
    spec:
      containers:
        - name: app
          image: busybox:1.36
          env:
            - name: APP_CONFIG
              value: "ok"
          command: ["sh", "-c"]
          args:
            - |
              test "$APP_CONFIG" = "ok" || exit 42
              mkdir -p /www
              printf 'ok\n' > /www/healthz
              httpd -f -p 8080 -h /www
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /healthz
              port: 8080
            periodSeconds: 2
failureThreshold: 2这份配置的生效行为很明确:APP_CONFIG 不是 ok 时容器直接退出;readiness probe 指向不存在的路径时 Pod 不会 Ready;镜像标签不存在时会进入拉取失败。保存为 drill.yaml 后先建立健康基线。
kubectl apply -f drill.yaml >/dev/null
kubectl -n release-drill rollout status \
  deployment/release-drill --timeout=60s >/dev/null
printf 'baseline=ready\n'
预期输出
baseline=ready注入故障并触发回滚
下面脚本通过 FAULT 选择故障类型。bad-image 使用不存在的镜像标签,bad-config 让容器因配置值退出,bad-health 把 readiness probe 改到不存在的路径。脚本期望新版本在限定时间内无法成功滚动;如果它反而成功,就把演练判为失败。
#!/usr/bin/env bash
set -euo pipefail

NAMESPACE="${NAMESPACE:-release-drill}"
DEPLOYMENT="${DEPLOYMENT:-release-drill}"
FAULT="${FAULT:-bad-image}"

case "$FAULT" in
  bad-image)
    kubectl -n "$NAMESPACE" set image \
      deployment/"$DEPLOYMENT" \
      app=busybox:this-tag-does-not-exist >/dev/null
    ;;
  bad-config)
    kubectl -n "$NAMESPACE" set env \
      deployment/"$DEPLOYMENT" APP_CONFIG=broken >/dev/null
    ;;
  bad-health)
    kubectl -n "$NAMESPACE" patch deployment "$DEPLOYMENT" \
      --type='json' \
      -p='[{"op":"replace","path":"/spec/template/spec/containers/0/readinessProbe/httpGet/path","value":"/missing"}]' \
      >/dev/null
    ;;
  *)
    printf 'unsupported-fault=%s\n' "$FAULT" >&2
    exit 2
    ;;
esac

if kubectl -n "$NAMESPACE" rollout status \
  deployment/"$DEPLOYMENT" --timeout=30s >/dev/null 2>&1; then
  printf 'unexpected-rollout-success\n' >&2
  exit 1
fi

printf 'release-gate=blocked fault=%s\n' "$FAULT"

kubectl -n "$NAMESPACE" rollout undo \
  deployment/"$DEPLOYMENT" >/dev/null
kubectl -n "$NAMESPACE" rollout status \
  deployment/"$DEPLOYMENT" --timeout=60s >/dev/null

printf 'rollback=passed\n'
以 FAULT=bad-config 运行时,预期输出为:
release-gate=blocked fault=bad-config
rollback=passed
换成 bad-image 或 bad-health 时,第一行的故障名称会相应变化。镜像拉取时间、Pod 名称和事件时间属于动态值,实际日志可能不同,但门禁必须先阻断发布,随后回滚恢复成功。
判断回滚是否真的有效
“执行了回滚命令”不是验收标准。至少要确认上一修订版重新 Ready、基础健康检查恢复、发布验证脚本重新通过;如果系统还有数据库迁移、消息格式或外部协议变更,还必须确认旧版本与当前数据和依赖仍兼容。
把演练变成发布能力验收
镜像错误验证的是制品与拉取失败路径,配置异常验证的是启动期故障,健康检查失败验证的是“进程存在但不应接流量”的场景。三类故障覆盖了生产发布中最常见的失败面,也能检验流水线是否真的会在错误版本扩散前停止。
只要故障可以被稳定注入、门禁能拒绝继续发布、回滚后能重新通过健康与业务验证,这条交付链路才具备可验证的止损能力。演练结束后应删除受控资源,避免测试故障长期占用集群配额。