
CI/CD / 系统课时
收集交付指标
收集交付指标
交付指标要把一次提交从构建、部署到故障恢复的关键时间点转换成可比较的数据。完成本节后,你可以用统一事件口径统计构建时长、流水线成功率、部署频率、变更前置时间和恢复时间,并避免把测试环境事件混入生产指标。
学习目标
- 为构建、部署和故障事件定义一致的时间点与统计口径
- 计算构建时长、成功率、部署频率、变更前置时间和恢复时间
- 识别重复部署、取消任务和未恢复故障对指标的影响
先统一时间点和统计口径
构建时长通常取构建步骤开始到结束的差值;流水线成功率按窗口内成功执行数除以已结束执行数;部署频率统计生产环境成功部署次数;变更前置时间从代码变更进入主干或被接受的时间,到该变更成功进入生产环境为止;恢复时间从生产故障被确认,到服务恢复并满足验收条件为止。
最重要的是固定边界。手动重跑是否算新的流水线、回滚是否算部署、取消任务是否进入成功率分母,都要在团队内统一,否则不同仪表盘得到的数字无法比较。
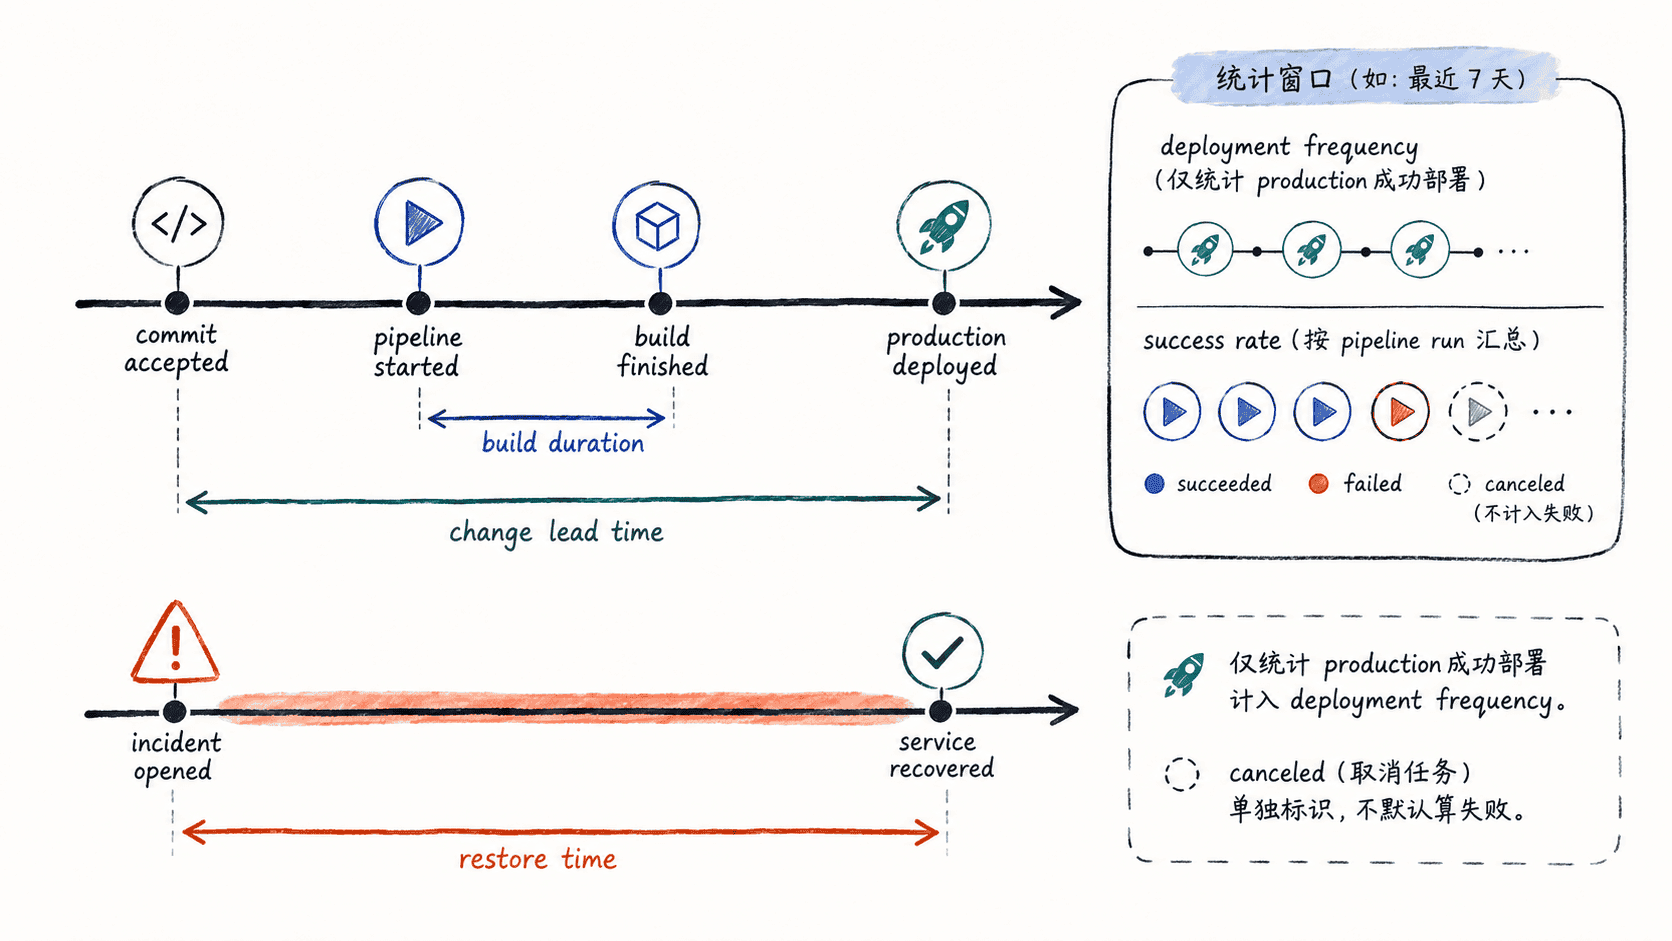
用事件事实计算指标
下面的自包含脚本模拟一个统计窗口内的流水线、生产部署和故障事件,并计算五类指标。真实环境中可把同样字段写入时序数据库或分析仓库,再按相同口径聚合。
cat > /tmp/collect_delivery_metrics.py <<'PY'
from datetime import datetime, timezone
from statistics import median

def ts(value: str) -> datetime:
    return datetime.fromisoformat(value.replace("Z", "+00:00")).astimezone(timezone.utc)

pipelines = [
    {"status": "success", "build_start": "2026-09-03T00:00:00Z", "build_end": "2026-09-03T00:04:00Z"},
    {"status": "failed",  "build_start": "2026-09-03T02:00:00Z", "build_end": "2026-09-03T02:03:00Z"},
    {"status": "success", "build_start": "2026-09-03T04:00:00Z", "build_end": "2026-09-03T04:05:00Z"},
]

deployments = [
    {"environment": "production", "status": "success", "commit_at": "2026-09-03T00:00:00Z", "deployed_at": "2026-09-03T00:20:00Z"},
    {"environment": "production", "status": "success", "commit_at": "2026-09-03T04:00:00Z", "deployed_at": "2026-09-03T04:25:00Z"},
]

incidents = [
    {"opened_at": "2026-09-03T06:00:00Z", "recovered_at": "2026-09-03T06:15:00Z"},
]

build_seconds = [(ts(x["build_end"]) - ts(x["build_start"])).total_seconds() for x in pipelines]
success_rate = sum(x["status"] == "success" for x in pipelines) / len(pipelines)
prod_deployments = [x for x in deployments if x["environment"] == "production" and x["status"] == "success"]
lead_seconds = [(ts(x["deployed_at"]) - ts(x["commit_at"])).total_seconds() for x in prod_deployments]
restore_seconds = [(ts(x["recovered_at"]) - ts(x["opened_at"])).total_seconds() for x in incidents]

print(f"build_duration_median_seconds={median(build_seconds):.0f}")
print(f"pipeline_success_rate={success_rate:.4f}")
print(f"production_deployments_in_window={len(prod_deployments)}")
print(f"change_lead_time_median_seconds={median(lead_seconds):.0f}")
print(f"restore_time_median_seconds={median(restore_seconds):.0f}")
PY

python3 /tmp/collect_delivery_metrics.py
预期输出
build_duration_median_seconds=240
pipeline_success_rate=0.6667
production_deployments_in_window=2
change_lead_time_median_seconds=1350
restore_time_median_seconds=900
这个示例把部署频率保留为“统计窗口内成功生产部署次数”。如果仪表盘按天展示,可直接按自然日或滚动 24 小时窗口聚合;若按周展示,则使用同一事件表重新分组,不要在采集阶段写死“每天一次”这类派生结论。
处理容易污染指标的边界
取消任务通常应单独计数,不宜自动当作失败;否则人工取消的大批实验流水线会拉低成功率。重复部署需要用部署事件 ID 或“环境 + 发布版本 + 完成时间”去重,避免重试回调把一次部署算成多次。
变更前置时间应关联“实际进入这次生产部署的变更”。如果一次部署包含多个提交,可以为每个变更记录自己的接受时间,再聚合中位数或分位数。恢复时间也只在故障已经恢复时才能闭合;尚未恢复的事故应保留为开放事件,不要用当前时间强行算成最终 MTTR。
用指标定位流水线改进点
单个指标不能直接说明根因。构建时长上升但成功率稳定,优先查看依赖下载、缓存命中率和测试并发;成功率突然下降,应按失败阶段和错误码拆分;部署频率下降而变更前置时间上升,通常意味着变更在队列、审批或发布窗口中等待更久。
指标收集的验收标准不是“仪表盘有五个数字”,而是每个数字都能回溯到明确事件和时间点,并且相同原始事件在不同报表中会得到一致结果。只有口径稳定,趋势变化才值得用于工程决策。