
CI/CD / 系统课时
优化流水线执行时间
优化流水线执行时间
流水线优化的目标不是单纯把每个步骤都压到最短,而是缩短从提交到可靠结果的反馈时间。本课用“先测关键路径,再做缓存、并行、增量和任务拆分”的方法提速,并用一致性门禁避免快了以后产生漏测或脏缓存。
学习目标
- 用阶段耗时和关键路径判断真正的优化对象
- 正确选择缓存、并行、增量构建与任务拆分策略
- 用可重复构建和结果校验防止性能优化破坏一致性
先找关键路径而不是平均耗时
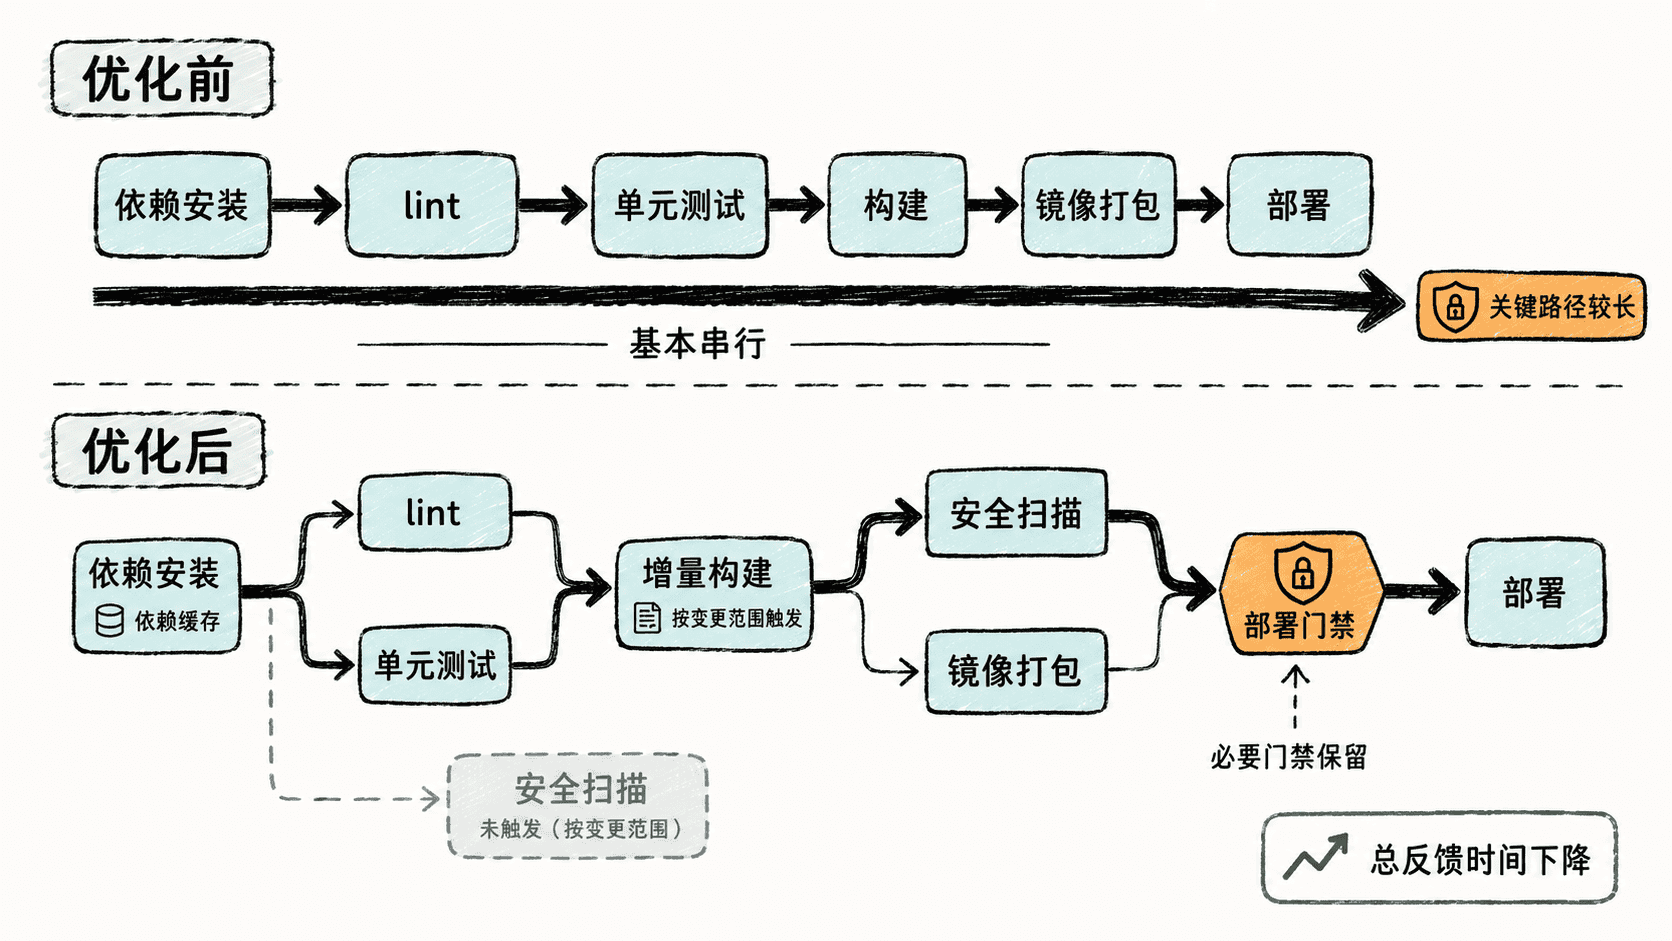
先记录每个 job 和关键 step 的持续时间,再找出决定总时长的最长依赖链。一个 8 分钟但能与其他任务并行的扫描,可能不在关键路径上;一个只有 3 分钟、却阻塞后续打包与部署的依赖安装,反而更值得优先优化。
优化前至少保存三组基线:冷启动、已有缓存、典型代码改动。只测一次很容易把网络抖动或共享执行器负载误认为优化收益。真正有效的改动应在多次运行中稳定缩短关键路径,而不是只让某个局部 step 更快。
优先使用低风险提速手段
缓存适合“输入相同则输出可复用”的依赖和中间产物。缓存键必须覆盖真正影响结果的输入,例如锁文件、编译器版本、目标平台。只按分支名缓存虽然命中率高,但依赖变化后可能复用旧内容,得到更快却不可重复的构建。
并行适合互不依赖的任务,例如 lint、单元测试、静态分析。任务拆分则是把一个大测试集按模块或分片分给多个执行器。并行度不是越高越好:当共享 CPU、磁盘、数据库或制品仓库成为瓶颈时,继续加并发反而会拉长尾部耗时。
增量构建适合单体仓库或模块边界清晰的项目。核心条件是能可靠判断“哪些输入影响哪些输出”。如果依赖图不完整,就宁可多构建,也不要因为错误跳过而把未验证变更发布出去。
在配置中落实缓存与并行
下面以 GitHub Actions 为例。lint 和 test 两个 job 并行启动,并各自执行依赖安装;Node 依赖缓存由 setup-node 根据锁文件自动管理。构建任务只有在两类质量检查都通过后才开始,保持原有门禁关系。
name: ci

on:
  push:
  pull_request:

jobs:
  lint:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: "22"
          cache: npm
      - run: npm ci
      - run: npm run lint

  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: "22"
          cache: npm
      - run: npm ci
      - run: npm test

  build:
    runs-on: ubuntu-latest
    needs: [lint, test]
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: "22"
          cache: npm
      - run: npm ci
      - run: npm run build
这是完整的工作流配置。生效后,仓库的 Actions 运行图中应看到 lint 与 test 同时启动,build 只有在两者成功后运行;第二次及后续相同依赖输入的运行通常会出现 npm 缓存命中。实际耗时取决于项目规模与执行器负载。
用数据验证优化是否真的有效
每次只引入一种主要优化,并比较优化前后的关键路径。可以从流水线平台导出 job 时长,也可以先在本地对高成本命令做稳定测量。下面命令连续执行三次依赖安装,用于观察冷缓存和热缓存差异;真实流水线仍应以平台侧时长为准。
for i in 1 2 3; do
  echo "run=$i"
  /usr/bin/time -f "elapsed=%e sec" npm ci >/dev/null
done
预期输出中的时间只是占位,第二、三次是否更快取决于 npm 本地缓存、网络和锁文件内容。
run=1
elapsed=<VALUE> sec
run=2
elapsed=<VALUE> sec
run=3
elapsed=<VALUE> sec保住一致性门禁
提速后至少验证三件事:同一提交重复构建得到等价制品,缓存失效条件覆盖依赖变化,跳过任务的规则不会漏掉受影响模块。对高风险项目,可以定期执行一次不使用缓存、不过滤变更范围的全量流水线,作为增量策略的校验基线。
最终目标是缩短可靠反馈时间,而不是追求最低的表面耗时。缓存解决重复工作,并行缩短独立任务等待,增量构建减少无关工作,任务拆分降低单个长任务的尾部时间;只有在依赖关系和门禁保持正确时,这些优化才值得上线。