
CI/CD / 系统课时
排查部署失败
排查部署失败
部署失败时,最容易浪费时间的是从日志里随机猜原因。本课建立一条固定排查顺序:先确认失败发生在哪个阶段,再依次检查凭据、网络、配置、资源状态与健康检查,最后用可复现证据验证修复是否生效。
学习目标
- 按固定顺序缩小部署失败范围,避免同时修改多个变量
- 使用流水线日志与集群状态区分认证、网络、配置和运行时问题
- 在修复后用部署状态与健康检查完成闭环验证
先确定失败发生在哪一层
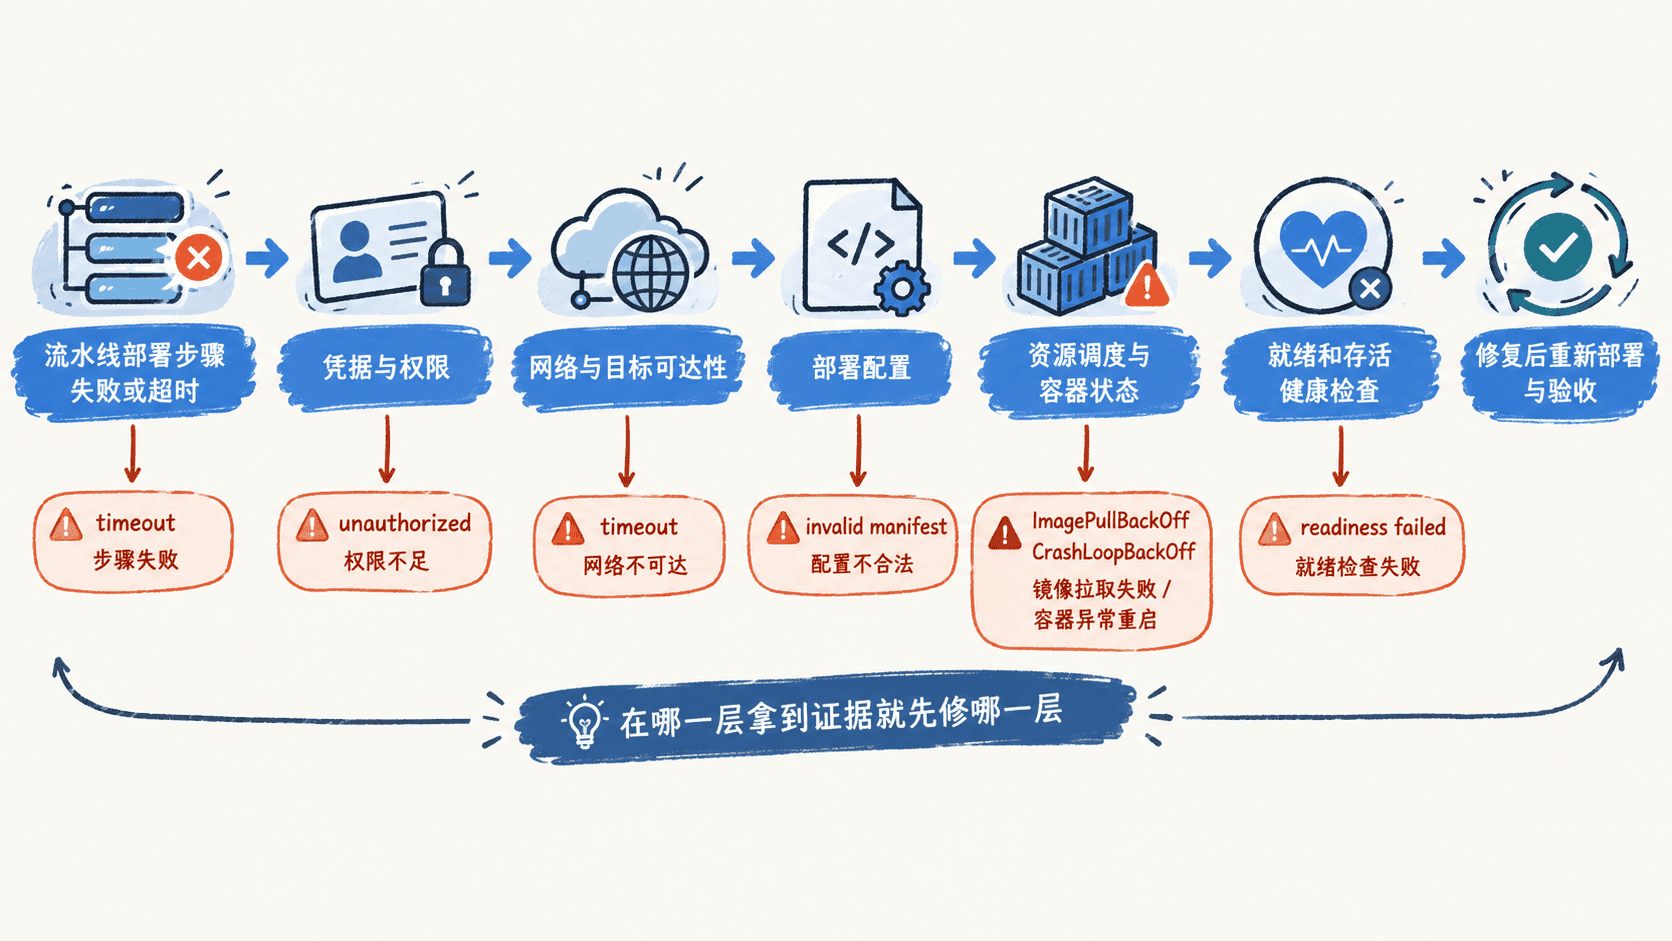
先看流水线中最后一个成功步骤和第一个失败步骤。若镜像推送已经成功,而部署命令失败,问题通常位于“部署凭据到目标环境”这段链路;若部署对象已经创建但随后超时,则应转向资源状态和健康检查,而不是继续检查仓库凭据。
排查时保持“先外后内”的顺序:凭据决定是否有权限访问目标,网络决定能否到达目标,配置决定提交的部署对象是否正确,资源状态说明调度与启动是否成功,健康检查最终判断应用是否可接收流量。
用一组命令固定现场
以下示例以 Kubernetes 目标环境为例。先替换命名空间和 Deployment 名称,再从“身份是否可用”一路检查到“应用是否就绪”。这组命令的价值不是一次性解决所有问题,而是把证据按层收集齐。
set -euo pipefail

NAMESPACE="<NAMESPACE>"
DEPLOYMENT="<DEPLOYMENT>"

echo "== auth =="
kubectl auth can-i get deployment -n "$NAMESPACE"

echo "== target reachability =="
kubectl cluster-info

echo "== deployment =="
kubectl get deployment "$DEPLOYMENT" -n "$NAMESPACE"
kubectl describe deployment "$DEPLOYMENT" -n "$NAMESPACE"

echo "== pods =="
kubectl get pods -n "$NAMESPACE" -o wide

echo "== rollout =="
kubectl rollout status deployment/"$DEPLOYMENT" -n "$NAMESPACE" --timeout=120s
预期输出会因集群、版本和资源名称而不同,但健康路径至少应看到权限允许、API Server 可访问、Deployment 可读取,并且 rollout 最终成功。
== auth ==
yes
== target reachability ==
Kubernetes control plane is running at https://<HOST>:<PORT>
== deployment ==
NAME             READY   UP-TO-DATE   AVAILABLE   AGE
<DEPLOYMENT>     <N>/<N> <N>          <N>         <TIME>
== pods ==
NAME             READY   STATUS    RESTARTS   AGE   IP
<ID>             1/1     Running   0          <TIME> <IP>
== rollout ==
deployment "<DEPLOYMENT>" successfully rolled out
若命令在某一层失败,不要继续用后续结果覆盖前面的信号。比如 kubectl auth can-i 返回 no,应先修复 ServiceAccount、Role 或 kubeconfig;cluster-info 超时则优先检查网络、代理、DNS 或目标地址,而不是修改 Deployment。
按错误类型定位根因
认证与权限问题通常表现为 Unauthorized、Forbidden、凭据过期或目标上下文错误。修复时先确认流水线实际使用的身份,再核对该身份在目标命名空间拥有最小必要权限。不要为了“先跑通”直接授予集群管理员权限,否则会掩盖权限模型错误。
网络问题常见于目标 API 地址不可达、DNS 解析失败、代理配置错误、防火墙阻断或私网环境缺少出口。判断标准是:同一执行器能否解析目标主机、建立 TCP/TLS 连接,并得到目标服务响应。只有“能连通”之后,认证错误才有分析价值。
配置问题通常在提交清单时就暴露,例如字段拼写错误、变量未渲染、镜像标签为空、引用了不存在的 Secret 或 ConfigMap。此时应对照本次流水线生成的最终配置,而不是只检查仓库里的模板,因为变量替换后的结果才是真正被部署的内容。
资源状态问题包括镜像拉取失败、调度失败、容器崩溃和资源不足。可以继续用 kubectl describe pod 和 kubectl logs 获取 Events 与应用日志。若 Pod 已运行但 rollout 仍超时,则重点检查 readiness;若不断重启,则先处理启动命令、依赖、配置或资源限制。
用健康检查完成验证
修复后的验收不能只看流水线变绿。至少确认三个结果:部署控制器达到期望副本数,新实例通过 readiness 并进入流量池,业务健康接口返回预期状态。如果系统还有烟雾测试或关键接口验证,也应在同一发布流程中执行。
当失败再次出现时,重复同一顺序并比较前后证据。只要能够回答“失败停在哪一层、哪条证据证明根因、修复后哪个指标恢复”,部署故障就从随机试错变成了可复现的工程问题。