
CI/CD / 系统课时
配置失败通知
配置失败通知
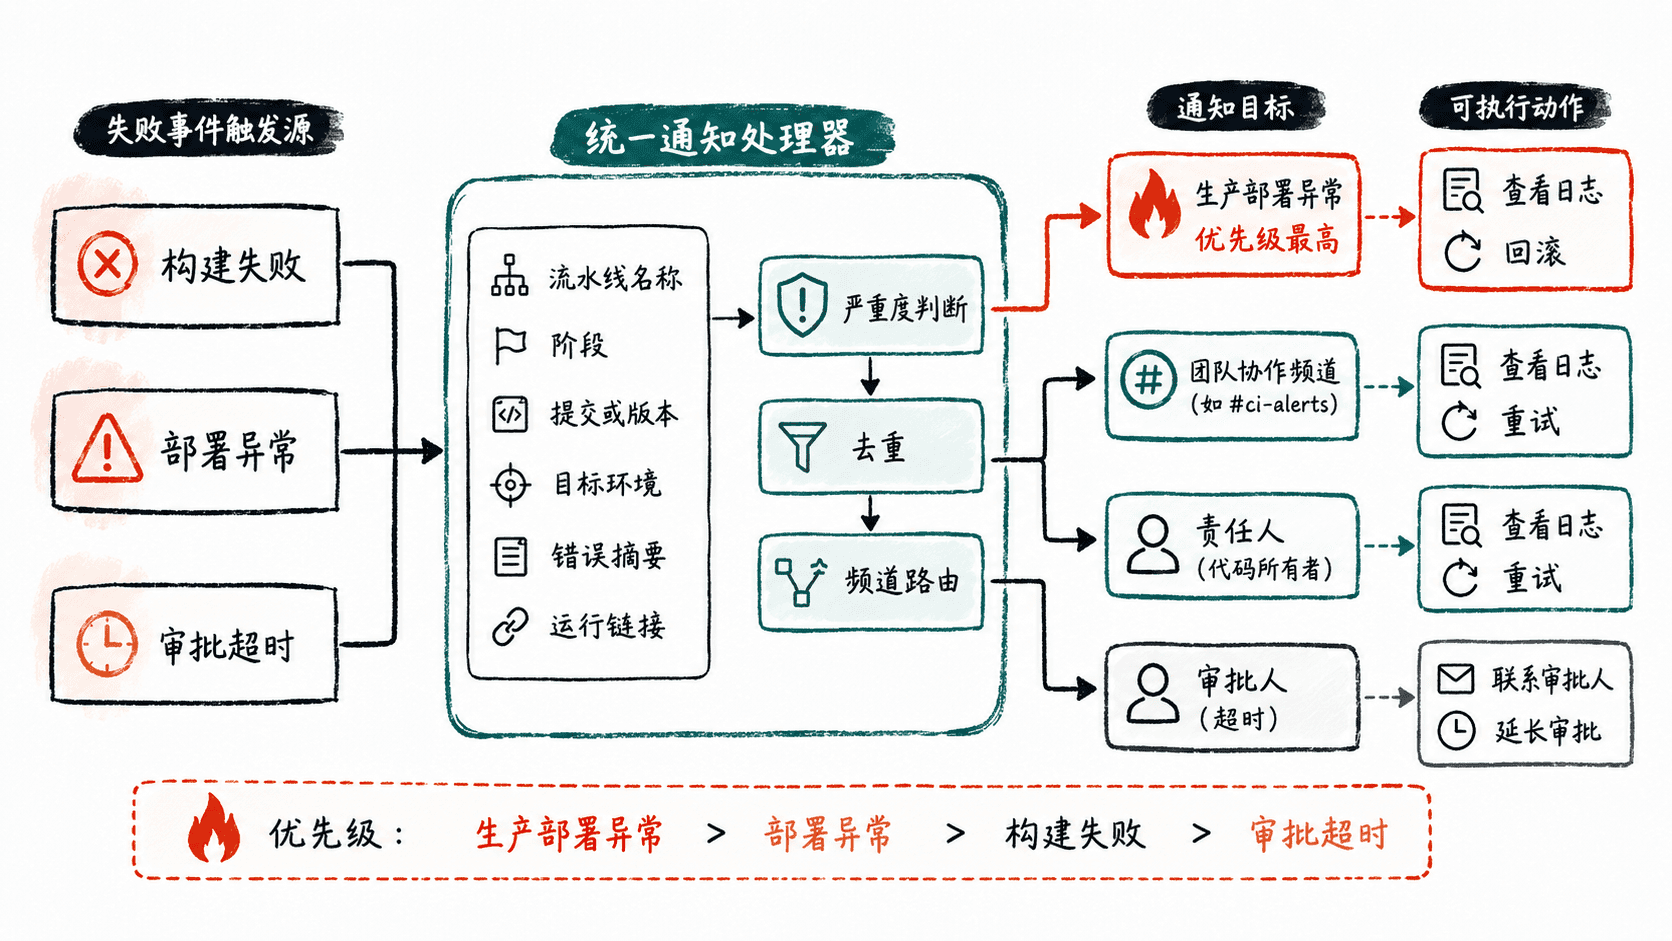
失败通知的目标不是“有人知道失败了”,而是让收到消息的人能立刻判断影响、找到现场并执行下一步。本节把构建失败、部署异常和审批超时统一成可路由、可去重、可操作的通知,并用团队协作渠道的 Webhook 完成落地。
学习目标
- 区分构建失败、部署异常和审批超时的触发时机与处理优先级
- 设计包含阶段、版本、环境、错误摘要和运行链接的通知载荷
- 用 Webhook 发送失败消息,并避免泄露凭据或制造通知风暴
先定义哪些事件必须通知
流水线至少要覆盖三类失败。构建失败通常阻断制品产生;部署异常可能已经影响目标环境;审批超时本身不是执行错误,但会让发布长期停滞。三者都应进入同一通知入口,再根据环境和严重度路由到不同频道。
| 事件 | 关键上下文 | 收到通知后的首要动作 |
|---|---|---|
| 构建失败 | 仓库、提交、失败步骤、测试或编译摘要 | 打开运行详情并定位首个失败步骤 |
| 部署异常 | 环境、版本、健康检查、回滚状态 | 判断是否停止扩容或立即回滚 |
| 审批超时 | 环境、待审批人、等待时长、截止时间 | 联系审批人或按发布策略取消 |
通知内容至少应回答五件事:哪里失败、影响哪个环境、正在发布哪个版本、最短错误摘要是什么、去哪里继续处理。只有“Job failed”而没有运行链接和上下文的消息,仍然需要接收者二次搜索。
用统一载荷发送 Webhook
下面以 Slack Incoming Webhook 为例。把 Webhook 地址保存为 CI/CD 平台的密钥变量,不要写进仓库;其余变量由当前流水线运行上下文注入。脚本只负责把统一字段组装成一条可点击、可判断的消息。
#!/usr/bin/env bash
set -euo pipefail

: "${SLACK_WEBHOOK_URL:?missing SLACK_WEBHOOK_URL}"
: "${EVENT_TYPE:?missing EVENT_TYPE}"
: "${PIPELINE_NAME:?missing PIPELINE_NAME}"
: "${STAGE_NAME:?missing STAGE_NAME}"
: "${TARGET_ENV:?missing TARGET_ENV}"
: "${VERSION:?missing VERSION}"
: "${ERROR_SUMMARY:?missing ERROR_SUMMARY}"
: "${RUN_URL:?missing RUN_URL}"

message="[$EVENT_TYPE] pipeline=$PIPELINE_NAME stage=$STAGE_NAME env=$TARGET_ENV version=$VERSION error=$ERROR_SUMMARY run=$RUN_URL"

payload="$(jq -n --arg text "$message" '{text: $text}')"

curl --fail --silent --show-error \
  -X POST \
  -H 'Content-type: application/json' \
  --data "$payload" \
  "$SLACK_WEBHOOK_URL"

printf '\n'
预期输出
okok 表示 Webhook 接受了消息;频道中的实际展示内容来自变量值。运行 ID、提交 SHA、时间戳等动态字段应由平台注入,文档示例中可用 <ID>、<VALUE> 表示实际运行时值。
把通知接到正确的失败点
构建任务应在最终失败状态确定后通知,避免每个测试子任务都发一条重复消息。部署任务应在健康检查失败、发布控制器报错或自动回滚触发时通知,并明确写出当前是否已经回滚。审批超时则应由门禁任务或定时检查器发出,而不是依赖人工发现等待状态。
同一次流水线运行建议使用“运行 ID + 阶段 + 事件类型”作为去重键。可恢复的短暂失败先由平台重试,重试耗尽后再通知;生产部署异常则不应等待长时间重试才告警。
让消息直接支持处理动作
可操作通知应把“事实”和“动作”分开:事实包含环境、版本、失败阶段和错误摘要;动作包含运行详情链接、重试入口、回滚状态或审批联系人。错误摘要控制在一两行,完整日志留在流水线系统中,避免把敏感变量、访问令牌或大段堆栈直接推送到公共频道。
最后再验证一次通知链路:主动让非生产流水线失败,确认消息只出现一次、字段齐全、链接可访问、密钥未出现在日志中。只有接收者能从一条消息直接进入处理现场,失败通知才真正完成了自动化闭环。