
CI/CD / 系统课时
处理数据库变更
处理数据库变更
数据库结构和应用版本的生命周期往往不同:应用可以秒级回滚,表结构和数据却未必能安全逆转。本篇用“扩展、迁移、收缩”方法把数据库变更拆成可兼容阶段,使新旧应用在发布窗口内都能工作,并保留可靠的应用回滚路径。
学习目标
- 能用扩展、迁移、收缩拆分数据库结构变更
- 能保证新旧应用在滚动发布期间同时兼容数据库
- 能为回填、约束收紧和删除旧结构设置发布门禁
先把变更拆成兼容阶段
风险最高的做法,是在一次发布中同时重命名字段、修改应用代码并删除旧字段。滚动发布期间,新旧实例会短暂共存;如果数据库只满足其中一个版本,另一批实例就会立刻失败。
更稳妥的方式是把变更拆成三个阶段:先扩展数据库,让旧应用仍可运行;再发布新应用并迁移数据和读写路径;最后等旧版本完全退出且回滚窗口结束后,再收缩旧结构。
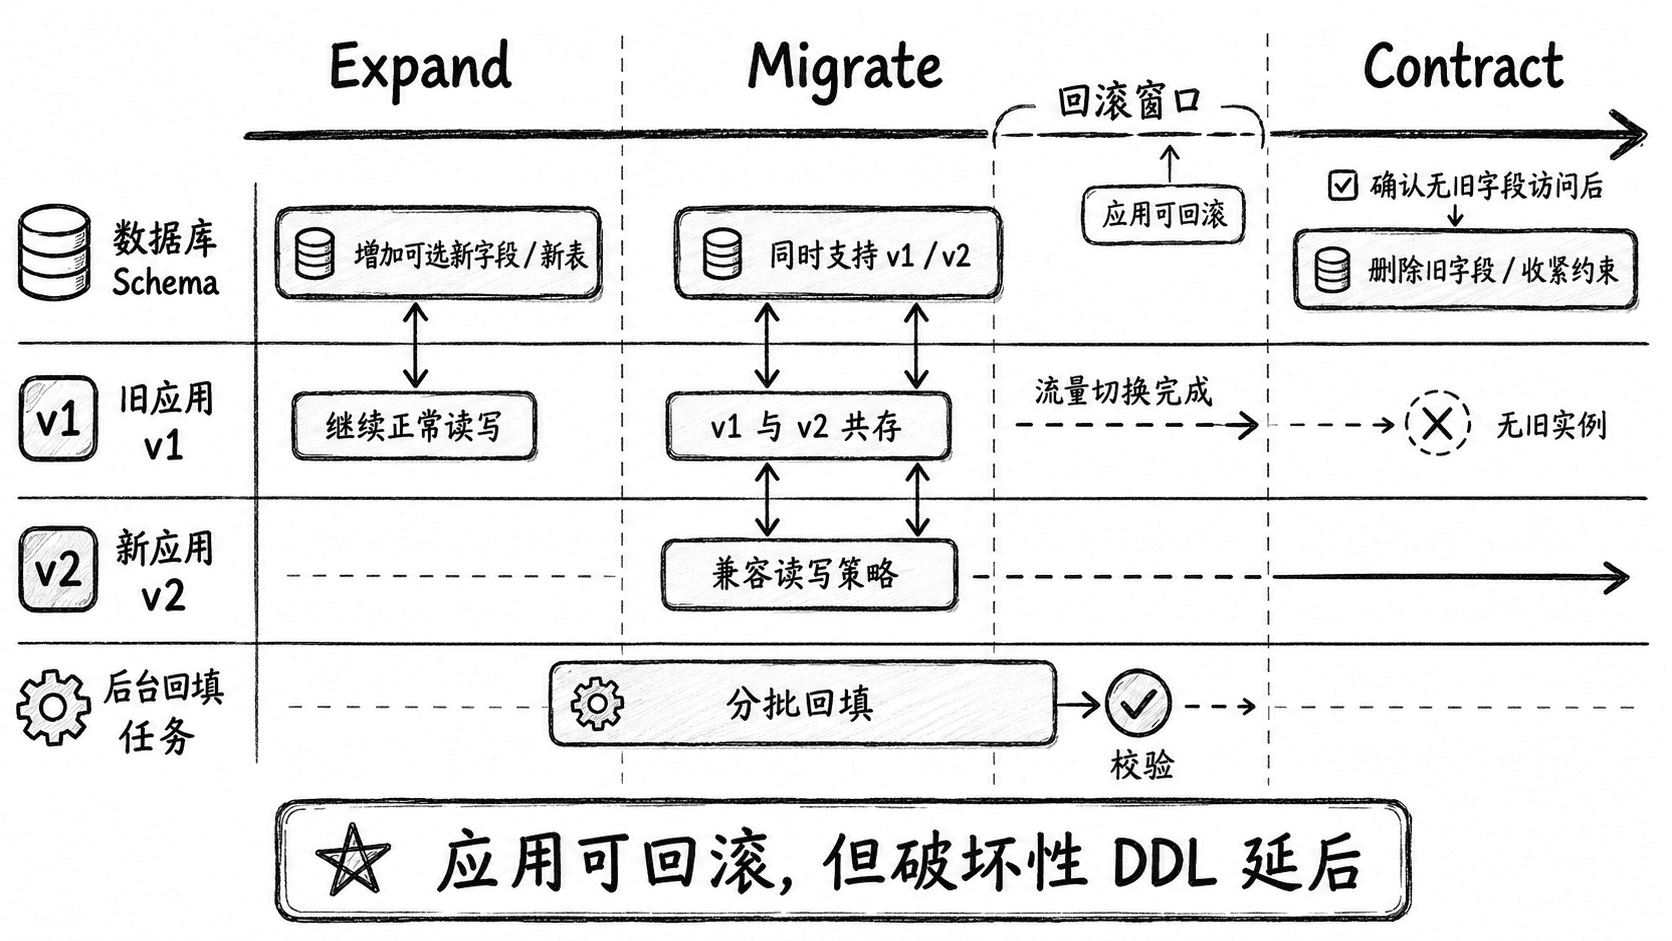
先扩展 Schema,再发布新代码
以 PostgreSQL 为例,假设应用准备把 full_name 迁移到 display_name。第一步不是删除或重命名旧列,而是增加一个允许为空的新列。旧版本看不到这个列,也不会因为写入缺失而失败。下面是片段示例,依赖现有 customer 表已经包含 id 和 full_name 字段。
-- 扩展阶段只增加新列,不移除旧列,确保旧应用仍可写入。
ALTER TABLE customer
  ADD COLUMN display_name VARCHAR(200);
预期结果
ALTER TABLE这一阶段完成后,应先验证旧版本仍能正常写入和读取。只有数据库扩展与旧应用兼容,才具备继续滚动发布的条件。
迁移读写路径和历史数据
新版本发布后,不要立刻假定所有历史行都已经具备新字段。常见做法是让新应用优先读取 display_name,为空时回退到 full_name;写入阶段则按业务需要采用双写或先写新列并保留旧列兼容。
历史数据回填要可暂停、可重试,并尽量分批执行,避免一个超大事务长期持锁。下面继续基于同一张表做片段示例,用固定主键区间表示一个回填批次;生产中应由任务系统逐批推进并记录进度。
-- 每次只处理一个有限主键区间,降低长事务和锁持有时间。
UPDATE customer
SET display_name = full_name
WHERE id >= 1000
  AND id < 2000
  AND display_name IS NULL;

-- 只验证本批次,确认没有遗漏后再推进下一个区间。
SELECT COUNT(*) AS remaining
FROM customer
WHERE id >= 1000
  AND id < 2000
  AND display_name IS NULL;
预期结果
UPDATE <VALUE>
 remaining
-----------
         0
<VALUE> 取决于实际需要回填的行数。只有验证剩余未迁移数据为 0,并确认新版本已经稳定读取新字段,才能进入下一阶段。
把破坏性变更放到最后
删除旧列、重命名字段、收紧 NOT NULL、删除旧索引都属于收缩阶段。执行前至少要满足:旧应用实例已经清零、回滚窗口已结束、代码仓库中不再引用旧结构、后台任务不再访问旧字段,并且数据校验已通过。
数据库变更不应和应用版本做“机械对称回滚”。如果新版本写入了新格式数据,再直接撤销数据库结构,可能造成数据丢失。更安全的策略通常是:应用先回滚到仍兼容扩展后 Schema 的旧版本,数据库保持扩展状态,待故障处置完成后再决定如何前向修复。
给 CI/CD 增加数据库门禁
流水线中的数据库阶段至少要检查以下条件:
- 扩展迁移已经成功,并且旧应用仍可运行。
- 新应用在旧数据未完全回填时仍能正确读取。
- 回填任务具备批次、重试和进度校验,不依赖一次性长事务。
- 收缩操作与首次发布分离,不在同一个回滚窗口内删除旧结构。
- 执行破坏性 DDL 前,已经确认没有旧版本实例和旧字段访问。
把数据库迁移当成独立的发布状态机,而不是应用发布脚本里的一条附属命令,就能把“应用可以回滚、数据结构不可随意逆转”的现实纳入自动化流程。