
CI/CD / 系统课时
配置探针与资源限制
配置探针与资源限制
本课把 Kubernetes 部署从“能启动”提升到“能被可靠调度和自动恢复”。你会为容器补齐启动、存活、就绪三类探针,并设置 CPU 与内存的 requests、limits,最后通过集群状态确认探针和资源参数已经被 Pod 接受。
学习目标
- 区分
startupProbe、livenessProbe与readinessProbe的职责 - 能为容器配置可执行的 HTTP 探针及合理检测节奏
- 能用资源请求与限制表达调度基线和容器上限
先把三类探针分工清楚
三类探针解决的是不同问题。startupProbe 判断慢启动应用是否已经完成初始化;它成功之前,存活和就绪检查不会接管。livenessProbe 判断进程是否进入需要重启的失效状态;连续失败达到阈值后,kubelet 会重启容器。readinessProbe 只决定 Pod 是否继续接收 Service 流量,失败不会直接重启容器。
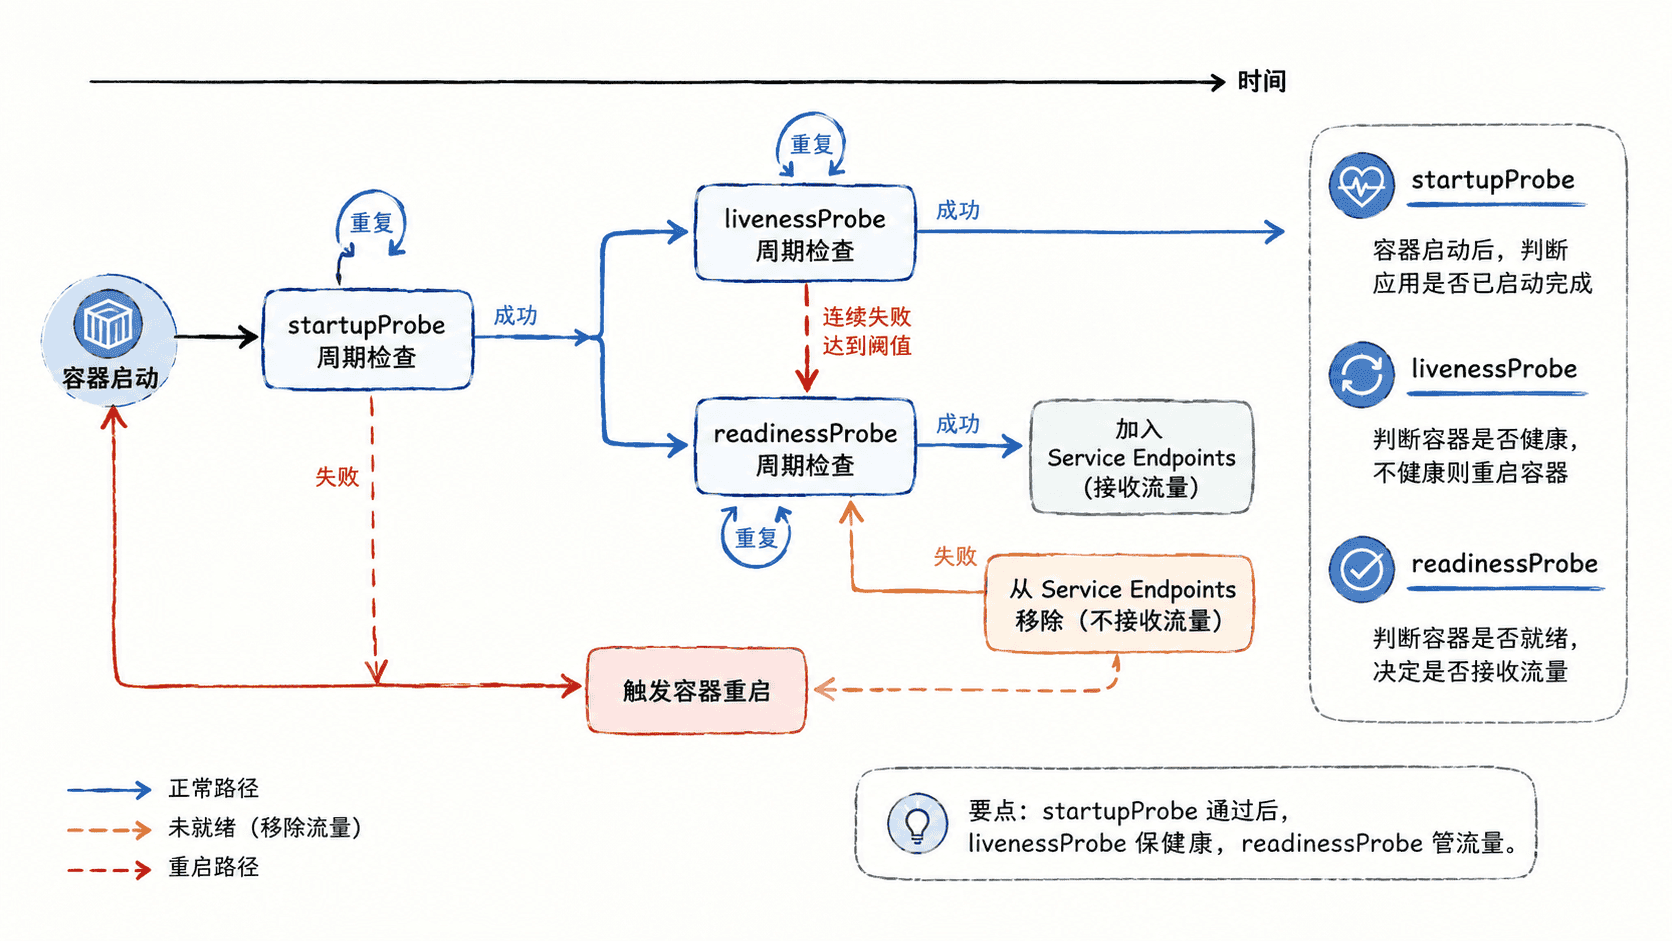
资源参数同样分工明确:requests 是调度器计算 Pod 应放到哪台节点上的资源基线;limits 是运行时允许容器使用的上限。CPU 超出限制通常表现为节流,内存超过限制则可能触发容器 OOM 终止,因此内存上限不能只按“平时平均值”填写。
在 Deployment 中加入探针与资源参数
假设应用在 8080 端口提供 /health/startup、/health/live 和 /health/ready 三个 HTTP 端点,可以把容器配置写成下面这样。下面是片段示例,可直接替换 Deployment 中原来的 containers 配置;它依赖应用已实现对应的三个健康检查端点。
containers:
  - name: demo-app
    image: registry.example.com/demo-app:1.0.0
    ports:
      - name: http
        containerPort: 8080
    startupProbe:
      httpGet:
        path: /health/startup
        port: http
      periodSeconds: 5
      failureThreshold: 24
    livenessProbe:
      httpGet:
        path: /health/live
        port: http
      periodSeconds: 10
      timeoutSeconds: 2
      failureThreshold: 3
    readinessProbe:
      httpGet:
        path: /health/ready
        port: http
      periodSeconds: 5
      timeoutSeconds: 2
      failureThreshold: 2
    resources:
      requests:
        cpu: 200m
        memory: 256Mi
      limits:
        cpu: "1"
        memory: 512Mi
startupProbe 最多允许约 120 秒启动窗口,也就是 5 × 24 秒;只有启动探针成功后,另外两类探针才开始发挥作用。readinessProbe 应检查“当前能否接流量”,不要把偶发的外部依赖抖动直接设计成进程重启条件。
资源值必须来自压测或生产观测,而不是照抄示例。上面的 200m 表示 0.2 个 CPU 核的请求量,1 表示 1 个 CPU 核的限制;256Mi 与 512Mi 分别表示内存请求和上限。
应用配置并验证生效
把修改后的 Deployment 保存到 <PATH>/k8s.yaml 后重新应用,并查看 Pod 描述信息:
kubectl apply -f <PATH>/k8s.yaml
kubectl get pods -l app=demo
kubectl describe pod $(kubectl get pod -l app=demo -o jsonpath='{.items[0].metadata.name}')
预期输出
deployment.apps/demo-app configured
service/demo-app unchanged
NAME                        READY   STATUS    RESTARTS   AGE
demo-app-<ID>               1/1     Running   0          <TIME>
demo-app-<ID>               1/1     Running   0          <TIME>

Containers:
  demo-app:
    Limits:
      cpu:     1
      memory:  512Mi
    Requests:
      cpu:      200m
      memory:   256Mi
    Startup:    http-get http://:http/health/startup ...
    Liveness:   http-get http://:http/health/live ...
    Readiness:  http-get http://:http/health/ready ...
kubectl describe 的完整输出会随 Kubernetes 版本和集群环境变化,这里只展示需要核对的字段。确认三类探针路径、端口以及 Requests/Limits 与清单一致即可。
根据失败现象调整参数
如果 Pod 长时间停在 0/1 Running,先查看就绪探针是否失败;如果容器反复重启,检查事件中是否出现 Liveness probe failed;如果慢启动应用在初始化完成前被重启,应优先扩大启动探针允许的失败窗口,而不是直接放宽存活探针。
资源问题则要结合指标判断。持续 CPU 节流说明 CPU limit 可能过紧,容器出现 OOMKilled 则说明内存峰值超过限制,或应用本身存在异常增长。合理配置的目标不是“限制得越小越好”,而是让调度基线、正常峰值和故障上限彼此有清晰边界。