
可观测性与稳定性 / 系统课时
分片为什么一直无法分配
分片为什么一直无法分配
当 Elasticsearch 集群出现 yellow 或 red,真正需要回答的不是“怎么强制分配”,而是“哪个分片为什么不能落到哪些节点”。本节用 _cluster/allocation/explain 建立排查顺序,重点识别磁盘水位、分配过滤和节点条件造成的拒绝。
学习目标
- 使用 allocation explain 定位未分配分片的具体拒绝原因
- 区分磁盘、过滤规则和节点条件导致的分配失败
- 修复限制条件后验证分片是否重新进入分配流程
先确认哪些分片没有分配
先查看集群健康和分片状态,不要一看到 yellow 就修改配置。yellow 通常表示主分片可用但至少一个副本未分配;red 则意味着至少存在不可用的主分片,处理优先级更高。
curl -s "http://localhost:9200/_cluster/health?pretty"
curl -s "http://localhost:9200/_cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason"
预期输出中应能找到 UNASSIGNED 分片;索引名、分片编号和节点名称取决于实际集群。
index     shard prirep state      node unassigned.reason
app-logs  0     p      STARTED    es01
app-logs  0     r      UNASSIGNED      <REASON>
这里的 unassigned.reason 说明分片为何进入未分配状态,但它不一定解释为什么现在仍然不能分配。后者需要 allocation explain 的各个 decider 给出判断。
让 Elasticsearch 解释拒绝原因
对一个未分配分片调用 explain 接口,可以看到 Elasticsearch 是否能够分配,以及候选节点分别被哪些分配决策器拒绝。下面使用 GET 请求体指定目标分片。
curl -s -X GET "http://localhost:9200/_cluster/allocation/explain?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "index": "app-logs",
    "shard": 0,
    "primary": false
  }'
预期结果不是固定文本。重点查看顶层 can_allocate,以及 node_allocation_decisions 中各节点的 deciders。出现 NO 时,对应 decider 和 explanation 就是下一步调查入口。
"can_allocate" : "no",
...
"deciders" : [
  {
    "decider" : "<DECIDER>",
    "decision" : "NO",
    "explanation" : "<REASON>"
  }
]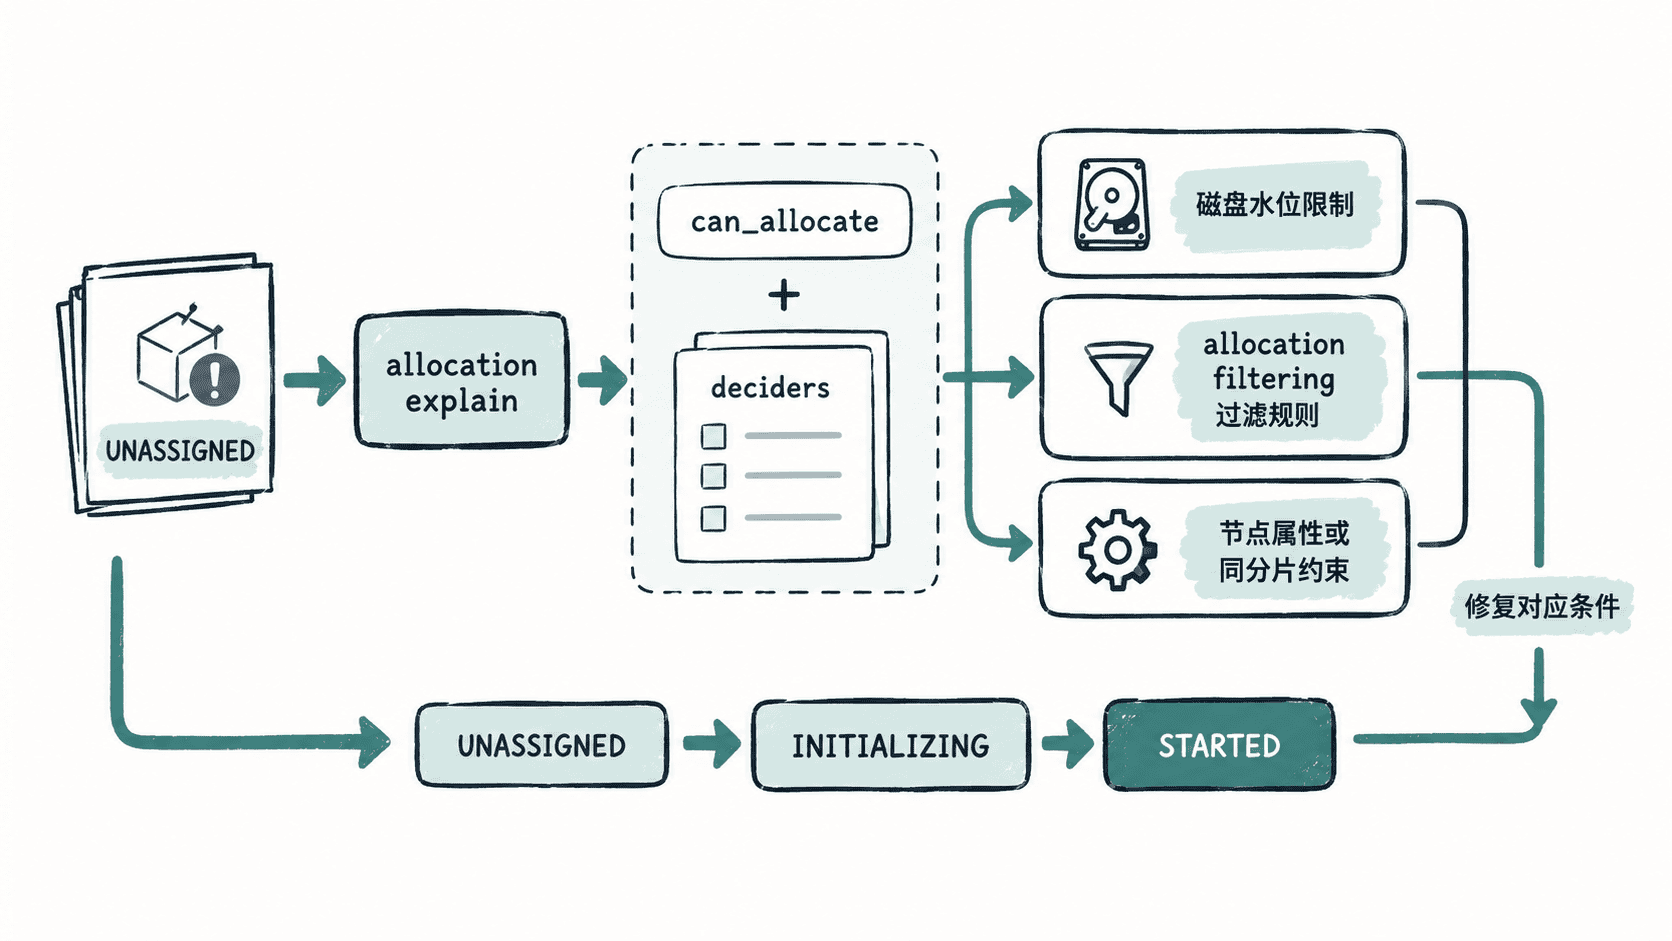
优先检查三类常见限制
磁盘不足时,disk_threshold 决策器可能拒绝继续向节点分配分片。先看节点磁盘使用情况,再结合 explain 返回的解释判断是否触发水位限制,而不是仅凭某个磁盘百分比猜测。
curl -s "http://localhost:9200/_cat/allocation?v&h=node,disk.total,disk.used,disk.avail,disk.percent,shards"预期输出会列出各数据节点磁盘情况,实际容量和百分比因环境而异。
node disk.total disk.used disk.avail disk.percent shards
es01 <TOTAL>    <USED>    <AVAIL>    <PERCENT>    <COUNT>
如果 explain 指向过滤规则,再检查集群级分配设置。include、require 和 exclude 都可能缩小候选节点集合;索引自身也可以配置分配过滤,因此不能只检查集群设置。
curl -s "http://localhost:9200/_cluster/settings?include_defaults=true&flat_settings=true"
curl -s "http://localhost:9200/app-logs/_settings?flat_settings=true"
预期结果应检查 cluster.routing.allocation.* 和 index.routing.allocation.* 相关设置。若存在与当前节点不匹配的 require 或覆盖所有候选节点的 exclude,explain 通常会明确指出对应过滤条件。
节点条件同样可能让副本无处可去。例如只有一个数据节点时,主分片已经位于该节点,副本不能再放到同一节点上。此时增加副本数不会增加可用性,必须增加满足条件的数据节点,或者根据真实可用性目标调整副本配置。
修复后验证而不是反复重试
修复动作应针对 explain 已确认的根因:释放磁盘或扩容、纠正错误的过滤规则、恢复符合属性要求的节点,或者调整不合理的副本设计。不要把关闭磁盘阈值、强制分配 stale primary 等高风险操作当成通用修复方法。
修复后再次观察分片和健康状态:正常恢复通常会经历 UNASSIGNED、INITIALIZING、STARTED,大型分片可能需要较长时间完成复制。
curl -s "http://localhost:9200/_cat/shards?v&h=index,shard,prirep,state,node"
curl -s "http://localhost:9200/_cluster/health?pretty"
预期结果是目标分片最终进入 STARTED;如果仍为 UNASSIGNED,再次执行 allocation explain,因为解除第一项限制后可能暴露第二项限制。
稳定的排查方式是把 allocation explain 当成决策依据:先确定具体未分配分片,再读取拒绝它的 decider,最后只修改被证据指向的约束,并用分片状态验证恢复结果。