
可观测性与稳定性 / 系统课时
集群 red 时如何抢救数据
集群 red 时如何抢救数据
Elasticsearch 集群进入 red,关键不是立刻重建节点,而是先确认哪些主分片不可用、是否仍有可恢复数据,以及修复后能否重新分配。沿着“分片→节点→恢复条件”的顺序处理,可以避免误操作进一步扩大数据损失。
学习目标
- 能区分 red 状态对应的主分片缺失与普通副本问题
- 能用分片、节点和分配诊断命令确定恢复路径
- 能判断何时应修复节点,何时需要从快照等备份恢复
先确认 red 到底意味着什么
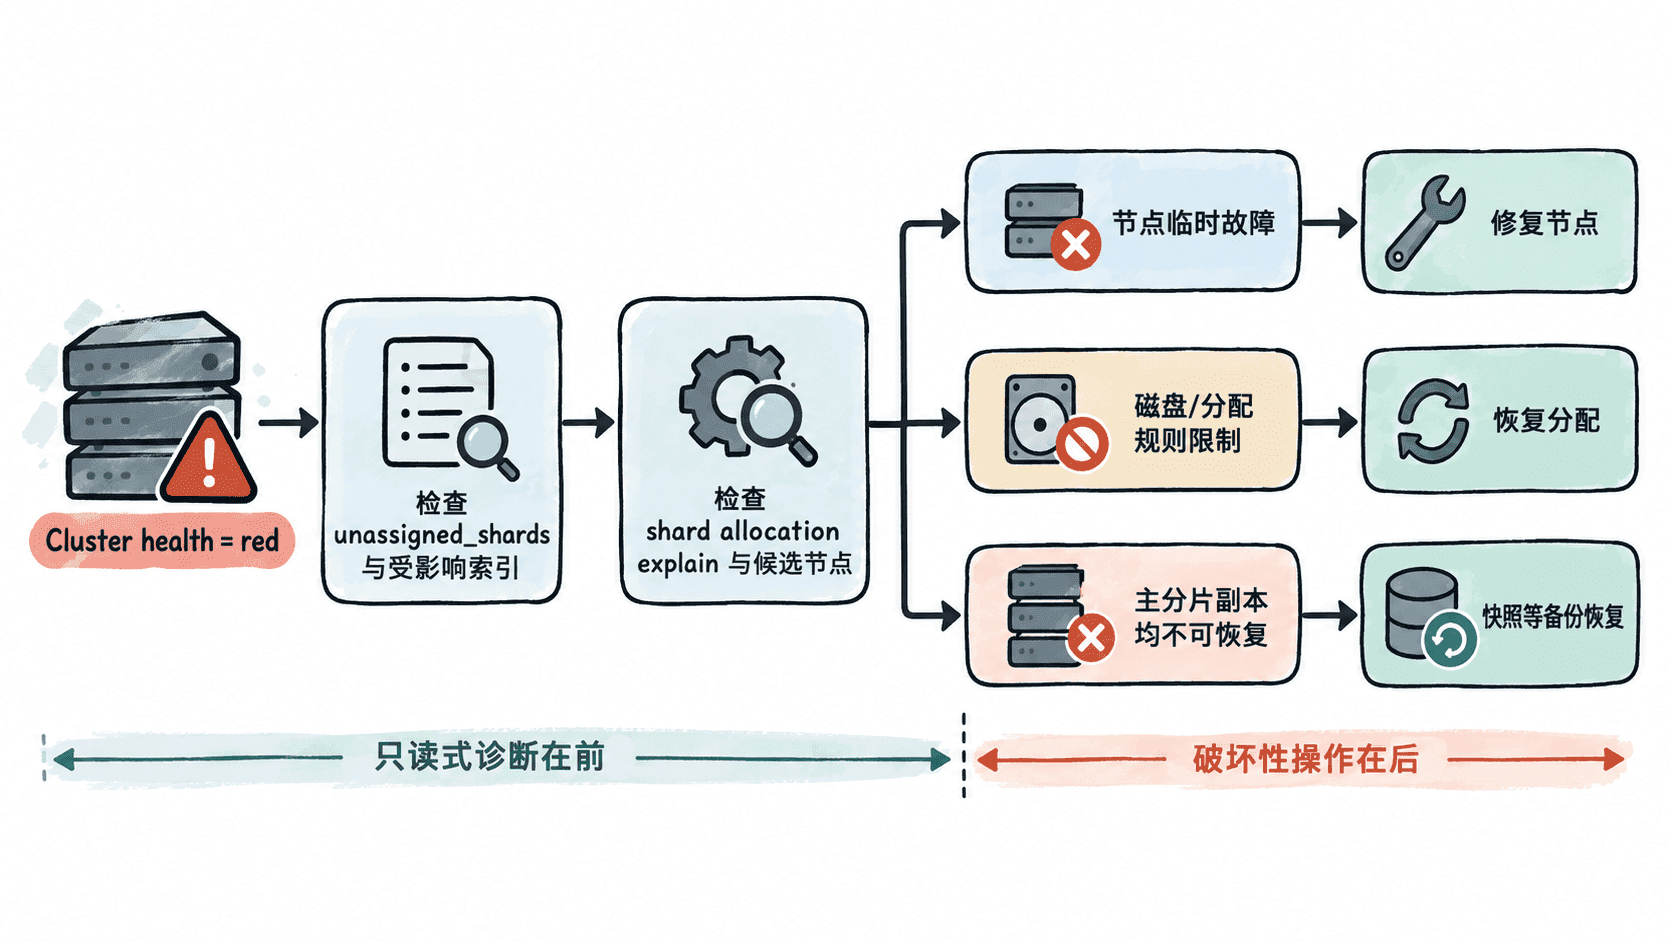
red 表示至少存在未分配的主分片,因此部分索引数据当前不可用。先看集群健康和未分配分片数量,不要直接执行删除索引、强制重新分配等破坏性操作。
按分片定位受影响的数据
先执行以下命令,确认集群中到底有多少未分配主分片,并结合索引名称判断影响范围。
curl -sS "http://<HOST>:9200/_cluster/health?level=indices" | jq '{status,active_primary_shards,unassigned_shards}'
curl -sS "http://<HOST>:9200/_cat/shards?v&h=index,shard,prirep,state,node,unassigned.reason"
预期结果
status: red
active_primary_shards: 5
unassigned_shards: 1

index        shard prirep state      node
orders       0     p      STARTED    es-data-1
orders       1     p      UNASSIGNED -
orders       1     r      UNASSIGNED -
示例中的 orders 主分片 1 未分配,说明该分片对应的数据不可正常服务;同一分片的副本也未分配时,不能把问题简单理解为“副本少了一份”。实际字段和数量会随集群变化。
判断是节点故障还是分配条件阻断
继续对指定索引分片执行 allocation explain,可以看到 Elasticsearch 为什么拒绝把分片放到候选节点。重点关注 can_allocate 和各节点的 deciders,它们比反复重启容器更适合用于定位根因。
curl -sS -X POST "http://<HOST>:9200/_cluster/allocation/explain?include_yes_decisions=true" \
  -H 'Content-Type: application/json' \
  -d '{
    "index": "orders",
    "shard": 1,
    "primary": true
  }' | jq '{index,shard,primary,can_allocate,allocate_explanation,deciders:[.node_allocation_decisions[] | {node_name,node_decision,deciders:[.deciders[] | {decider,decision,explanation}]}]}'
预期结果
{
  "index": "orders",
  "shard": 1,
  "primary": true,
  "can_allocate": "no",
  "allocate_explanation": "cannot allocate because node is unavailable",
  "deciders": [
    {
      "node_name": "es-data-2",
      "node_decision": "no"
    }
  ]
}
若原因指向节点不可用,先恢复该节点及其磁盘、网络或进程;若原因是磁盘水位、allocation filtering 或同分片约束,则应修复对应条件。不要为了让分片“变绿”而绕过保护规则。
评估可恢复性再决定动作
最安全的恢复顺序通常是“恢复原节点或分配条件→重新观察分片→确认主分片恢复→检查集群健康”。节点回来后,可重新查看目标分片是否从 UNASSIGNED 进入恢复状态并最终变为 STARTED。
当主分片所在节点已经丢失,而且该主分片没有可用副本时,普通重新分配不能凭空生成原数据。这时应停止具有破坏性的尝试,确认是否存在可用快照或其他可靠备份,再走恢复流程。
恢复后怎样验收
修复动作完成后,同时检查集群健康、目标分片状态和业务索引是否可读。只有看到目标主分片正常分配,并且实际查询能够读到关键数据,才能认为抢救完成。
curl -sS "http://<HOST>:9200/_cluster/health?wait_for_status=yellow&timeout=30s" | jq '{status,active_primary_shards,unassigned_shards}'
curl -sS "http://<HOST>:9200/orders/_search?size=1" | jq '{timed_out,hits:{total:.hits.total,first:.hits.hits[0]._id}}'
预期结果
{
  "status": "yellow",
  "active_primary_shards": 6,
  "unassigned_shards": 0
}
{
  "timed_out": false,
  "hits": {
    "total": {
      "value": 1000,
      "relation": "gte"
    },
    "first": "<ID>"
  }
}
这里的 yellow 只表示可能仍有副本未分配;对 red 抢救而言,关键验收项是受影响主分片已经恢复并且业务查询能够正常读取。若主分片确实无法从现有节点或副本恢复,就应把“备份可用性”和“可接受的数据回退范围”作为下一步决策依据。