
可观测性与稳定性 / 系统课时
动态映射为什么会拖垮集群
动态映射为什么会拖垮集群
动态映射能让新日志字段自动进入 Elasticsearch,但它也会把失控的字段名持续加入 mapping。尤其当应用把用户 ID、请求参数或动态键直接当字段名时,字段数量会快速膨胀。解决重点不是彻底拒绝动态数据,而是控制哪些字段有资格成为可索引字段。
学习目标
- 理解动态映射与字段爆炸之间的关系
- 能识别日志结构中产生大量字段的危险模式
- 能用显式映射和动态策略限制字段增长
动态映射便利在哪里
默认情况下,写入包含未知字段的文档时,Elasticsearch 可以根据值推断字段类型并更新 mapping。对于结构稳定、字段数量有限的日志,这降低了首次接入成本。
真正危险的是字段名本身不断变化。例如应用错误地生成下面这种结构:
{
  "service": "gateway",
  "labels": {
    "user_10001": "active",
    "user_10002": "active",
    "user_10003": "inactive"
  }
}
这里的 user_10001、user_10002 并不是三个固定业务属性,而是数据值被提升成了字段名。如果新的用户不断出现,mapping 中的字段也会持续增加。
字段爆炸为什么影响集群
Mapping 属于索引元数据。大量字段不仅增加 mapping 本身的规模,还会提高节点处理和传播相关元数据的成本,并让查询、字段能力检查以及内存使用变得更重。字段持续增长时,问题不再只是“单条日志稍大”,而是索引结构不断扩张。
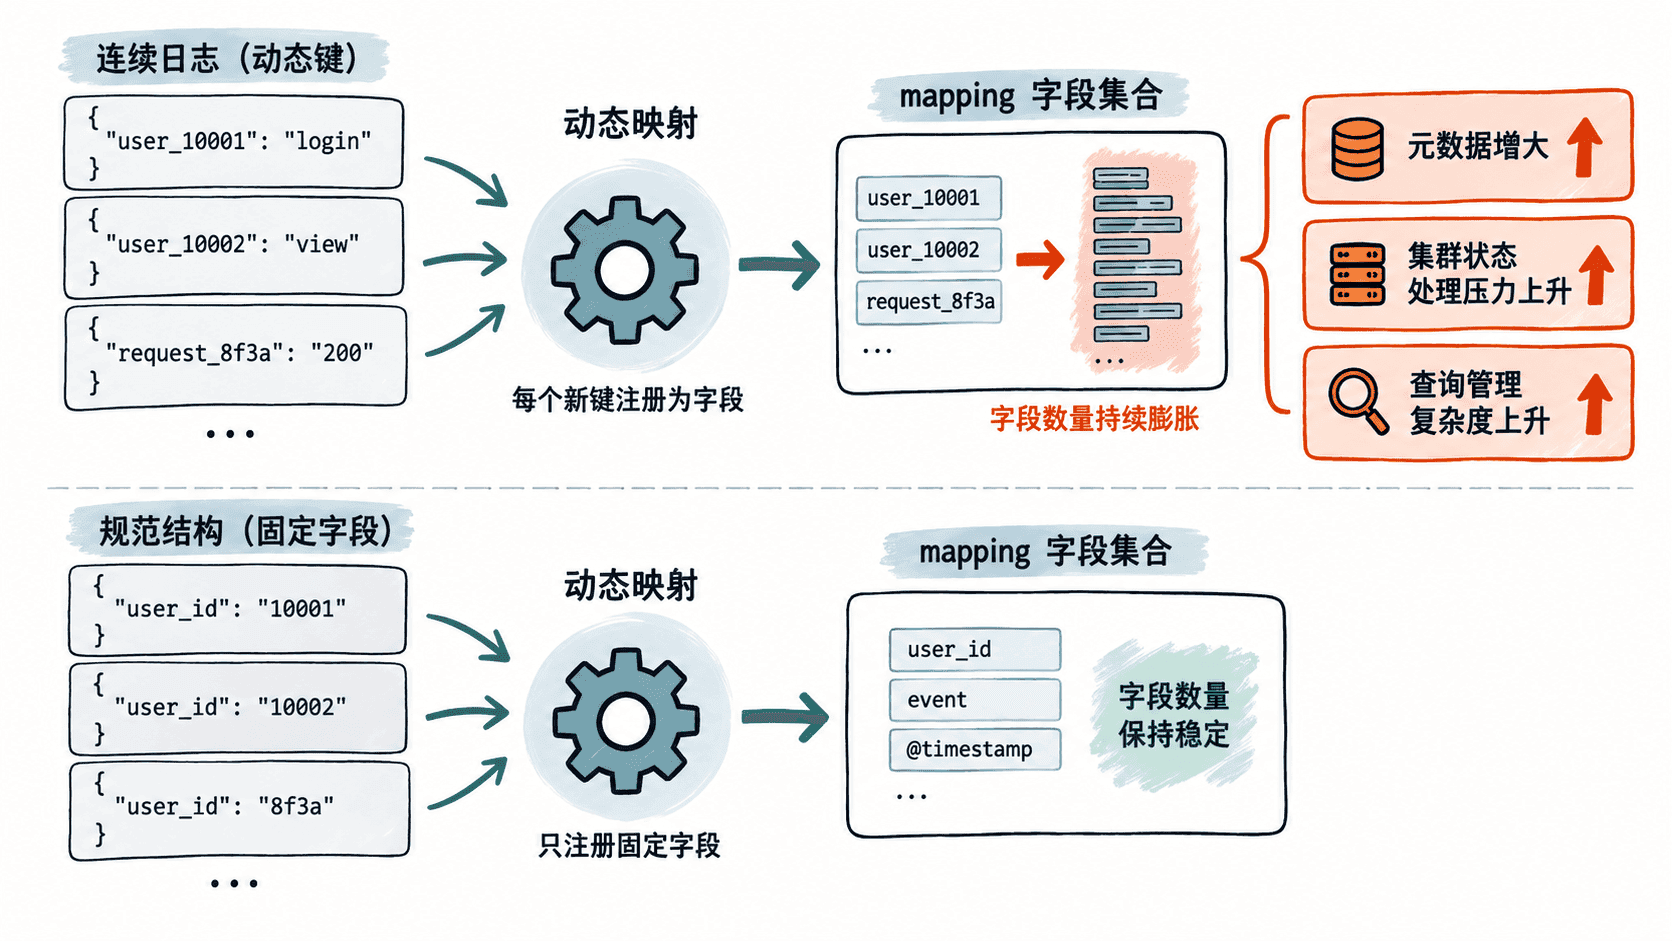
更合理的数据结构是固定字段名,把变化内容保存为字段值。例如用户标识应写成 "user_id": "10001",而不是生成 user_10001 这样的新字段。
用映射策略建立边界
对字段集合明确的日志,可以把动态映射设置为 strict。未声明字段写入时请求会失败,从而尽早暴露日志契约变化:
curl -X PUT "http://localhost:9200/strict-logs" -H "Content-Type: application/json" -d '{
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "service": { "type": "keyword" },
      "level": { "type": "keyword" },
      "message": { "type": "text" }
    }
  }
}'
预期输出:
{"acknowledged":true,"shards_acknowledged":true,"index":"strict-logs"}此后只有已经声明的字段可以正常进入该对象层级。若写入额外的未知字段,Elasticsearch 会拒绝该文档,因此采用 strict 前必须确认生产日志字段已经受到版本和契约管理。
另一种策略是将某个对象设置为 dynamic: false。未知字段仍可保留在 _source 中,但不会自动加入 mapping,也不会成为可直接搜索的映射字段。这适合需要保存原始附加信息、却不需要对每个动态键建立索引的场景。
验证字段是否仍在增长
治理后应直接检查 mapping,而不是只观察采集服务是否报错:
curl -s "http://localhost:9200/strict-logs/_mapping"预期输出中的核心字段应保持在预先声明的集合内,例如:
{"strict-logs":{"mappings":{"dynamic":"strict","properties":{"level":{"type":"keyword"},"message":{"type":"text"},"service":{"type":"keyword"}}}}}实际 JSON 字段顺序可能不同。生产环境还应持续观察索引字段数量以及 mapping 变化来源;如果字段数量仍不断增加,应继续追踪上游日志结构和索引模板,而不是单纯提高字段上限来掩盖问题。
动态映射适合接纳有限且可预测的新字段,不适合承载无限变化的键空间。线上日志平台应让常用检索字段保持稳定,对不可控附加数据明确选择拒绝、忽略映射或在采集阶段规范化,才能把索引结构和长期保留成本控制在可预期范围内。