
可观测性与稳定性 / 系统课时
不同服务日志怎么分流
不同服务日志怎么分流
多个服务共用 Logstash 时,如果所有事件都写入同一个目标,字段冲突、权限管理和检索范围都会迅速变复杂。本节使用来源字段、标签与条件判断建立明确的路由规则,让订单、支付等日志进入各自的数据流或索引,同时保留可验证的兜底路径。
学习目标
- 使用稳定字段作为日志分流依据
- 掌握 Logstash 条件判断与动态输出目标的组合方式
- 为未知来源设计兜底路由,避免日志被静默丢弃
分流依据要在进入 Logstash 前确定
最可靠的路由依据通常是明确的服务标识,例如 service.name、app 或采集端添加的标签,而不是从自由文本 message 中猜服务名称。服务标识应保持低基数、命名稳定,并由采集配置或结构化日志产生。
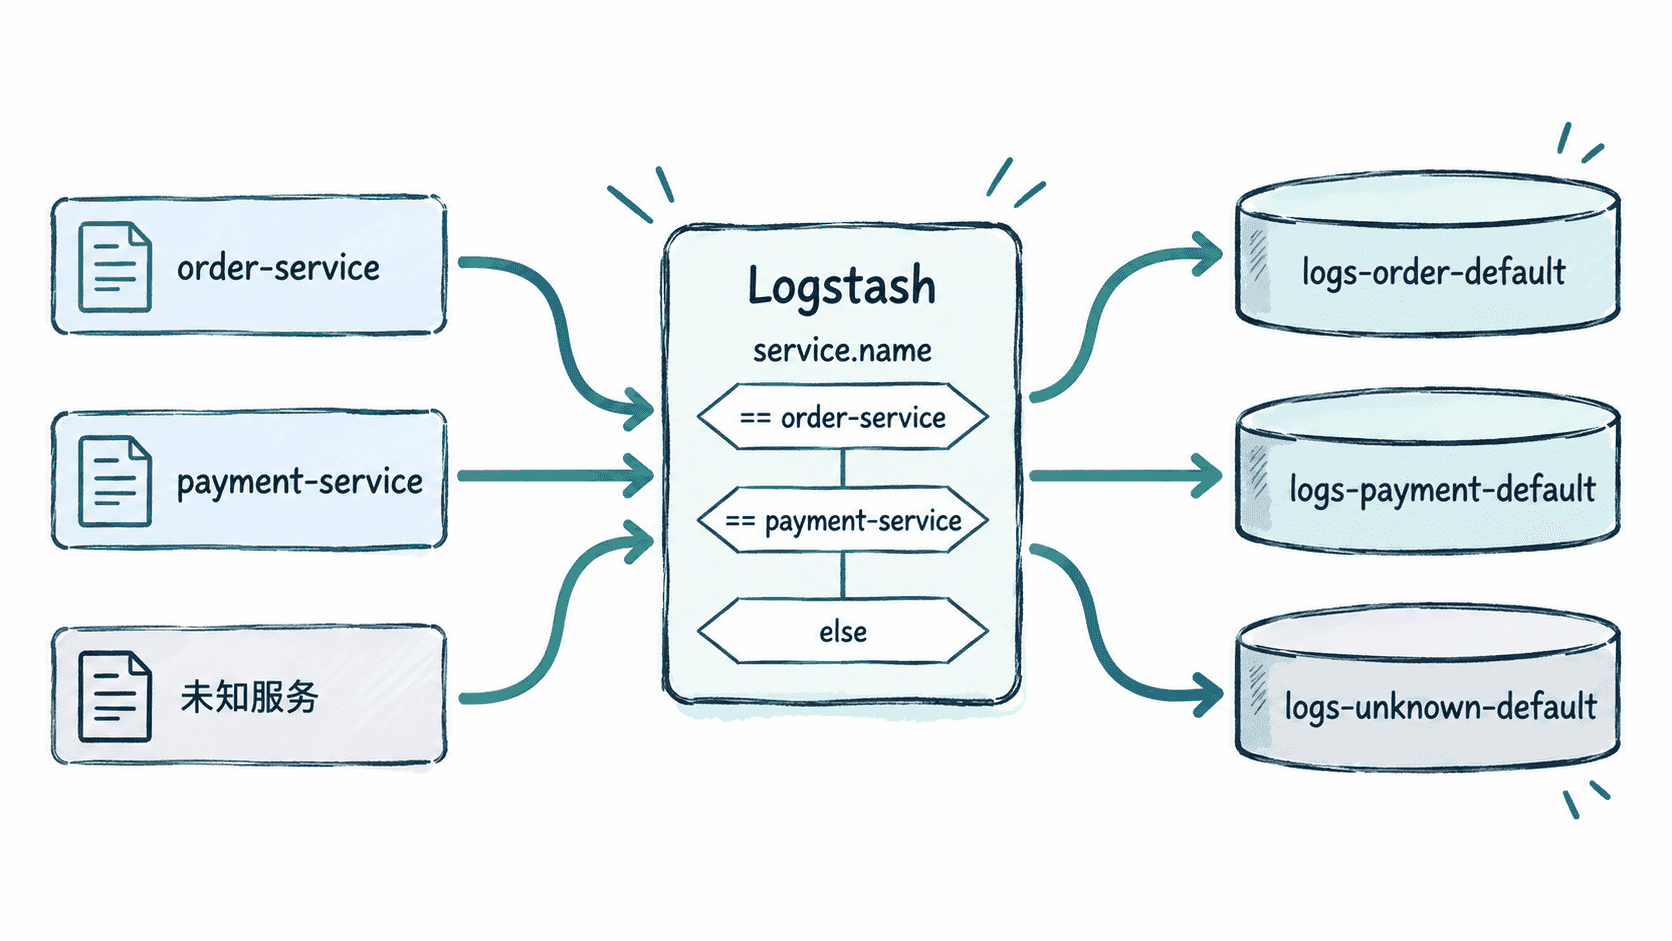
一个典型链路包含日志来源、Logstash 条件判断以及多个输出目标,事件只应进入与自身服务匹配的分支。
用条件判断生成路由字段
下面用标准输入模拟已经带有 service.name 的 JSON 日志。过滤阶段只负责决定目标名称,输出阶段统一引用这个结果,避免复制多份 Elasticsearch 输出配置。
input {
  stdin { codec => json }
}

filter {
  if [service][name] == "order-service" {
    mutate {
      add_field => { "[@metadata][target]" => "logs-order-default" }
    }
  } else if [service][name] == "payment-service" {
    mutate {
      add_field => { "[@metadata][target]" => "logs-payment-default" }
    }
  } else {
    mutate {
      add_field => { "[@metadata][target]" => "logs-unknown-default" }
      add_tag => ["unknown_service"]
    }
  }
}

output {
  stdout { codec => rubydebug }
}
@metadata 适合保存只供管道内部使用的路由信息,因为它不会作为普通业务字段随事件一起输出。这里先使用 stdout 验证判断逻辑,再接 Elasticsearch,能把“条件写错”和“目标写入失败”分开排查。
运行测试配置:
bin/logstash -f pipeline.conf预期 Logstash 启动并等待标准输入。随后输入一条 JSON 测试事件:
{"service":{"name":"order-service"},"message":"order created"}预期输出的关键内容如下,时间等动态字段可能不同:
"service" => {
  "name" => "order-service"
},
"message" => "order created"
由于 @metadata 默认不会随普通输出成为业务字段,测试重点是确认事件没有进入 unknown_service 分支。需要直接检查元数据时,可在调试阶段使用支持显示元数据的输出方式,生产配置则保持路由字段隐藏。
把路由结果接到 Elasticsearch
条件验证无误后,可以让 Elasticsearch 输出使用 @metadata 中的目标。以下为输出区片段示例,依赖已经配置好的 Elasticsearch 连接、安全凭据以及前面的路由逻辑。
output {
  elasticsearch {
    hosts => ["https://<HOST>:<PORT>"]
    data_stream => "true"
    data_stream_auto_routing => "false"
    data_stream_type => "logs"
    data_stream_dataset => "%{[@metadata][target]}"
    data_stream_namespace => "default"
  }
}
这里要注意数据流命名由 type、dataset、namespace 共同组成。为了避免把完整三段名称重复塞进 dataset,更清晰的做法是让 @metadata 只保存 dataset,例如 order、payment、unknown。
因此实际维护时建议把前面的目标值分别改为 order、payment 和 unknown,最终数据流名称会形成 logs-order-default、logs-payment-default、logs-unknown-default。验证方法是在 Elasticsearch 中检查对应数据流是否出现新事件,并核对服务字段是否匹配目标。
标签适合辅助,不要替代稳定字段
标签适合表达采集状态或处理结果,例如 unknown_service、parse_failed,也可以参与条件判断。但如果服务身份已经有 service.name 这样的结构化字段,就不必再维护一套同义标签,否则两者不一致时会产生难以解释的路由结果。
一定保留未知来源的出口
生产环境最危险的规则不是分错,而是没有匹配时直接没有输出。新增服务、字段缺失或采集端配置变化都可能让事件落出预期条件,因此最后的 else 应进入专门的兜底目标并附加异常标签。
验证分流时至少发送一个已知服务和一个未知服务事件,分别确认正常目标与兜底目标都有数据。这样新增服务时即使还没补路由规则,日志仍然可检索,也能通过 unknown_service 快速发现配置缺口。