
可观测性与稳定性 / 系统课时
Pipeline 堵塞怎么定位瓶颈
Pipeline 堵塞怎么定位瓶颈
Logstash 出现日志积压时,单看 CPU 或队列长度很难判断问题在哪。有效的排查需要沿着输入速率、Pipeline 工作线程、队列和输出端逐层缩小范围,并结合 Logstash Node Stats API 的累计指标判断事件究竟卡在处理阶段还是下游输出阶段。
学习目标
- 使用 Node Stats API 获取 Pipeline 的事件与流量指标
- 结合工作线程利用率、队列和输出延迟判断瓶颈位置
- 按输入、过滤、输出和下游系统的顺序验证修复效果
先理解事件为什么会积压
一条事件通常经过输入插件、内部队列、Pipeline Worker 执行过滤与输出,最后到达 Elasticsearch 等下游系统。任意环节消费速度长期低于上游产生速度,都可能形成背压。
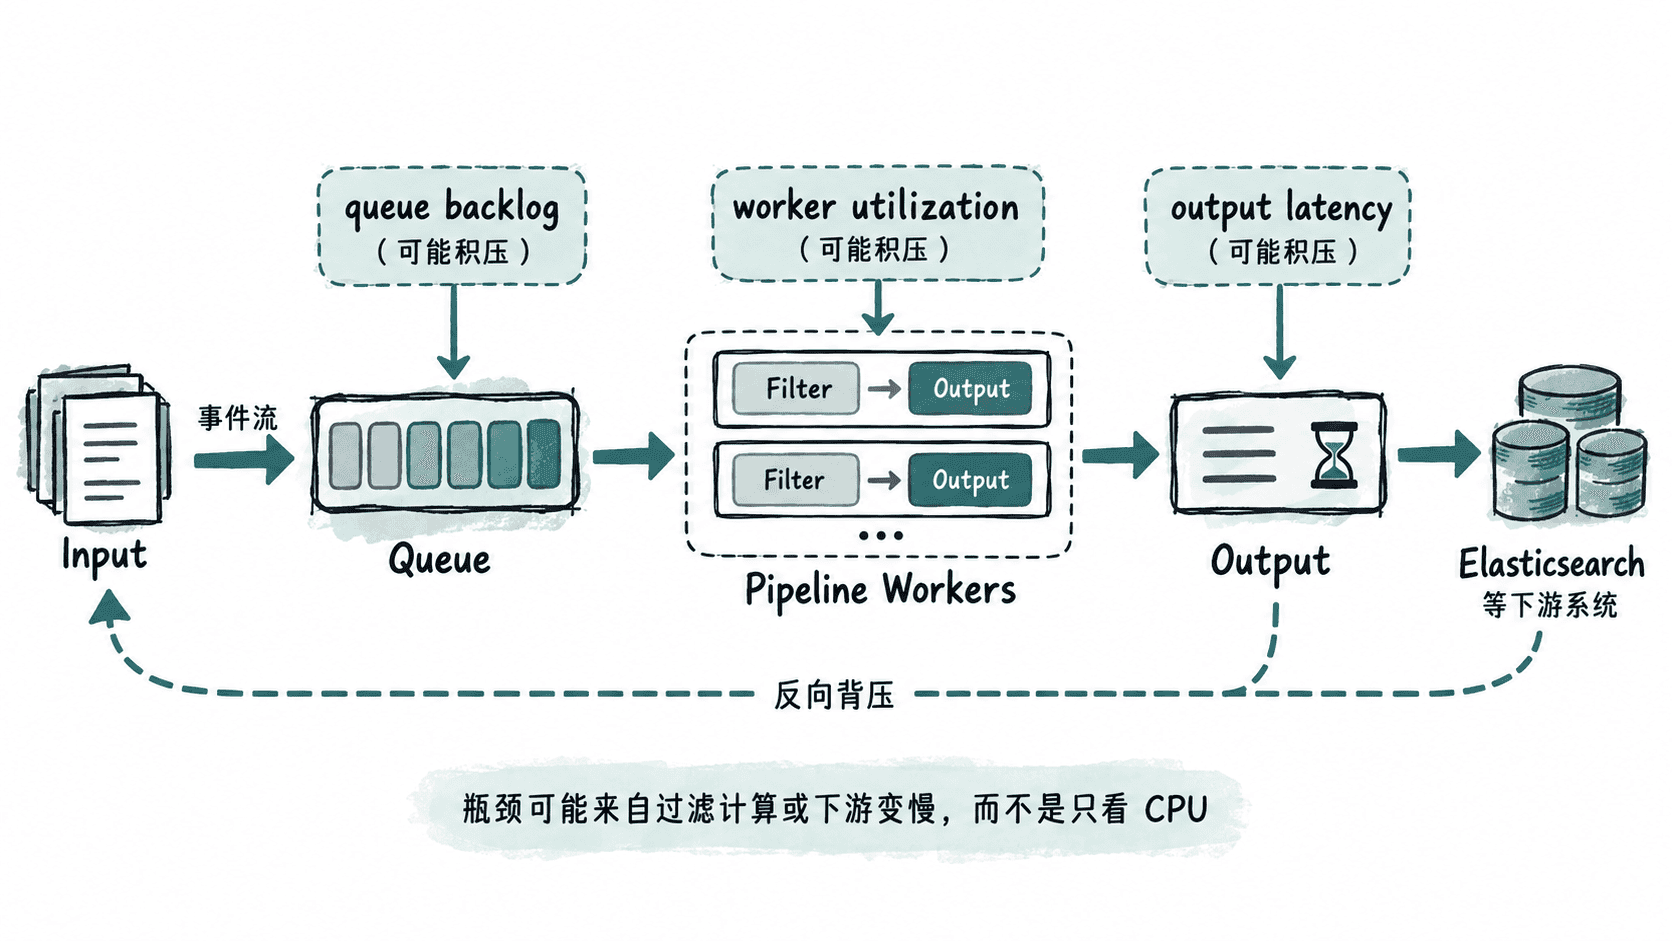
因此,“队列变长”只是结果,不是根因。排查时需要回答三个问题:事件进入和流出的速率是否失衡、Worker 是否已经忙满、输出端是否因为下游响应变慢而占用处理时间。
从 Node Stats API 取证
Logstash 默认 HTTP API 通常监听本机 9600 端口;如果实例修改过 API 设置,应使用实际地址和端口。先获取目标 Pipeline 的统计信息:
curl -s 'http://127.0.0.1:9600/_node/stats/pipelines?pretty'预期输出会包含各 Pipeline 的 events、flow、queue 等统计结构。下面仅展示用于定位的结构片段,具体数值、插件字段和可用流量指标会随版本、配置及运行状态变化。
{
  "pipelines": {
    "main": {
      "events": {
        "in": 120000,
        "filtered": 119800,
        "out": 119500
      },
      "flow": {
        "worker_utilization": {
          "current": 96.0
        }
      },
      "queue": {
        "type": "persisted"
      }
    }
  }
}
这些事件计数主要是累计值,不能把两次请求中的 events.in 或 events.out 直接当作每秒速率。需要在固定时间间隔取两次样本,用计数差除以时间差,或者优先查看当前 Logstash 版本提供的 flow 速率指标。
判断 Worker 还是输出端受限
worker_utilization 长时间接近饱和,说明 Worker 大部分时间都在处理事件,但还不能据此断定过滤器太慢。因为 Worker 执行过滤器和输出插件,慢速 Elasticsearch 输出同样可能占住 Worker。
继续查看插件级统计,可以把范围缩小到具体 Filter 或 Output:
curl -s 'http://127.0.0.1:9600/_node/stats/pipelines/main?pretty'预期结果中可以看到 plugins.filters 和 plugins.outputs 等结构,并包含插件处理事件及耗时相关统计;实际插件 ID 和数值取决于 Pipeline 配置。
{
  "pipelines": {
    "main": {
      "plugins": {
        "filters": [],
        "outputs": []
      }
    }
  }
}
如果某个 CPU 密集型过滤器对应的处理耗时明显增加,同时 Worker 持续饱和,应优先检查 Grok 表达式、Ruby Filter 或其他计算逻辑。若输出插件耗时上升,则继续检查 Elasticsearch 写入延迟、网络、批量请求失败与重试,而不是先盲目增加 pipeline.workers。
队列告诉你积压发生到了什么程度
使用持久化队列时,还应观察队列相关统计和磁盘空间。队列持续增长意味着进入速度长期高于处理速度;如果增长同时伴随输出延迟升高,通常应优先调查下游。如果 Worker 已饱和而输出端正常,则过滤计算或 Worker 配置更值得检查。
还要区分短时峰值和持续瓶颈。业务流量突然升高后队列增长,但峰值结束后能稳定回落,说明队列正在发挥缓冲作用;如果输入恢复正常后队列仍继续增长,才说明系统的持续处理能力不足。
用前后两次采样验证修复
修复后不要只看 Pipeline 是否还在运行。间隔一段时间再次获取统计数据,确认输出能够追上输入,同时观察 Worker 利用率、插件耗时和队列趋势。
curl -s 'http://127.0.0.1:9600/_node/stats/pipelines/main?pretty'
sleep 10
curl -s 'http://127.0.0.1:9600/_node/stats/pipelines/main?pretty'
预期结果是得到相隔约 10 秒的两份统计快照。实际计数无法预先固定,但修复有效时,应看到事件持续输出,并结合两次累计计数计算这段时间的输入与输出速率;已有积压时,输出速率还应在一段时间内高于输入速率,队列才会逐步回落。
定位 Pipeline 堵塞时,应把“积压”视为沿事件链路产生的结果:先确认输入和输出是否失衡,再观察 Worker 与队列,最后下钻到插件和下游系统。这样才能判断应该优化过滤规则、调整并发与批量参数,还是修复 Elasticsearch 等输出端,而不是通过重启 Logstash 暂时清空症状。