
可观测性与稳定性 / 系统课时
一条事件怎样穿过 Pipeline
一条事件怎样穿过 Pipeline
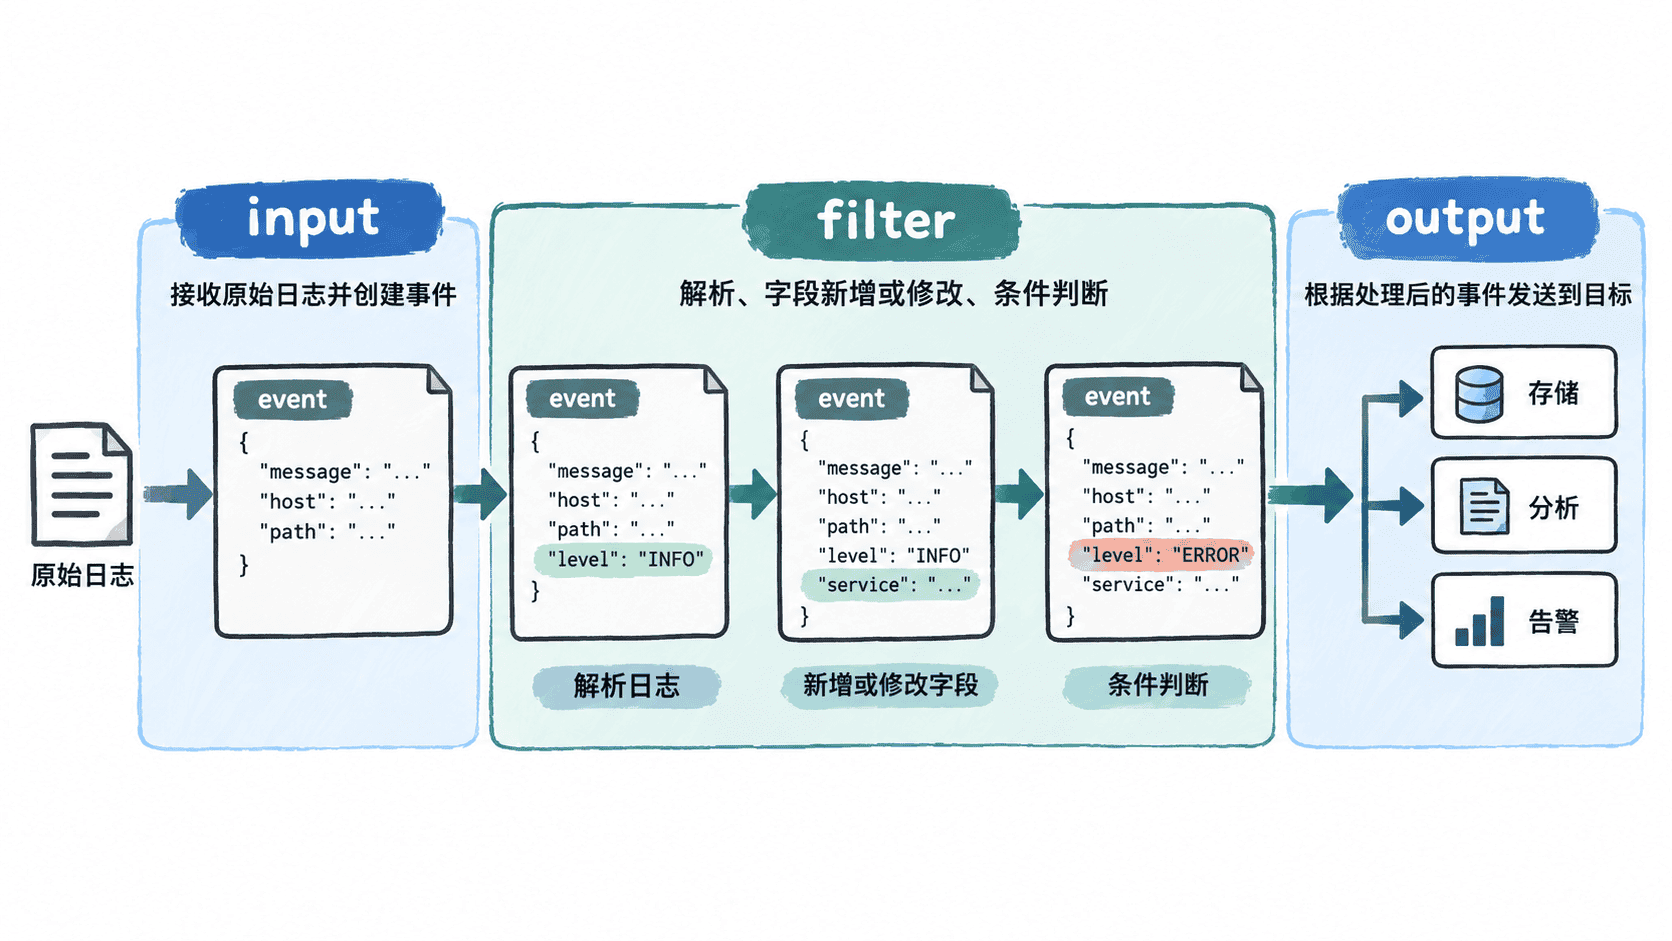
Logstash Pipeline 不是简单地把文本从入口搬到出口。一条输入数据会先成为事件,再依次经过 input、filter 和 output;filter 可以增加、修改或删除字段,条件判断还会决定最终去向。理解这条路径,是编写和排查 Pipeline 配置的基础。
学习目标
- 说明 input、filter、output 在事件处理中的职责
- 跟踪字段在 filter 阶段发生的变化
- 用最小 Pipeline 验证事件从输入到输出的完整过程
Pipeline 处理的是事件
input 负责从文件、网络、消息系统等来源接收数据,并把数据交给 Pipeline。进入 Logstash 后,处理对象是包含字段的事件,而不只是原始的一行字符串。
filter 位于中间处理阶段,可以解析文本、转换类型、增删字段或根据条件添加标签。output 接收已经处理过的事件,再把它发送到 Elasticsearch、文件或其他目标。没有 filter 时,事件也可以直接从 input 到 output。
跟踪一次字段变化
下面用 generator input 构造一条固定事件,避免依赖外部文件或服务。mutate filter 新增 environment 字段,并把 message 改为大写;最后用 stdout 输出 Ruby Debug 形式的事件。示例依赖 Logstash 已安装并可执行 bin/logstash。
input {
  generator {
    message => "payment accepted"
    count => 1
  }
}

filter {
  mutate {
    add_field => { "environment" => "test" }
    uppercase => ["message"]
  }
}

output {
  stdout {
    codec => rubydebug
  }
}
将配置保存为 <PATH>/pipeline.conf 后运行:
bin/logstash -f <PATH>/pipeline.conf预期输出的事件中应至少看到以下业务字段;Logstash 自动生成的时间戳等动态字段可能不同:
"message" => "PAYMENT ACCEPTED"
"environment" => "test"
这次执行可以按事件状态理解:input 创建包含 message 的事件;filter 在同一事件上增加 environment 并修改 message;output 读取处理后的结果。因此 Elasticsearch 最终接收到什么字段,取决于事件离开 filter 时是什么状态。
条件会改变事件的去向
Pipeline 的顺序是 input、filter、output,但这不意味着每条事件都会执行完全相同的处理。filter 和 output 中都可以使用条件表达式。例如可以根据 environment、日志级别或解析结果决定是否增加字段,以及发送到哪个输出目标。
这也是排障时容易混淆的地方:日志已经进入 input,不代表一定会抵达预期 output。事件可能在 filter 中被 drop,也可能因为字段值不符合 output 的条件而没有进入某个目标。
按事件路径定位问题
调试 Pipeline 时,按处理顺序检查通常比同时修改多个插件更可靠。先确认 input 是否产生事件,再观察 filter 后字段,最后检查 output 的目标、条件和连接状态。这样可以把“没有数据”逐步缩小为入口、转换或出口问题。
修改正式配置前还可以执行语法检查。以下命令只验证配置,不启动持续处理:
bin/logstash -t -f <PATH>/pipeline.conf预期输出包含配置验证成功信息,具体启动日志和耗时会随版本与环境变化:
Configuration OK理解 Pipeline 的关键不是把三个区块当作静态配置段,而是始终追踪同一条事件:它从哪里产生,经过 filter 后字段变成什么,以及哪些条件决定它最终进入哪个 output。