
可观测性与稳定性 / 系统课时
配置文件日志的采集路径
配置文件日志的采集路径
Filebeat 采集文件日志时,最先要保证输入类型、路径匹配和输出端配置正确。完成本节后,可以建立一个最小的 filestream 采集任务,让 Filebeat 持续发现指定日志文件并把事件发送到 Elasticsearch,同时知道如何在启动前验证配置。
学习目标
- 能使用
filestream配置明确的日志文件匹配路径 - 理解文件发现、读取状态与 Elasticsearch 输出之间的关系
- 能在正式启动前验证 Filebeat 配置语法
从文件到 Elasticsearch 的采集链路
Filebeat 不只是对文件执行一次读取。filestream 输入会发现符合路径规则的文件,持续读取新增内容,并借助持久化状态记录已经处理的位置;事件随后交给配置的输出端发送。重启后,状态信息使 Filebeat 能继续跟踪已处理文件,而不是简单地从头读取所有内容。
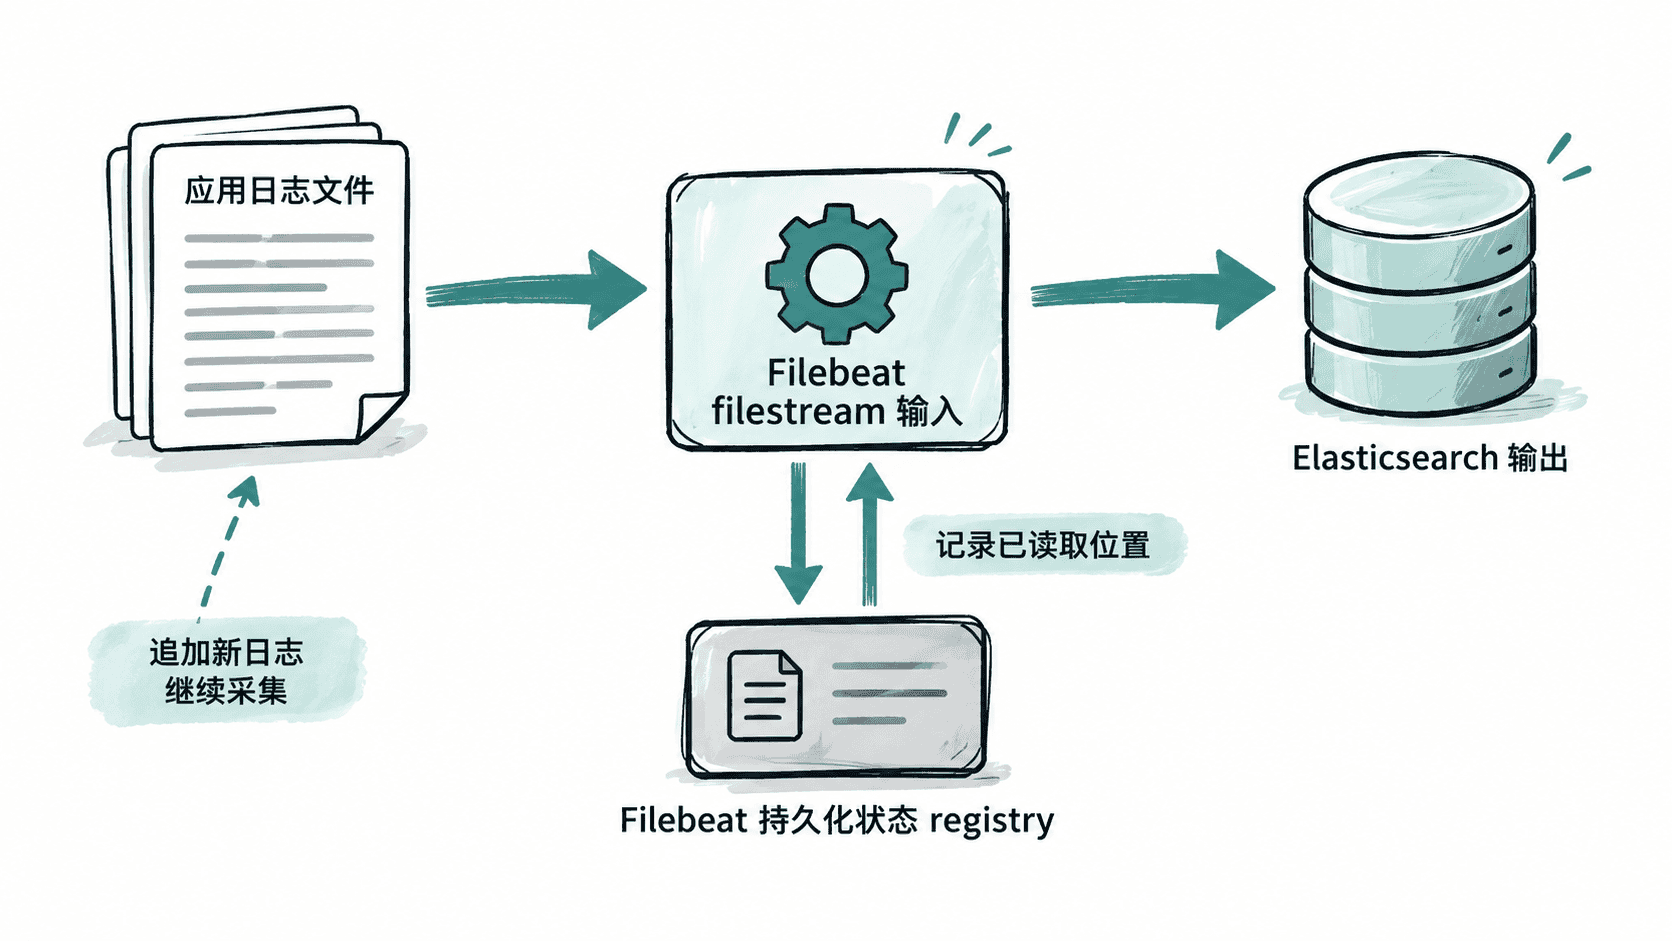
路径配置的关键是让匹配范围足够明确。范围太窄会漏文件,范围过宽则可能把归档文件、临时文件或其他应用日志一起采集。
建立最小 filestream 输入
下面是一份可以直接作为 filebeat.yml 核心内容使用的配置。示例假设应用日志位于 /var/log/myapp/,Elasticsearch 在本机 9200 端口提供无需认证的测试接口。
filebeat.inputs:
  - type: filestream
    id: myapp-log
    enabled: true
    paths:
      - /var/log/myapp/*.log

output.elasticsearch:
  hosts:
    - http://127.0.0.1:9200
id 应在同一 Filebeat 实例的 filestream 输入之间保持唯一。paths 支持通配符,这里的 *.log 会匹配目录下以 .log 结尾的文件,但不会自动表达“所有任意深度子目录”的含义。
配置文件属于声明式配置,不产生固定控制台输出。保存后可先执行配置检查;真正采集时还需要确保 Filebeat 进程对目标文件具有读取权限,并且 Elasticsearch 输出端可访问。
启动前验证配置
不要修改配置后直接把 Filebeat 丢到后台运行。先在 Filebeat 安装目录或已经正确配置命令搜索路径的环境中执行:
filebeat test config -e预期输出:
Config OK这一步主要验证配置能够被解析,并不证明日志路径一定存在,也不证明 Elasticsearch 网络连通。若命令提示 YAML 解析错误,应优先检查缩进、冒号和列表层级,而不是先排查 Elasticsearch。
还可以单独测试当前输出端是否能够连接:
filebeat test output预期结果是在连接正常时输出包含 Elasticsearch 连接成功信息的检查结果;主机地址、版本和耗时会因环境不同而变化:
elasticsearch: http://127.0.0.1:9200...
  talk to server... OK
如果集群启用了安全功能,应为 output.elasticsearch 配置与实际环境一致的 HTTPS、认证和 CA 信任设置,不能为了让测试通过而关闭生产集群的安全机制。
路径匹配正确还不等于能读取
出现“Filebeat 正常运行但没有日志”的情况时,先确认目标文件是否真的匹配 paths,再检查运行 Filebeat 的系统用户是否具有目录遍历权限和文件读取权限。容器化部署还要确认宿主机日志目录已经挂载到 Filebeat 容器,并且配置中的路径使用的是容器内路径。
用一条新日志做最终验收
配置检查和输出测试都通过后,再启动 Filebeat,并向匹配文件追加一条具有唯一标识的测试日志。例如:
printf '%s\n' 'anystack-filebeat-check-<ID>' >> /var/log/myapp/app.log预期结果:
命令本身正常情况下无控制台输出;Filebeat 应读取新增的 anystack-filebeat-check-<ID> 事件并发送到已配置输出端。随后应在 Elasticsearch 中按这个唯一标识检索事件。这样可以同时验证文件路径、读取权限、Filebeat 状态跟踪和输出链路,而不是仅凭进程处于运行状态判断采集已经成功。