
可观测性与稳定性 / 系统课时
用 Grok 拆出日志关键字段
用 Grok 拆出日志关键字段
应用仍在输出一整行文本日志时,Elasticsearch 很难直接按级别、接口或业务标识聚合。Grok 的价值是把稳定的文本结构映射成字段。本节用一条访问日志完成模式编写、Logstash 解析、失败标记与结果验证。
学习目标
- 理解 Grok 模式如何把非结构化文本转换为字段
- 能组合内置模式提取时间、级别和业务字段
- 能根据
_grokparsefailure定位不匹配的日志
从日志结构确定字段
假设应用输出如下日志:
2026-09-20T10:15:30 INFO order_id=ORD-1024 user_id=42 action=create_order目标不是把整行切成若干无意义片段,而是得到 log_time、log_level、order_id、user_id 和 action。Grok 的基本写法是 %{PATTERN:field}:前半部分引用已有模式,后半部分指定写入事件的字段名。
这里的时间可以使用 TIMESTAMP_ISO8601,日志级别可以使用 LOGLEVEL,数字用户 ID 可以使用 INT。订单号和动作值结构简单,可用 NOTSPACE 接收。
编写并运行 Grok 过滤器
下面给出一个可直接用于本地标准输入测试的 Logstash 配置。match 描述整行结构,user_id 后面的 :int 同时把匹配结果转换为整数,避免它以字符串进入后续索引。
input {
  stdin { }
}

filter {
  grok {
    match => {
      "message" => "%{TIMESTAMP_ISO8601:log_time} %{LOGLEVEL:log_level} order_id=%{NOTSPACE:order_id} user_id=%{INT:user_id:int} action=%{NOTSPACE:action}"
    }
  }
}

output {
  stdout { codec => rubydebug }
}
将配置保存为 <PATH>/grok-test.conf,再启动 Logstash。实际安装路径可能不同。
bin/logstash -f <PATH>/grok-test.conf启动完成后输入测试日志:
2026-09-20T10:15:30 INFO order_id=ORD-1024 user_id=42 action=create_order预期输出中应出现以下关键字段;Logstash 自动添加的 @timestamp、@version 等字段可能随运行环境而不同,因此这里只列出需要验证的解析结果。
"log_time" => "2026-09-20T10:15:30",
"log_level" => "INFO",
"order_id" => "ORD-1024",
"user_id" => 42,
"action" => "create_order"
理解匹配过程
Grok 会按照模式从左到右检查原始 message。固定文本负责约束日志结构,内置模式负责识别不同类型的值,命名字段最终进入 Logstash 事件。
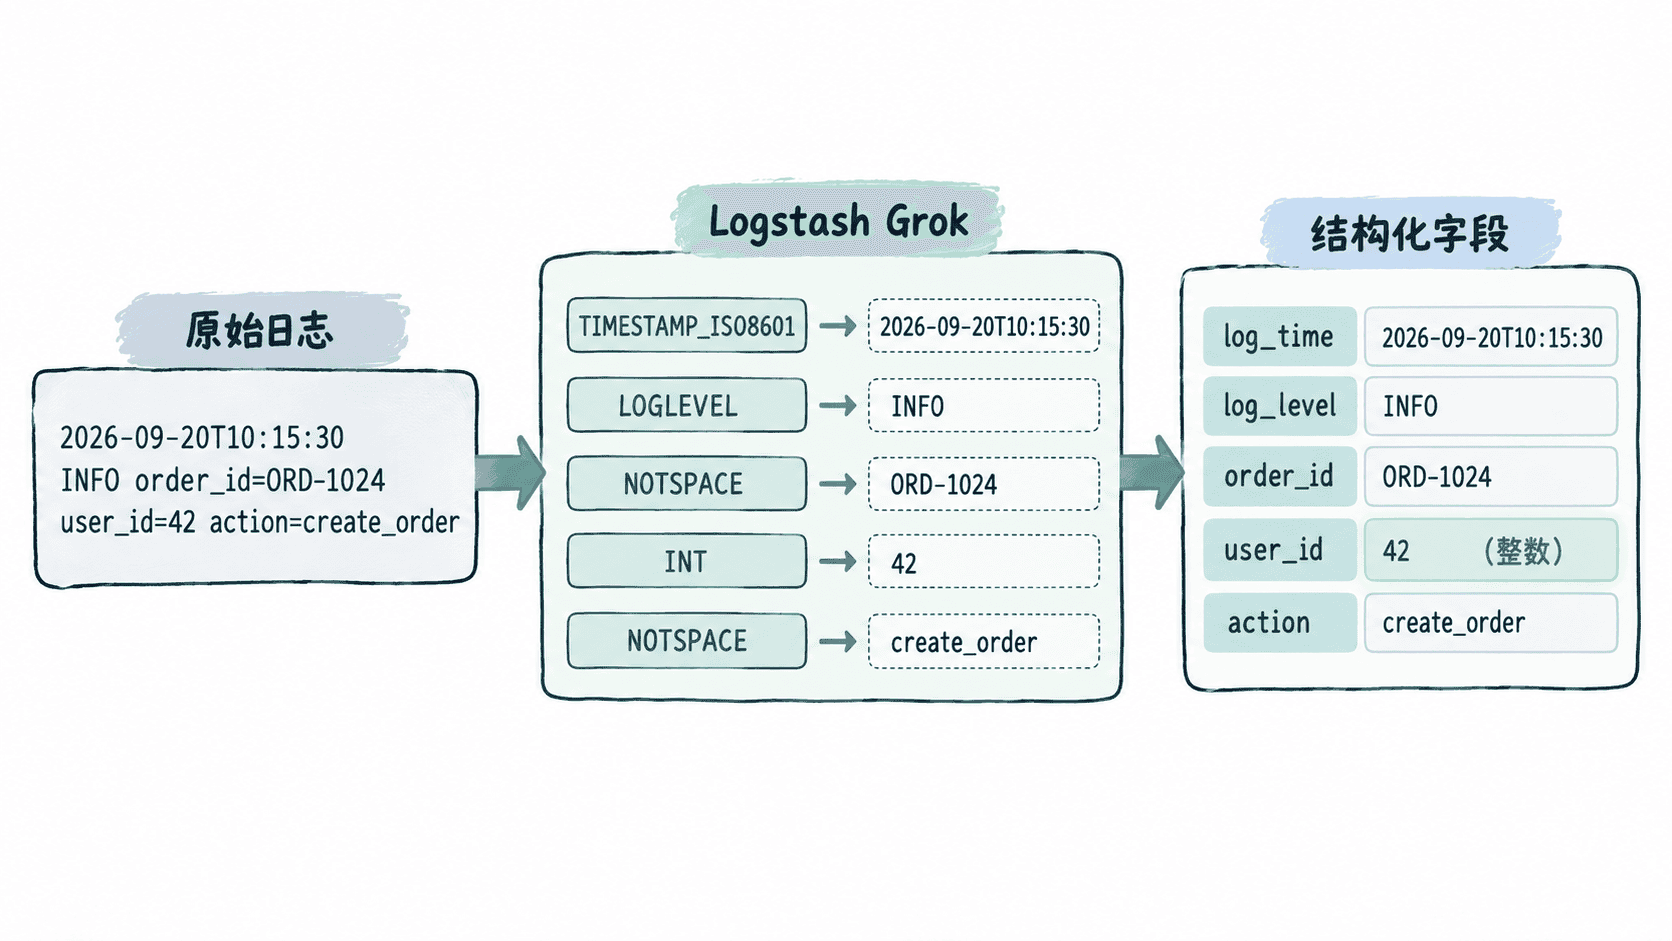
这种方式比单纯按空格切分更适合格式相对稳定但字段形态不同的文本日志,因为模式既表达分隔关系,也表达字段含义。不过 Grok 不是自动理解日志;任何固定字符、字段顺序或值格式发生变化,都可能让整条模式失配。
处理匹配失败
当日志不符合 match 模式时,Grok 默认给事件增加 _grokparsefailure 标签。例如把 user_id=42 改成 user_id=guest,而模式仍要求 INT,就会匹配失败。
排查时先保留原始 message,再比较失败样本与模式,不要一开始就删除源日志。常见原因包括时间格式变化、字段缺失、额外空格、日志版本并存,以及把数字模式用于实际可能出现文本的字段。
如果生产环境确实存在多种合法格式,可以在 match 中维护多个模式;如果格式已经由应用控制,更优先考虑直接输出 JSON 等结构化日志,减少持续维护复杂 Grok 表达式的成本。
验证进入 Elasticsearch 前的字段
调试阶段先使用 stdout { codec => rubydebug } 检查事件,而不是直接把错误结构写入 Elasticsearch。至少确认字段名称符合索引设计、数字字段已经转换类型,并且正常样本没有 _grokparsefailure。
Grok 模式应从真实日志样本出发,并优先匹配稳定结构。最终验收标准不是“正则能匹配”,而是不同代表性日志都能产生后续检索和聚合真正需要的字段。