
可观测性与稳定性 / 系统课时
日志延迟数分钟怎么找瓶颈
日志延迟数分钟怎么找瓶颈
日志比业务事件晚几分钟出现时,不要只盯着 Kibana 的时间轴。先比较事件在采集、处理、写入各阶段的时间,再结合队列积压判断延迟到底发生在哪里。这样可以把“日志慢”拆成可验证的链路问题。
学习目标
- 能用多个时间戳估算日志在各阶段停留的时间
- 能结合 Filebeat、Logstash 队列与 Elasticsearch 写入状态定位瓶颈
- 能区分采集延迟、处理延迟和存储可见延迟
先建立可比较的时间点
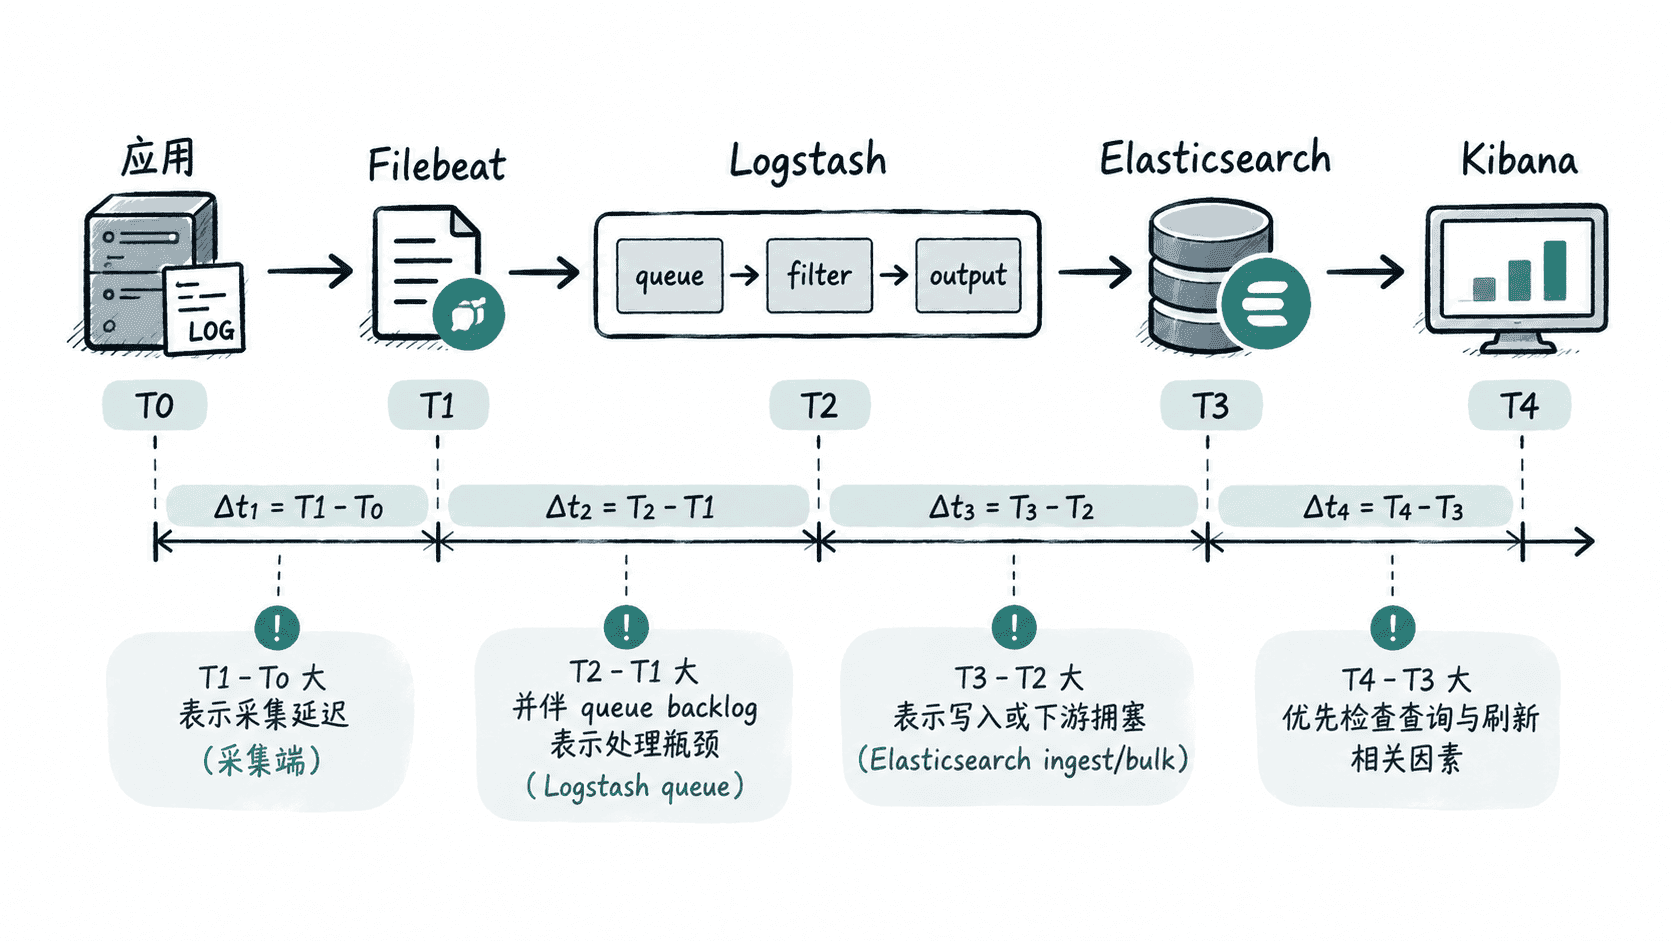
排查时至少记录四类时间:日志实际产生时间、采集端读取时间、处理完成或发送时间、Elasticsearch 中文档可查询时间。最重要的是保持同一条日志或同一个 trace/event ID,避免拿不同事件的时间直接比较。
先证明延迟发生在哪一段
可以用一个统一的事件 ID 做抽样。假设应用日志本身带有 event_id 与 @timestamp,采集和处理组件再补充各自的时间字段。不要一开始就同时改多个组件,否则很难知道哪项调整真正减少了延迟。
T0  application event timestamp   2026-09-20T10:00:00Z
a1  Filebeat observed timestamp   2026-09-20T10:00:02Z
T2  Logstash output timestamp      2026-09-20T10:00:07Z
T3  Elasticsearch query time       2026-09-20T10:03:05Z
预期结果
采集延迟  = T1 - T0 ≈ 2 秒
处理延迟  = T2 - T1 ≈ 5 秒
写入可见延迟 = T3 - T2 ≈ 178 秒
上面的时间只是诊断示例,真实环境应使用同一事件的实际字段。若大量样本都呈现最后一段异常变大,就不应继续把排查重点放在 Filebeat 的读取速度上。
检查采集端是否已经落后
采集端常见瓶颈包括文件读取跟不上、主机 I/O 紧张以及输出端阻塞。对于 Filebeat,应结合其运行指标和事件积压判断,而不是只看 Elasticsearch 当前索引中的最新时间。
curl -sS "http://<HOST>:5066/stats?pretty" | jq '{events,libbeat,output,beat_info}'预期结果
{
  "events": {
    "active": 0,
    "published": 1200,
    "acked": 1198
  }
}
若采集端读取速率下降、未确认事件持续增加,同时后续 Logstash 没有明显积压,可以优先检查采集主机磁盘、文件读取位置和输出连接。
检查 Logstash 是否形成队列瓶颈
当输入速度明显高于过滤或输出速度时,Logstash 会出现队列积压。此时最有价值的证据是事件流量、队列增长和输出侧延迟是否同时变化。
curl -sS "http://<HOST>:9600/_node/stats/pipelines?pretty" | jq '.pipelines | to_entries[] | {pipeline:.key,events:.value.events,queue_backpressure:.value.queue_backpressure,flow:.value.flow}'预期结果
{
  "pipeline": "main",
  "events": {
    "in": 50000,
    "filtered": 49800,
    "out": 42000
  },
  "queue_backpressure": 0.18
}
示例中 in 明显高于 out,而且存在队列背压,说明处理或输出阶段正在积压。下一步应区分过滤计算慢,还是 Elasticsearch 输出慢;不要单纯增加输入并发,否则可能把压力继续推向下游。
最后检查 Elasticsearch 写入与可见性
如果前两段都正常,而日志仍然晚数分钟出现,应检查 Elasticsearch 的写入吞吐、请求失败、线程池或下游资源压力。重点是验证文档究竟何时写入,而不是只观察 Kibana 当前查询结果。
curl -sS "http://<HOST>:9200/_cat/thread_pool/write?v"
curl -sS "http://<HOST>:9200/_cat/indices?v&h=index,docs.count,store.size,health,status"
预期结果
name shard_index queue active rejected
write 0           0     2      0

health status index     docs.count store.size
yellow open   app-logs  12000000   18gb
若写线程池长期排队或被拒绝,请结合集群 CPU、磁盘 I/O、分片数量和批量写入压力继续定位。若 Elasticsearch 已经及时写入,而 Kibana 查询仍显示旧数据,则应把排查范围转向查询窗口、时间字段和可见性相关因素。
因此,日志延迟排查应始终按时间差和队列状态逐层收敛:先证明采集有没有落后,再判断处理链是否积压,最后验证 Elasticsearch 写入与查询可见性。找到最大的一段时间差后,才针对该阶段调整配置或容量,避免无证据地同时修改整条链路。